基于 VLM 智能体的上下文机器人学习
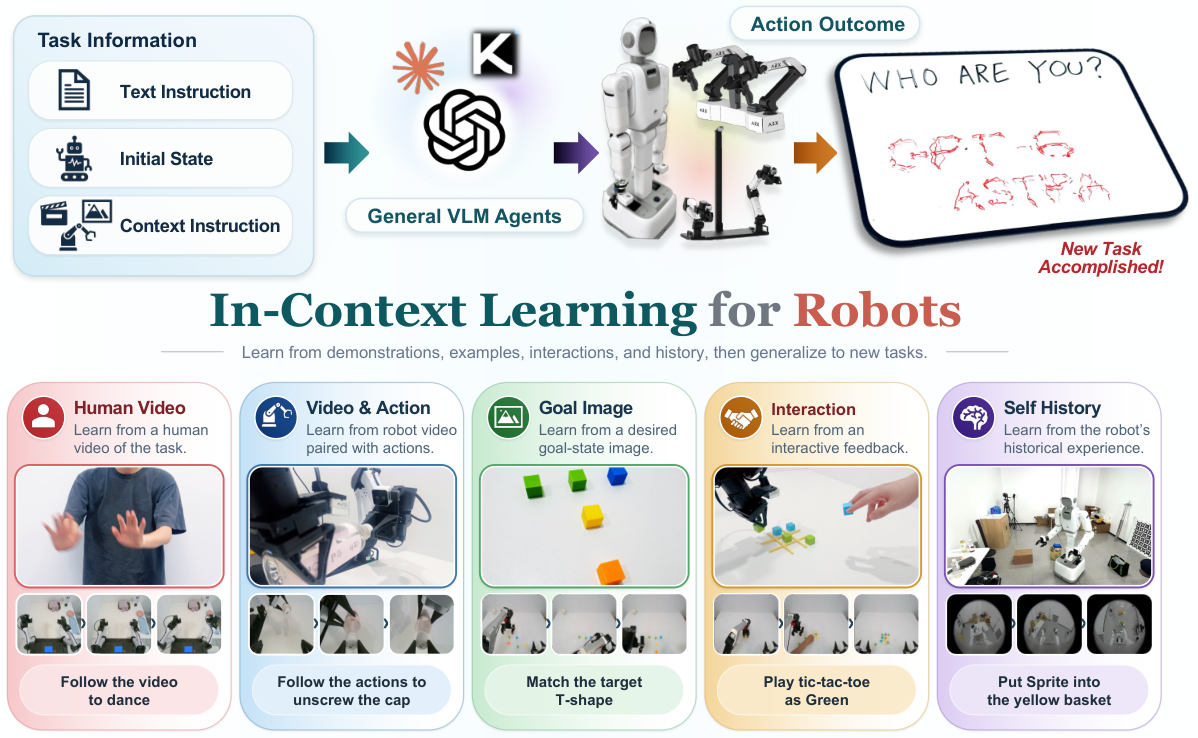
让机器人像人类一样快速适应陌生环境,是具身智能的长期目标。有限的演示无法覆盖机器人可能遇到的所有任务与情境,因此 在部署时从上下文中学习 对泛化至关重要,但现有机器人策略仍难以具备这种 上下文学习 (ICL) 能力。商业 视觉语言模型 (VLM) 如 GPT-6 Astra 的通用智能体能力引出一个关键问题:它们能否从演示、示例与交互反馈中学习,并在无需梯度更新或持久修改任务特定参数的前提下,将信息转化为可从新初始状态执行且可验证的机器人行为? 为此,作者提出 GPT-Policy,一个面向 上下文机器人学习 的通用智能体框架,由三部分组成: 1. 上下文编译器 (context compiler):保留任务相关的视觉状态转移; 2. VLM:提出机器人工具动作; 3. 约束控制器:验证并执行每个动作,并回报执行结果。 实验通过任务成功率与效率指标、跨模型的匹配比较以及受控的上下文消融,评估其可靠性与局限。在真实机器人试验中,即使没有机器人动作标签,人类视频演示 也能提升任务完成度;而在接触敏感任务上,对齐的动作参考还能带来进一步提升。这些发现使 GPT-Policy 成为迈向通过上下文学习实现机器人自适应的一步,为把 VLM 的通用能力转化为物理行为提供了实证基础,也明确了可靠部署仍需克服的挑战。
论文精读
TL;DR GPT-Policy 将商用 VLM 智能体的上下文学习能力引入机器人控制,通过 context compiler 与约束控制器,无需微调即可从人类视频等参考生成可执行动作,验证了 in-context robot learning 的可行性。
问题
问题背景
具身智能的核心目标之一是让机器人在陌生环境中像人类一样快速适应。当前领域重点关注部署后的上下文学习 (In-Context Learning, ICL),即在无梯度更新、不改动任务特定参数的前提下,从少量演示、示例或交互反馈中提取可执行行为。
现有方法局限
传统机器人策略依赖大规模示范数据,但有限的数据集合无法覆盖所有任务和环境组合。早期 ICL 尝试多停留在感知或规划文本层面,缺少可验证的动作执行闭环——VLM 输出的高层指令往往无法直接转化为满足运动学约束、碰撞安全和实时性要求的底层控制信号。同时,现有 VLM agent 缺乏结构化的工具接口与反馈机制,导致可靠性不足,难以部署在接触敏感任务上。
为什么难/重要
难度来自具身鸿沟:视觉语言推理与物理动作执行之间存在语义-几何错位。上下文信息需要同时编码视觉转移、动作参考和在线历史,并保持跨初始状态泛化。此外,闭环执行要求每个动作经过约束控制器验证,失败时要能报告结果并调整,这对模型鲁棒性和系统集成提出很高要求。业界高度关注此方向,因为部署后自适应可大幅减少数据采集和策略微调成本,是通用机器人规模化落地的关键瓶颈之一。
行业类比
类似大语言模型通过上下文学习在文本任务上实现少样本适应,机器人领域需要将这种能力延伸到物理操作——如同自动驾驶系统根据实时场景记忆快速调整驾驶策略,而非依赖预设地图和规则库。
核心洞察
- 将商用 VLM 作为通用代理与约束控制器解耦,实现无需梯度更新的机器人上下文学习。该工作不同于将 VLM 直接作为策略网络输出低级动作(如 RT-2、PaLM-E),而是通过上下文编译器保留任务相关视觉转换,由 VLM 提出高层工具动作,再由约束控制器验证并执行,同时将执行结果反馈回 VLM 形成闭环。这种架构使 VLM 专注于语义推理与跨模态理解,能够从人类视频、目标图像等异构上下文中提取任务要求,无需针对每个任务微调模型参数,展示了零样本上下文适应的潜力,为通用机器人策略提供了一种轻量集成路径。
- 人类视频演示(无机器人动作标签)即可提升任务完成度,验证了 VLM 跨 embodiment 的语义迁移能力。传统模仿学习依赖机器人大规模专家演示与动作对齐,数据采集成本高且难以泛化。该研究发现,仅提供人类视频作为上下文即可显著改善非接触敏感任务的成功率,而接触敏感任务则在增加动作参考后进一步获益,说明高层任务语义和底层动作执行可以分层建模。这为利用海量人类视频数据增强机器人学习提供了实证依据,有望大幅降低数据门槛,并为后续结合少量机器人校准数据实现高效适应指明方向。
方法
输入与上下文构建
GPT-Policy 接收多模态任务参考,包括 人类视频演示(无动作标签)、机器人视频与动作序列、目标图像 以及在线交互历史。Context Compiler 对这些异构数据进行关键帧提取、状态-动作对齐与视觉转换保留,生成紧凑的上下文表示,输入 VLM。
VLM 动作提案与约束执行
以商业 VLM(如 GPT-6 Astra)作为策略推理器,通过结构化工具接口输出机器人工具动作(如末端位姿、夹爪指令),无需梯度更新或任务特定参数调整。Constrained Controller 对每个动作进行逆运动学求解、可达性与碰撞检查,通过插值生成关节轨迹并执行,然后收集执行结果(视觉变化、任务完成信号)作为反馈。
闭环交互与上下文更新
执行反馈被追加到在线交互历史,更新后的上下文再次输入 VLM,形成闭环。该流程支持从新初始状态开始,利用上下文学习完成泛化任务。
与端到端模仿学习或微调方法不同,GPT-Policy 完全复用预训练 VLM 的上下文学习能力,通过编译器和控制器将语言模型输出可靠映射为物理动作,无需特定任务训练。
实验
实验设计
论文在真实机器人平台上评估 GPT-Policy 的上下文学习能力,覆盖四种任务参考来源:人类视频、机器人视频与动作、目标图像、以及机器人自我交互历史;并额外测试在线人类交互反馈。实验通过任务成功率与效率指标衡量性能,并进行跨模型对比和上下文组件消融。
关键发现
- 人类视频演示即使不包含机器人动作标签,也能提升任务完成率,说明 VLM 可以从观察中提取可执行策略。
- 当提供对齐的机器人动作参考时,在接触敏感任务上取得进一步增益,表明动作级别的对齐对精细操作至关重要。
- 消融实验显示上下文中的视觉转换信息和结构化动作接口是性能的关键因素。
与基线对比
与依赖有限演示集或需要梯度更新的传统机器人策略相比,GPT-Policy 展示了无需参数更新的部署时适应。然而论文也指出其可靠性仍存在局限,说明将 VLM 通用能力转化为物理行为仍需解决验证与安全执行等挑战。
行业影响
落地场景
GPT-Policy 框架将商用 VLM 的上下文学习能力引入机器人控制,适用于需要快速适应新任务、新物体、新环境的场景。典型包括:
- 电商仓储拣选:SKU 频繁更新,用人类视频示范即可让机械臂学习抓取新物体,无需重新训练策略。
- 服务机器人:在家庭或酒店环境中,通过用户演示或在线反馈调整操作(如整理物品)。
- 柔性制造:小批量多品种生产线,工人演示一次新装配动作,机器人即可模仿执行。
商业价值
- 降低数据成本:无需大规模演示数据集和梯度更新,仅靠少量上下文示例即可泛化,减少数据采集和标注费用。
- 缩短部署周期:从新任务定义到上线执行,可由分钟级完成,提升自动化方案交付速度。
- 增强鲁棒性:底层约束控制器验证每步动作,减少 VLM 幻觉导致的危险操作,提高安全性,使 VLM 驱动的机器人更接近商用。
与现有产品/工作流的接口
GPT-Policy 可作为高层决策模块插入现有机器人栈:
- 通过 ROS 或机器人中间件接收传感器数据与任务描述。
- 调用商用 VLM API(如 GPT-6 Astra)生成工具调用请求(
tool requests),不修改模型参数。 - 下游 逆运动学求解 与 约束控制器 负责执行与验证,并将结果反馈给 VLM,形成闭环。 无需替换现有运动规划或安全层,只需增加一个“上下文编译器”模块,将视觉观测和交互历史转为 prompt。
具体落地 use case
- 电商订单履行中心:拣选机器人学习处理新上架商品。仓库人员拍摄一段拿起商品的短视频,GPT-Policy 将其作为上下文,机器人即可在新料箱中识别并抓取该商品,减少传统视觉方案中每类 SKU 的建模时间。
- 医疗康复辅助:治疗师演示一套上肢训练动作,机器人根据患者初始姿态调整轨迹,并通过在线反馈(如患者动作偏差)实时修正,提升个性化康复效果。
局限
- **对商用 VLM 的强依赖与黑盒性**:GPT-Policy 基于 GPT-6 Astra 等闭源模型,无法微调或检查内部表征,导致动作提议的失败模式难诊断。部署方受限于 API 可用性、速率限制、版本漂移和推理延迟,长期稳定性存疑;且上下文长度限制可能制约多任务演示与长时交互历史的堆叠,论文未给出扩展性评估。
- **跨 embodiment 对齐仍需显式动作参考**:从人类视频演示得到的提升主要来自高层任务理解,接触敏感任务需要 robot action labels 或对齐动作参考才能显著提高成功率。说明视觉语言模型的语义理解与机器人轨迹执行之间存在 gap,当前的 context compiler 和 constrained controller 只能缓解而非消除该 gap,对力控/精细操作任务泛化有限。
- **实验范围较窄,缺少规模化评测**:真实机器人试验集中在少量桌面操作任务(如拾放 / 推 / 开盖等),未覆盖移动操作、多步接触密集或动态环境。评估指标主要为任务成功率和效率,未深入分析失败模态、执行时间波动或安全性边界;与同类方法(如 RT 系列、Octo 等端到端策略)在相同基准上的直接对比不足,结论的泛化性有待验证。