当许多答案都有效时,投票失败:LLMs 中 Best-of-K 因果推理的符号验证
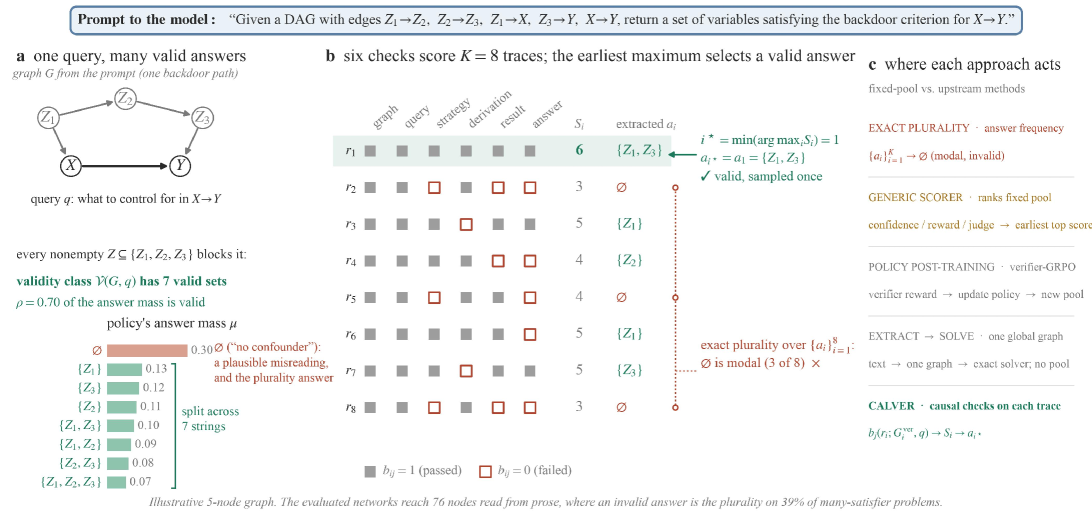
自一致性 假设采样推理轨迹中出现频率最高的答案最可靠,但在因果推理中可能失效:样本常重复相同的混杂错误,且投票在多个有效答案间分散,导致无效答案胜出,尽管存在有效的少数轨迹。本文提出 CALVER(Causal Axiom-Level VERification),一种免训练的符号验证器,根据 Pearl 因果准则(包括 d-分离、后门调整和干预)对结构化轨迹打分,并选择得分最高的候选,无需参考答案。 在 CLEAR 的 find-one-valid 查询(允许多个图有效答案)上,CALVER 达到 42.1%,而多数投票、奖励模型、LLM 裁判和模型置信度在相同冻结池上均接近 30%。将裁判扩展到 72B 模型仍无法弥合差距。在经审计的 clean-core 子集中,21 个图有效的 CALVER 选择中有 11 个与基准列出的答案不同,但仍然满足所请求的谓词。 优势随采样预算增加而扩大,并在十个已发布的贝叶斯网络、第二个模型系列以及要求模型从文本构建图表的设置中复现。CALVER 还改进了针对精确ground truth的阈值化平均处理效应决策,在真值表检查器下可推广到逻辑问题,并在 CPU 上以毫秒级速度评估每个候选。 CALVER 仅需因果关系结构(直接给定或从文本构建);只要具备该结构,选择即可通过因果有效性进行聚合。
论文精读
TL;DR CALVER 通过符号验证基于 Pearl 因果公理评分推理轨迹,解决 self-consistency 在多有效答案下失效的问题,显著提升 LLM 因果推理的 Best-of-K 选择准确率,且无需训练、开销极低。
问题
问题背景
大语言模型(LLM)的因果推理能力是当前 AI 可靠性的前沿议题。链式思维(Chain-of-Thought, CoT)提示显著提升了模型在复杂推理任务上的表现,而基于采样和投票的自一致性(self-consistency)策略则通过聚合多条推理路径的最终答案,成为推理时扩展(inference-time scaling)的主流选择。
现有方法的局限
自一致性的核心假设是“出现频率最高的答案即为最可信答案”。但在因果推理场景中,这一假设经常失效:
- 错误集中:模型样本会系统性地重复同一种混杂偏差(confounding bias),导致错误答案反而获得最多投票。
- 有效答案碎片化:当问题允许多个图结构上均有效的答案(例如“找出任意一个满足条件的节点”)时,正确但不同的候选答案会分散票数,而单一的无效答案可能凭借微弱多数胜出。
- 黑盒评判的不足:奖励模型(reward model)或 LLM 评委(judge)虽能提供更灵活的评分,但它们在因果推理上也仅停留于表面模式,无法深入核查
d-分离、后门调整等因果准则,其性能与投票基线相比并无实质提升,即使将评委模型扩展至 72B 参数规模,差距依然存在。
挑战与重要性
因果推理的验证需要结构化的形式化检查:是否控制了正确的混杂集?干预公式的展开是否符合因果图?LLM 生成的推理链往往包含隐性的因果谬误,而纯基于统计的投票或神经评分难以捕捉这些逻辑断层。在医疗、政策评估等攸关决策中,一个看似“多数正确”的因果推断可能带来严重误导。因此,如何在不依赖参考答案的前提下,从多个采样结果中可靠地选出真正因果有效的推理链,成为提升 LLM 可信度的关键瓶颈。
行业类比
这一挑战类似于自动化代码生成中的“多解验证”:对于同一编程问题,不同实现均可能正确,但若仅通过运行结果投票,可能会因多数解偶然通过测试而忽略了少数更高效、更安全的算法——必须引入形式化证明或符号执行来确保逻辑正确性。
核心洞察
- **因果推理中的多数投票陷阱** —— self-consistency 等投票方法假设多数答案一致即正确,但因果问题常允许多个有效答案,采样中 vote 碎片化,使无效答案因重复错误而胜出。CALVER 揭示,在“找一有效解”(find-one-valid)场景,投票从根本上失效,转而用因果公理评分每个 trace,为多态推理测试时选择提供新范式。
- **符号因果验证器** —— CALVER 将 Pearl 的结构因果准则(d-分离、后门调整、干预)编译为可执行的验证程序,对 LLM 生成的结构化推理链评分,无需训练或参考答案,纯 CPU 毫秒级运行。相比 LLM judge 和奖励模型(即使 72B 也无法缩小差距),CALVER 利用因果理论实现白盒、可解释的选择,且不需要大模型推理,极具工程友好性。
- **超越基准答案的答案质量** —— 在 clean-core 审计子集中,CALVER 选择的 11/21 个答案与基准标注不同,但均满足查询谓词,表明它基于结构有效性而非表面标签,能发现基准未覆盖的正确解。这为评估生成式因果推理提供了不依赖人工标注的新视角。
方法
CALVER (Causal Axiom-Level VERification) 是一种训练无关的符号验证器,专门用于从 LLM 采样的一组因果推理痕迹中选出最符合因果公理的一个。其流程按 输入 → 关键模块 → 输出 展开。
输入:
- 一个自然语言描述的因果查询(例如 find-one-valid 类问题);
- LLM 对同一查询生成的 $K$ 条候选推理痕迹(CoT 采样),每条痕迹包含推理步骤和最终答案;
- 因果结构(有向无环图 DAG),可直接由用户提供,也可从文本中由 LLM 构建。
关键模块:
- 结构化痕迹解析:将每条自由文本推理转化为结构化形式,提取其中的因果操作序列,如条件独立性判断、后门调整公式、干预声明等。
- 符号因果公理验证器:基于 Pearl 因果框架中的核心准则——d-分离(检查条件独立性的图论正确性)、后门调整(验证用于控制混杂的变量集是否满足后门准则)、干预(检查 do-演算或路径阻断的合理性)——逐项检验结构化痕迹中的每个因果主张,无需参考答案。
- 评分与选择:对每条痕迹按公理满足程度累加得分(每个正确断言加分,违反公理则扣分或不得分),最终选择得分最高的痕迹作为输出答案。评分完全在 CPU 上以毫秒级完成。
输出:一条最优推理痕迹及其最终答案,该答案在因果逻辑上自洽,而非由投票频率决定。
与同类方法的差异:CALVER 不依赖采样多数的一致性假设,而是直接验证因果正确性,因此能克服自我一致性在面对多有效答案或常见混淆错误时投票失败的缺陷,且相比基于 LLM 的评判或奖励模型,具备可解释、廉价且不随模型规模变化的优势。
实验
实验设计
CALVER 在CLEAR 因果推理基准的 find-one-valid 查询上进行评估, 这类查询允许多个图结构上有效的答案。 实验冻结同一批采样池, 对比 plurality (自一致性多数投票)、Reward Model、LLM Judge 及 模型置信度 等选择策略。 还引入审计后的 clean-core 子集, 人工验证图有效性; 并在十个已发布的贝叶斯网络、第二个模型家族及文本到图的构建场景中进行迁移测试。 额外增设阈值化平均处理效应 (ATE) 决策与逻辑真值表检查的泛化实验。
关键发现
- CALVER 达到 42.1% 的准确率, 显著超越 frozen pool 上的所有基线 (均接近 30%)。
- 将 LLM Judge 扩展至 72B 参数仍无法弥合差距, 说明奖励/判断模型难以内化因果公理。
- 在 clean-core 审计中, 11/21 个 CALVER 选择与基准答案不同, 但仍满足因果谓词, 揭示基准标签本身存在未穷尽的图有效答案。
- 优势随采样预算
K增大而扩大, 表明符号验证能更好地利用计算投入。 - 方法在跨网络、跨模型及文本到图设置下稳定复现。
与基线的深度对比
Plurality 在因果推理中双重失效: 错误重复出现 (混淆偏差) 且有效答案因票数分散而落选。 CALVER 不依赖答案频率, 而是针对每个候选的结构化推理轨迹, 用 d-分离、后门调整、干预等 Pearl 因果准则逐条评分, 从而在多个有效答案并存时精准锁定最高因果效度者。 这解释了为何即使增大采样预算, 投票方法仍停滞在 ~30%, 而 CALVER 持续获益。 训练自由的符号验证器 以毫秒级 CPU 开销实现了对因果语义的强对齐, 其选择策略在工程上可即插即用, 仅需因果结构 (直接给定或从文本构建)。
行业影响
落地场景
CALVER 针对的是 LLM 在因果推理任务中“多个答案都可能成立”时的选择难题,典型场景包括:
- 金融风控:评估某项政策(如调整利率)对违约率的因果效应。LLM 可能生成多种调整策略,仅有符合后门准则的才正确,投票极易选出错误方案。
- 医疗决策支持:从症状推断疾病因果关系时,虚假关联普遍存在。CALVER 能筛选出满足干预与 d-分离准则的推理链,避免混淆偏倚。
- 推荐系统与广告归因:分析特征对转化的真实作用,而非仅相关性,提升增量建模可靠性。
- 政策模拟与社会科学:基于文本构建因果图后,从 LLM 采样的解释中选择因果有效的结论。
商业价值
- 降低错误决策风险:金融、医疗等领域因果推理错误代价极高。CALVER 将不可靠的投票选择(准确率约 30%)提升至 42.1%,且随着采样预算增加优势更大,直接减少误判。
- 轻量集成,降本增效:验证器仅在 CPU 上毫秒级完成评分,无需额外训练或调用大模型裁判,相比需 72B 模型的 LLM judge 成本极低,且效果更优。
- 可审计的推理过程:通过符号公理验证,每个选择均可追溯至因果准则,满足企业合规与模型审计需求,提升用户信任。
与现有产品/工作流的接口
- 作为 LLM 推理后置选择器:在已有 CoT 采样 + 多数投票的管道中,替换投票步骤为 CALVER 评分排序,极少侵入性。只需额外提供因果图结构(从文本中构建或使用领域知识库)。
- 与知识图谱/特征平台联动:企业已有的因果图或关系型知识图谱可直接作为验证的结构输入,无需重建。
- 兼容主流推理框架:可与 vLLM、LangChain 等集成,将验证模块插入
Best-of-N选择逻辑;返回最高分推理链的同时可输出验证报告供人工复核。
具体落地用例:
- 医疗问诊助手:患者描述症状,LLM 产生多个诊断推理链,CALVER 根据医学领域因果图过滤出符合干预逻辑的链条,避免混淆偏倚导致的误诊。
- 电商促销策略模拟:市场团队输入“折扣力度对 GMV 影响”的文本描述,LLM 从历史文本中抽取出因果图并采样多种解释,CALVER 选出满足后门调整的策略链,直接用于预算分配决策。
局限
- 因果图的准确获取是瓶颈。CALVER 依赖因果结构图来验证推理轨迹,但在实际应用中,从非结构化文本自动构建完全正确的因果图依然困难。论文虽论证了不完美图也可能有效,但仅针对某些类型的图错误(如缺失无关边),当图存在关键遗漏或方向错误时,符号验证可能错误地拒绝有效推理或接受无效推理。这限制了方法在开放域或图质量不可靠的场景下的直接部署。
- 应用范围局限于可形式化的因果查询。CALVER 的验证规则基于 Pearl 的 d-分离、后门调整等标准,要求候选推理能解析为结构化变量和路径。对于涉及隐性知识、非参数化因果假设或复杂时序依赖的推理问题,该方法难以覆盖。此外,目前仅验证了 ATE 决策和逻辑任务的初步泛化,尚未展示在更一般推理任务(如法律、医学诊断)上的适用性,其符号检查器的扩展性仍需研究。
- 实验评估可能存在选择性偏差。论文主要在 CLEAR 数据集上报告了显著提升,而 CLEAR 具有多有效答案的特定特性,可能在标准因果问答任务中不具代表性。其他评估虽然涵盖多个贝叶斯网络,但规模较小且构造方式固定。更重要的是,所有实验的后处理分析(如 clean-core 子集)可能高估了方法的鲁棒性,因为真实世界的查询往往更嘈杂,且缺乏清晰的图结构或正确答案验证手段。