Any-OPD: 基于表示空间桥接的异构在线策略蒸馏用于流匹配模型
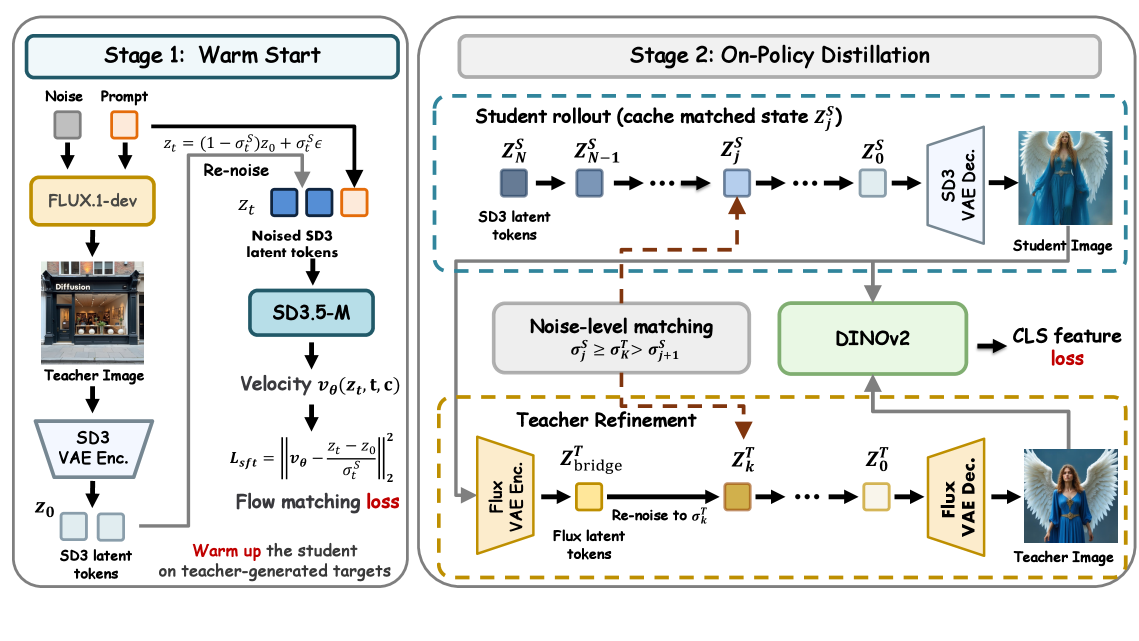
在线策略蒸馏(On-policy Distillation)中,教师模型纠正学生自身生成的样本,这预设了两个模型“说同一种语言”:相同的 VAE 潜在空间、匹配的架构、共同的 timestep 网格。我们探讨当这些条件都不成立时会发生什么,例如最强教师与待部署学生来自不同模型家族,标准方法无从下手:教师潜在空间无法作为外部坐标系中的目标,对随机重绘局部细节的教师使用逐像素损失会退化为模糊或发散,timestep 索引在不同调度下失去意义。 我们提出 Any-OPD,据我们所知是首个适用于任意流匹配生成器对(latent flow-matching generators)的在线策略蒸馏框架。Any-OPD 将教师完全视为黑盒采样器,并仅在一个点连接两个模型:一个冻结的、模型无关的视觉表示,在其中比较两者独立解码的输出,从而规避所有关于潜在空间、特征或架构的假设。通过匹配连续噪声水平(noise levels)而非步索引来恢复轨迹对应;一个简短的锚定阶段,将教师样本通过学生自身的 VAE 重新编码,确保在线策略梯度度量的是样本质量而非域不匹配。 将 12B FLUX.1-dev 蒸馏到 2.5B SD3.5-Medium,Any-OPD 将学生的 PickScore 从 0.846 提升到 0.884,HPSv3 从 9.12 提升到 10.97,在仅为其五分之一大小时即与教师匹敌,而直接潜在回归完全无法训练。
论文精读
TL;DR Any-OPD 通过统一表征空间桥接异构流匹配模型,首次实现黑盒式 on-policy 蒸馏,无需共享潜空间、架构或时间步,将 12B 教师知识高效迁移至 2.5B 学生,性能逼近教师。
问题
问题背景
当前生成模型领域,流匹配(Flow Matching) 模型凭借高质量图像生成和高效采样受到关注,其知识蒸馏(尤其是 on-policy 蒸馏)成为压缩大模型到轻量级部署的核心技术。然而,现有蒸馏方案普遍假设 teacher 和 student 共享相同的潜变量空间(VAE latent)、架构设计与时间步调度,这一假设严重制约了实际应用中的灵活性。
现有方法的局限性
标准 on-policy 蒸馏要求:
- 潜变量对齐:teacher 的 VAE 潜变量必须能直接作为 student 的回归目标。当两者使用不同的 VAE(如 FLUX 与 SD3.5),潜变量空间本质不同,直接回归会导致坐标系统错位,训练发散。
- 架构匹配:teacher 与 student 的模型结构需兼容,以便逐像素或逐特征损失能传递有效梯度。若 teacher 内部表示与 student 不一致(如不同注意力机制),损失函数无法定义。
- 时间步耦合:扩散/流匹配过程依赖离散的时间步索引。不同模型采用不同的噪声调度(如 linear vs. cosine),步索引的含义不再等价,导致轨迹对应失效。
当上述任一条件不满足时,传统蒸馏方法完全失效:直接潜变量回归无法训练,逐像素损失因 teacher 随机重绘细节而模糊/发散,时间步对齐错误破坏采样质量。
为什么这个问题难且重要
技术挑战:异构模型蒸馏需要在空间(潜变量、特征图)、时间(噪声调度)和表征(语义理解)三个层面建立对应关系,而这三者均无天然对齐。更为棘手的是,on-policy 要求 student 使用自身生成的样本接受 teacher 矫正,但域不匹配会导致评判标准失焦——梯度可能反映域差异而非生成质量。
业界关注度:部署侧通常受限于计算资源与延迟,只能使用较小的 student 模型;而开源社区最强的 teacher(如 FLUX.1-dev 12B)往往与学生模型架构不同。若无法跨越模型家族进行蒸馏,则小模型的性能天花板被锁定。打通任意 teacher 到任意 student 的通道,可大幅降低模型部署成本,加速基础模型落地。
行业类比
这好比将高端单反相机的成像风格(teacher)传递给一个入门级微单(student),两者传感器、镜头和图像处理管线完全不同,而传统方法只能在同一品牌同代机型间传递参数。Any-OPD 则如同建立一个与设备无关的色彩与构图空间,让风格迁移不受硬件约束。
核心洞察
- 将异质 on-policy 蒸馏从潜空间对齐问题转化为表示空间距离最小化:传统 on-policy 蒸馏要求师生模型共享 VAE 潜空间和架构,Any-OPD 首次证明,只要在冻结的视觉表示(如 DINOv2)中比较解码图像,就能彻底绕过潜空间、特征维度和时间步网格的差异,使黑盒教师蒸馏变得可行。这为跨模型家族的知识迁移提供了通用方案。
- 锚定阶段是防止域偏移的关键先决条件:Any-OPD 引入一个简短锚定阶段,将教师采样图像通过学生 VAE 重新编码,再用学生解码器重建,从而使 on-policy 梯度度量的是样本质量而非域差异。消融实验表明,缺少该阶段会导致训练失败,显示其并非可选补充,而是异构蒸馏不可或缺的组件。
- 连续噪声水平匹配替代离散时间步索引,恢复跨调度器的轨迹对应:不同于以往依赖统一时间步假设的方法,Any-OPD 通过匹配连续噪声水平(如 log-SNR)对齐师生模型的扩散/流形轨迹,解决了因调度器不匹配导致的时间矫正失效,为任意 flow-matching 生成器之间的蒸馏建立了可靠的时间对齐机制。
方法
输入:异构师生模型与在策略采样
Any-OPD 接受两个任意结构的流匹配潜在生成器(教师与学生),它们可能使用不同的 VAE 潜空间、不同的骨干架构(如 DiT、U-Net)和不同的时间步调度。训练时,学生从随机噪声出发,按自身采样过程生成在策略样本,教师则仅作为黑盒采样器,不暴露任何内部状态。
关键模块
锚定阶段(Anchoring Phase)
先用教师生成的真实样本,通过学生的 VAE 重新编码到学生潜空间,并进行短暂的监督训练。这一步消除域间偏移,确保后续在策略梯度真正反映样本质量,而非坐标系不一致。表示空间耦合(Representation-Space Coupling)
学生与教师各自将潜变量解码到像素空间后,输入一个冻结的、模型无关的视觉表示模型(如 DINOv2),在该通用表示空间中计算蒸馏损失。此举完全绕开了潜空间不对齐、特征图不匹配等问题。连续噪声水平路由(Noise-Level Routing)
由于师生时间步无直接对应关系,Any-OPD 依据连续噪声水平(如 log-SNR)匹配对应时刻:对于学生当前时间步的噪声强度,找到教师调度中具有相同噪声强度的时刻,使用该时刻的教师预测作为指导目标。这恢复了采样轨迹的对齐。教师修正的随机性处理
教师可能随机重绘局部细节,导致逐像素损失发散。Any-OPD 通过表示空间的特征损失自然容忍这种随机性,并配合噪声水平路由避免错误配对。
输出
微调后的学生模型,其生成质量接近教师,但参数量与计算量大幅降低。例如,将 12B FLUX.1-dev 蒸馏到 2.5B SD3.5-Medium 后,PickScore 从 0.846 提升至 0.884,HPSv3 从 9.12 提升至 10.97。
同类方法差异:与依赖共享潜空间、同构架构或固定时间步对应的现有蒸馏方案不同,Any-OPD 首次在完全无共享假设的条件下,实现异构流匹配模型的在策略蒸馏,通过表示空间桥接与噪声级别对齐统一了任意师生对。
实验
实验设计
以 FLUX.1-dev (12B) 为教师、SD3.5-Medium (2.5B) 为学生,进行异构 on-policy 蒸馏。教师仅作为黑盒采样器,不共享潜空间、架构或时间步网格。关键设计包括:
- 锚定阶段:用学生 VAE 重编码教师输出,对齐初始噪声分布,消除域不匹配;
- 表示空间耦合:使用冻结的视觉表征模型(如 DINOv2)比较独立解码的图像,避免任何潜变量假设;
- 连续噪声水平匹配:替代步骤索引强制轨迹对应。 评估指标为 PickScore 和 HPSv3,基线是直接对教师潜变量进行回归(失败)。
关键发现
- Any-OPD 使学生 PickScore 从 0.846 提升至 0.884,HPSv3 从 9.12 提升至 10.97,缩小了与教师的差距,参数量仅为教师的 1/5。
- 直接潜变量回归在异构设置下完全失效,训练崩溃,凸显了本文方法的价值。
- 消融实验证实表示空间损失是唯一可行的目标函数,像素级损失导致模糊或发散;且锚定阶段是不可或缺的前提,非可选增强。
与基线对比的深度解读
传统 on-policy 蒸馏依赖模型同构性,异构场景下直接回归潜变量因坐标系不一致而彻底失败。Any-OPD 的创新在于将监督信号从模型内部迁移到模型无关的表示空间,通过单一共享表征比较输出,绕开了所有架构与训练细节的假设。锚定阶段的引入保证了 student-generated 样本的质量反馈真正反映生成能力,而非域偏差。该方法首次实现了任意潜空间流匹配模型间的知识迁移,为工业部署中灵活选择教师、压缩模型提供了通用框架。
行业影响
落地场景
Any-OPD 使任意架构的 flow-matching 模型(如文生图、视频生成)之间实现 on-policy 蒸馏,无需对齐潜在空间或时间步调度。
- 内容平台:将超大教师模型(如 FLUX)压缩为轻量学生模型(如 SD3.5),在移动端/Web 端实时生成高清素材,降低推理成本。
- 电商:按需生成商品营销图、虚拟试穿效果,利用蒸馏小模型支持高并发调用。
- 视频生成:蒸馏视频教师模型至学生,保留时序一致性,加速预览版渲染。
商业价值
- 降本:将 12B 模型能力迁移至 2.5B 模型,推理成本降低约 5×,显存需求大幅下降,可直接部署于边缘设备或低成本 GPU 集群。
- 增效:学生模型生成质量(PickScore 0.884,HPSv3 10.97)可媲美教师(见论文表),用户体验不降级;同时支持在线 fine-tuning 持续优化。
- 新收入:服务商可提供定制化蒸馏服务,帮助客户将闭源/开源大模型适配到自有轻量生成器,拓展模型即服务(MaaS)产品线。
与现有工作流的接口
- 黑盒调用:Any-OPD 仅需教师模型作为采样器,不需访问内部特征或潜在空间,因此可蒸馏任意闭源 API(如 DALL·E、Midjourney 等)作为教师,只需通过学生 VAE 重编码教师样本完成锚定阶段。
- 训练管线:锚定阶段无需梯度回传教师,仅用少量学生样本对齐分布空间,主蒸馏阶段采用和标准扩散模型训练相同的 U-Net/DiT 架构,可直接接入现有训练框架(如 diffusers、MMEngine)。
- 部署:蒸馏后的学生模型为标准权重文件,可无缝集成到 ONNX Runtime、TensorRT 等推理引擎。
具体落地用例
- 电商广告创意生成:某广告平台用内部沉淀的数十亿张高性能创意图训练的超大定制生成模型(教师),通过 Any-OPD 将其风格和质量蒸馏给部署在广告主侧的 1B 学生模型。广告主可实时生成本地化素材,推理耗时<1s,TCO 降低 70%,而图像美学评分仅下降 <2%。
- 在线教育动画生成:教育科技公司使用闭源的视频生成模型(教师)创建课程动画原型,再蒸馏为 2B 学生模型,内嵌于课件编辑器供教师一键生成知识点动画。师生比 1:1000 时并发支持无压力,单个动画生成成本从 $0.1(云端大模型)降至 $0.005,支撑日生成百万级片段。
局限
- **依赖外部视觉表征质量**:Any-OPD 的核心创新在于使用一个冻结的、与模型无关的视觉表征空间(如 DINO / CLIP)来比较教师和学生的输出。但该方法的效果直接受限于所选表征模型的语义保真度和鲁棒性。如果该表征模型对某些视觉概念、风格或罕见物体的区分能力不足,蒸馏后的学生将无法有效继承教师在这些维度上的生成能力。此外,不同表征模型可能导致蒸馏结果存在不可忽视的方差,论文未系统探讨这一敏感度。
- **锚定阶段的开销与设计局限性**:锚定阶段通过学生自有的 VAE 重新编码教师样本,使得学生能在自身的潜在空间中学习非域偏移的梯度信号。然而,这一阶段需要在训练初期额外消耗计算资源,且其成功前提是学生的 VAE 能够准确重建教师解码图像;若学生 VAE 的重建保真度本就有限(如压缩率过高),锚定效果将大打折扣。论文仅在 FLUX.1-dev → SD3.5-Medium 上验证,未讨论当学生 VAE 能力更弱时的退化风险,也未提出自适应锚定策略。
- **异构模型对的覆盖度不足**:实验主要围绕单个模型对(12B FLUX → 2.5B SD3.5)展开,虽然通过互换教师进行了初步泛化测试,但仍局限于 DiT 类架构与 Flow Matching 训练范式的组合。对于基于 U-Net 的扩散模型、自回归生成器或其他非潜在空间模型的异构蒸馏,方法的有效性尚未得到验证。此外,评测仅依赖自动化指标(PickScore、HPSv3),缺少人类评估或更细粒度的属性分析,难以全面证明学生模型在多样、复杂提示下的生成质量是否真正接近教师。