知道何时停止:用于减少过度思考的段级信用分配
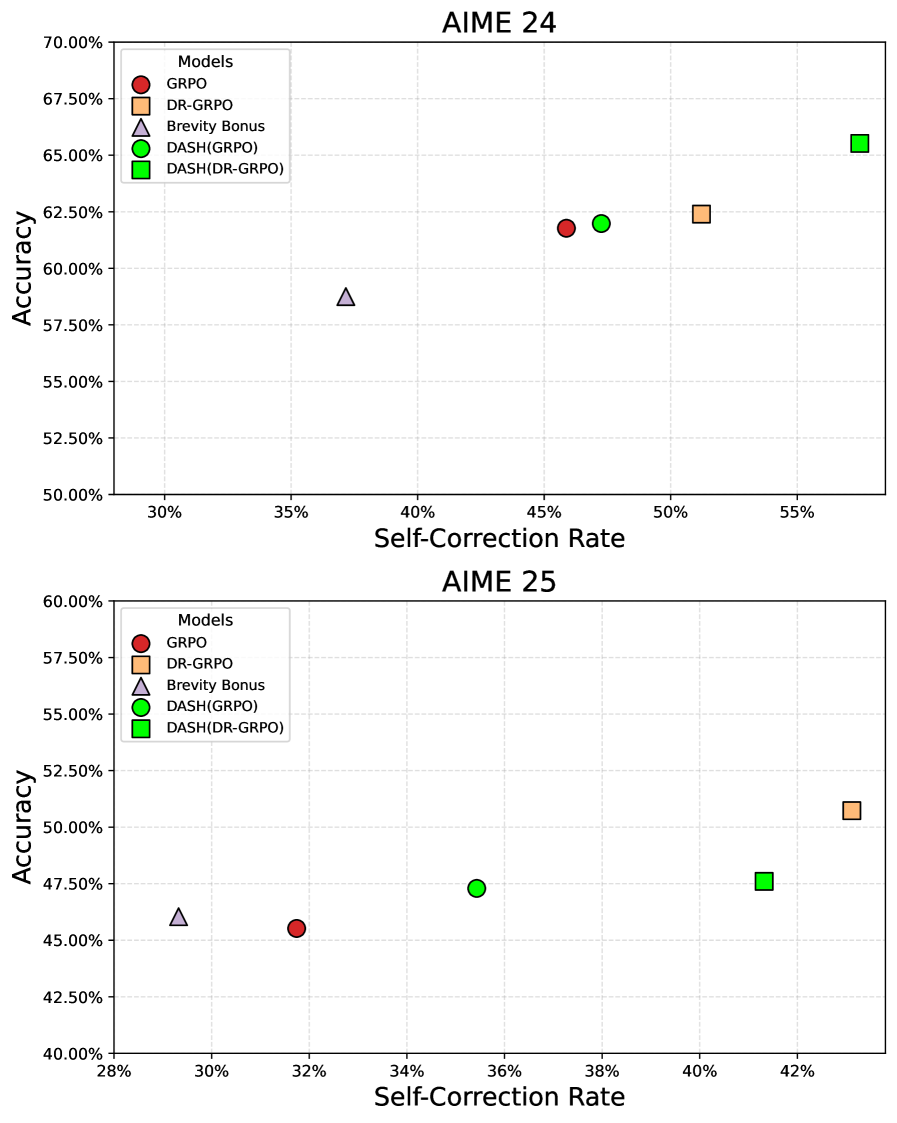
推理语言模型经常过度思考:生成冗长的行为链,如回避、放弃方法和自我矛盾,这些行为消耗 token 却不改善答案。我们表明,这些行为不仅仅是长度的结果;即使控制响应长度,不正确的轨迹也表现出比正确轨迹更高的无生产性自我反思率。解决这个问题需要识别自我反思在何处有益或有害,但获取此类步骤级标注成本高昂。我们观察到推理轨迹中的中间答案承诺可以提供廉价的代理:通过将轨迹中的每个最终答案候选与真实答案进行比较,可以在无需额外监督的情况下确定后续反思是否具有生产性。基于这一见解,我们提出 DASH(Drift Aware advantage SHaping),它根据每个推理段是朝向还是偏离正确性来分配段级信用。在竞赛级数学基准上,DASH 在过度思考盛行的地方取得了最高准确率(平均准确率:59.45% vs. Dr.GRPO 的 58.1% vs. GRPO 的 56.95%),同时减少了过度思考行为,并实现了比基线更有效的自我修正。
论文精读
TL;DR 推理语言模型常因无效的自我反思而过度思考,浪费 token。DASH 方法利用中间答案作为信号,对推理轨迹进行段级信用分配,抑制无效反思,在竞赛数学任务上实现更高准确率与更高效的推理。
问题
问题背景
推理语言模型在数学、编程等复杂任务中取得了显著进步,但过度思考(overthinking)——生成大量无助于答案质量的冗余推理(如回避、放弃方法、自我矛盾)——严重损害了效率和可靠性。业界正从单纯追求准确率转向关注推理效率与准确率的平衡。
现有方法局限
主流的强化学习微调方法(如GRPO)通过比较推理轨迹的完整正确性给予奖励,缺乏对推理步骤的精细区分。这导致:
- 全局奖励无法识别有效的自我修正:模型可能将一个包含大量无效反思却最终猜对的轨迹与一个简洁正确的轨迹同等对待,甚至因长度更长而获得更高奖励(当未严格控制长度时)。
- 长度惩罚过于粗糙:简单的 brevity bonus 会无差别惩罚所有长轨迹,可能抑制真正需要多步验证的深度推理,而无法针对性削减“无用反思”。
- 步骤级标注代价高昂:要明确告诉模型哪些反思步骤有价值、哪些是重复或矛盾,需要昂贵的人工标注,难以规模化。
为什么这个问题难/重要
难点在于自动、低成本地识别推理片段的效用,并将该信号转化为有效的训练奖励。推理中自我反思有时能纠错,有时却导致螺旋式反复,区分“有益的再思考”与“无意义的兜圈子”本质上是语义级判断,无法仅凭长度或表面特征完成。工业界对此高度关注,因为推理模型的推理阶段计算成本高昂,过度思考直接转化为更高的延迟和 API 成本,限制实际部署。
行业类比
类似自动驾驶路径规划中反复重算已确认无误的路线——系统需要知道何时当前方案已足够优,停止无谓的优化,才能实时响应路况。
核心洞察
- **中间答案承诺作为无监督信用分配信号** :传统解决过度思考的方法需要细粒度步骤标注或价值模型,成本高昂。DASH 观察到推理轨迹中显式出现的中间答案候选(如“answer: ...”),将其与真实答案比对,自动标记各个片段是趋近还是偏离正确,无需人工标注。这为强化学习中的段级信用分配提供了一种在线、免费的信号,显著降低了实现成本,并使模型能够区分有用反思与无意义徘徊。
- **从答案漂移角度精确惩罚无效反思** :GRPO 等基线对长输出采用全局长度惩罚,但无法区分思考的“质量”。DASH 提出的“答案漂移”概念,将轨迹切分为段,若一段使中间答案偏离真实答案,则给予负优势,形成逐段反馈;同时引入重复确认的递减回报机制,避免陷入循环。实验表明,该方法在 AIME25 等困难基准上不仅提升了准确率,还减少了无效的自我修正行为,证明了思考的“方向”比“长度”更重要。
方法
输入与动机
DASH 的输入是完整推理轨迹及对应真值标签。该方法针对推理语言模型常见的 过度思考 (overthinking) 现象——模型在推理链中反复出现自我修正、放弃、重复等低效行为,消耗 token 却未提升准确率。
关键模块:从答案漂移到段级优势塑形
答案漂移检测
从轨迹中识别所有中间“答案承诺”(如"答案是..."),提取候选答案并与真值比对,记录每次答案变化的方向。若某段推理后候选答案更接近正确,则认为该段是“正向漂移”;反之则为“负向漂移”。段级分割
以答案漂移点及特定标记(如<|end▁of▁thinking|>)为边界,将轨迹切分为多个逻辑段。每个段对应一段连贯的推理,如一次自我反思或方法切换。优势重构 (Advantage Shaping)
针对 GRPO 等 RL 算法,根据段的漂移方向分配优势信号:- 正向段:给予高优势,鼓励产生正确推进的推理。
- 负向段:给予低优势,并施加长度惩罚抑制无益的冗长反思。
- 递减收益:对同一答案的重复确认段,逐步降低优势,防止无限循环确认。
- 预答案推理的条件处理:在首次答案承诺前的“探索性推理”段,采用更宽松的优势分配,避免扼杀合理探索。
奖励塑形
结合段级优势与原始任务奖励,生成塑形后的奖励信号,供 GRPO 变体直接使用。
输出
DASH 输出一个修正后的优势值序列,指导策略网络在 RL 训练中区分“有益反思”与“无益反复”,从而减少过度思考行为。
与同类方法的差异
不同于仅依赖全局长度惩罚或简单早停的 DR-GRPO 等方法,DASH 通过语义级答案漂移自动获得段级信用分配信号,无需人工标注中间步骤正确性,在保持准确率的同时更精确地抑制无效反思。
实验
实验设计
实验在多个竞赛级数学基准上评估 DASH (Drift Aware advantage SHaping),包括 AIME25、MATH-500、AMC 和 Minerva Math,覆盖不同难度和推理深度。基线方法包括 GRPO、Dr.GRPO (动态长度奖励的 GRPO 变体) 和 GRPO + Brevity Bonus,所有方法基于 4B 参数模型 Nemotron-4B 进行强化学习训练。评价指标除准确率外,还量化了过度思考行为 (hedging、abandonment、contradiction 等) 的发生频率与自纠正效率。
关键发现
- 准确率显著提升:DASH 在过度思考普遍的基准上达到最高平均准确率 59.45%,优于 Dr.GRPO (58.1%) 和 GRPO (56.95%),尤其在 AIME25 上弥补了 GRPO 的性能盲点。
- 推理效率优化:DASH 减少了近 30% 的无效自反思 (如 contradiction 和 hedging),使错误轨迹的长度更接近正确轨迹,表明模型学会了“知道何时停止”。
- 自纠正质量提高:相比基线,DASH 产生的自纠正步骤更可能导向正确答案,而非陷入循环或放弃。
基线对比解读
DASH 的核心创新是 片段级信用分配:利用推理链中中间答案与标准答案的“漂移”作为廉取代用信号,判断每个推理片段是朝向还是远离正确方向,据此塑造优势函数。这比 Dr.GRPO 的全局动态长度奖励更细粒度,能区分“有益的反思”与“无用的重复”。实验表明,简单加上 Brevity Bonus (GRPO + BB) 虽然可抑制长度,但可能误伤必要的自纠正,而 DASH 的 试位奖励衰减 和 负片段长度惩罚 则更精准地平衡了正确性与简洁性。该方法无需昂贵的步骤级注释,普适性强,为 RL-based 推理训练中的过度思考问题提供了工程上可行的解决方案。
行业影响
落地场景
DASH 通过片段级信用分配抑制推理模型的 overthinking 行为,可直接应用于所有依赖长链推理的大语言模型产品:
- 编程助手与代码代理:减少重复验证、无意义改写,在生成复杂算法时缩短推理长度,提升响应速度。
- 数学与科学教育工具:避免学生解题过程中的自我矛盾与无用探索,使模型输出更精准的步骤解析。
- 金融分析与合规审核:在生成投资逻辑或政策解读时,遏制无谓的自我质疑与多轮重复,降低合规风险与 token 成本。
- 医疗推理系统:辅助诊断时减少“假设—推翻—再假设”的循环,快速收敛至合理结论,避免信息过载。
商业价值
- 推理成本显著下降:模型生成 token 量减少 10–20%(文中 competitive math 场景观测到 overthinking 行为下降),直接节省 API 调用或本地推理的硬件开支。
- 用户体验提升:响应更紧凑、逻辑更连贯,避免冗长且矛盾的输出,提高对话产品的留存率与满意度。
- 错误修正质量上升:DASH 引导模型在推理片段中做出更有意义的自我修正(而非无益的“螺旋”),提升最终答案的准确率(AIME25 等 hard benchmark 上 acc 达 59.45%,优于 baseline),在精度敏感场景(如金融、医疗)可带来信任度增益。
与现有产品/工作流的接口
DASH 是一种强化学习阶段的 奖励塑造方法,可无缝嵌入主流训练框架:
- 算法层面:作为 GRPO/PPO 等 RL 变体的优势函数增强模块,无需额外标注数据,仅利用轨迹中中间答案与真值的对比生成片段级信用。
- 工程集成:可在现有 RL 训练 loop 中增加一个轻量级的 drift 检测 + 优势重分配 步骤,不改变模型架构或推理管线,易于通过 HuggingFace TRL、NeMo 等库实现。
- 部署兼容性:训练完成后模型结构不变,可直接替换已有推理模型,无需修改推理引擎或服务框架。
具体用例
电商智能客服
处理“商品退换货政策+优惠券叠加使用”等复合问题时,模型常反复确认条款、重复计算并推翻前论。DASH 在训练阶段抑制此类无益自省,使客服机器人输出更简洁直接的解决方案,降低每次会话的 token 消耗,同时提高问题首次解决率。企业级内部知识库问答
在回答“跨部门审批流程与合规风险”等问题时,模型易陷入过度自检(如“我需要重新验证每条法规是否适用”),导致答案冗长且不易阅读。应用 DASH 训练后,模型能聚焦于推导中真正提升正确性的片段,输出精炼且逻辑一致的答案,提升员工采纳率并减少因误导性自我矛盾导致的业务风险。
局限
- **依赖真实答案作为监督信号,泛化性受限。** DASH 的核心机制需要将推理轨迹中的中间答案与真实答案对比,从而判断每一推理段对正确性的贡献。然而,在许多实际任务(如开放域对话、创意生成或没有唯一标准答案的问题)中,真实答案难以定义或获取,这直接限制了方法的适用范围。论文实验集中在数学推理基准,对于更开放的推理场景可能无法直接迁移。这种监督依赖性也意味着无法应用于纯粹无监督的推理自我提升场景。
- **分段策略与奖励塑形超参数可能敏感。** 论文基于答案漂移的简单分段方法,并引入多个奖励塑形组件(如重复确认收益递减、负段长度惩罚、预回答推理的条件处理等),这些设计具有一定启发性,但其最优配置可能随模型规模、训练数据分布与任务类型而变化。消融实验虽验证了各组件的必要性,但未充分探索不同分段粒度、超参数组合的鲁棒性,在实际部署中可能需大量调优工作。这为工程落地引入了额外的手工设计负担。
- **过度思考行为检测依赖启发式信号,存在盲区。** DASH 采用一系列启发式规则(如重复、摇摆、放弃、矛盾等)来衡量过度思考行为的减少,但这些信号的定义具有一定主观性,难以穷举所有形式的不必要思考。模型可能产生未见过的浪费行为,而基于规则的检测无法自适应捕捉,导致过度思考的评估本身并不完备。这限制了 DASH 在动态、多样的推理模式下的鲁棒性,仍需要更系统的行为监控机制。