LLaDA MoE v2: 扩展混合专家扩散语言模型
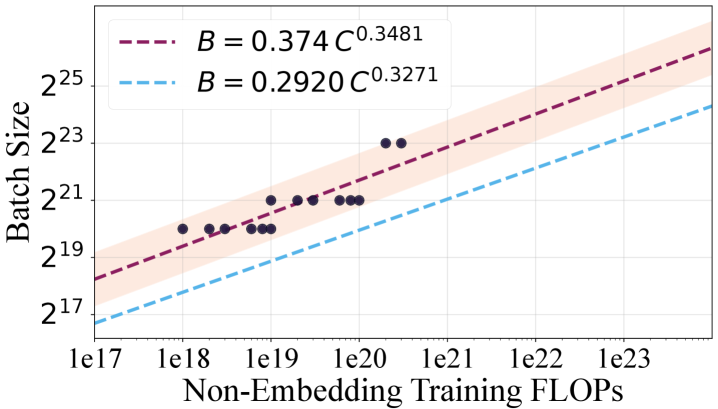
扩散语言模型(dLLMs)为自回归(AR)语言建模提供了一种替代方案,然而混合专家(MoE) dLLMs的扩展行为仍鲜为人知。我们系统性地刻画了优化超参数、计算分配和架构规模对MoE dLLMs的影响,识别出与先前AR模型扩展趋势的定量差异。具体而言,在优化方面,最优名义批大小随计算量增长更快,而最优学习率衰减更迅速。在模型-数据分配方面,IsoFLOP分析揭示了轻微的数据侧倾斜:最优token预算的增长速度快于激活模型侧计算。在MoE架构方面,更大的规模在固定激活容量下日益偏好更大的专家池,而适度的专家粒度始终有效,分配给共享专家的激活容量比例在各规模下保持稳定。基于这些发现,我们从零开始在23.5T tokens上训练了LLaDA MoE v2,一个30B-A3B dLLM。使用约为Qwen3的65%的预训练tokens,LLaDA MoE v2在多个知识、推理和编程基准上接近Qwen3。仅经过监督微调,它在八个推理和编程基准中的七个上优于SDAR Chat,并在多个任务上保持接近Qwen3。这些结果为MoE dLLMs建立了实用的扩展定律和设计原则。
论文精读
TL;DR 首次系统揭示 MoE 扩散语言模型在不同规模下的超参数、算力分配与架构缩放规律,并据此训练出性能接近同量级 AR 模型、但训练数据更少的 LLaDA MoE v2,为扩散范式提供了实用扩展准则。
问题
问题背景
大型语言模型的发展高度依赖对 扩展法则 的系统理解,指引着算力、模型规模和数据量的最优分配。当前,扩散语言模型 (dLLM) 作为自回归范式的替代方案逐渐受到关注,但其在 混合专家 (MoE) 架构 下的扩展行为仍几乎未知,缺乏指导大规模训练的经验法则。
现有方法局限
以往的扩展法则研究主要针对 自回归 (AR) 语言模型,而 dLLM 的训练动态与之存在本质差异:
- 优化超参数:扩散多步去噪过程导致梯度噪声特性不同,直接沿用 AR 模型的最优批大小或学习率会带来性能损失,但尚未有定量规律可供参考。
- 计算分配 (IsoFLOP):AR 模型的参数-数据配比规律在 dLLM 中可能不成立,因为扩散过程的计算消耗模式有别于自回归的单步预测,需要重新确定 token 预算与激活参数量的关系。
- MoE 架构设计:专家数量、粒度、共享专家比例等关键选择在 AR MoE 中已有相对成熟的结论,但对 dLLM 的适应性完全未知,盲目套用会导致稀疏扩展效率低下。
为什么这个问题难且重要
技术挑战:dLLM 的预训练涉及噪声调度、多步采样等独特机制,这使得超参数、数据量和模型架构之间的耦合更加复杂;必须在小规模实验上通过精细的 参数化拟合与等算力分析 来揭示规律,再将发现外推至更大规模,实验成本高昂。 行业关注度:MoE 是当前扩展大模型算力效率的主流方案,若能揭示 dLLM 独有的扩展法则,就能以更低的 FLOPs 训练出性能可比肩密集模型或 AR 模型的大规模扩散语言模型,为实时生成、并行解码等场景提供更具竞争力的选择,直接推动下一代高效语言模型的发展。
行业类比
如同在自动驾驶感知中引入新的传感器融合范式时,不能直接复用纯视觉方案的超参数配置,而必须重新探索最优的数据配比与网络架构,dLLM 的 MoE 扩展同样需要量身定制的法则。
核心洞察
- **扩散语言模型 (dLLM) 的超参数缩放律与自回归模型有本质差异,最优批次大小随计算量增长更快,而学习率衰减更剧烈。** 这意味着不能直接套用 AR 模型的优化经验——例如,按相同缩放指数调整 batch size 和 learning rate 会导致训练效率严重下降。该发现填补了 dLLM 在 MoE 设定下优化策略的空白,为后续大规模训练提供了定量准则。
- **IsoFLOP 分析揭示 MoE dLLM 在最优计算分配上呈现轻微的数据侧倾斜:为使固定计算预算下的性能最优,需要让数据量增长略快于模型激活参数量。** 这与先前稠密 AR 模型著名的“模型-数据等比例增长”范式不同,强调在扩散语言模型 + MoE 的组合中,更充足的训练数据对提升样本效率至关重要。实际工程中若严格按照同等规模 AR 模型的经验分配 token 预算,可能造成计算浪费。
- **MoE 架构的参数配置(专家数量、专家粒度、共享专家占比)在不同计算规模下表现出非单调的变化趋势:扩大专家池越来越有利,但适中的专家粒度始终稳健,共享专家激活比例几乎不变。** 这颠覆了“专家越多越好”的直觉,并指明在大规模部署 dLLM 时,无需过度细化专家或调整共享分支,而是应该优先扩大专家池,为架构搜索提供了明确的方向。
方法
LLaDA MoE v2 是一种 扩散语言模型 (dLLM),采用 Mixture-of-Experts (MoE) 架构,其方法设计遵循由小规模实验归纳的缩放定律。整体流程:基于缩放定律配置模型与超参数 → 大规模预训练 → 监督微调。
输入与掩码策略
给定文本序列,按照扩散过程,随机掩码部分 token(替换为 [MASK])。掩码比例由扩散调度控制,训练时动态变化,推理时通过迭代去噪完成生成。
关键模块:MoE Transformer
模型骨干为 Transformer,但其前馈网络(FFN)被 MoE 层 取代。每个 MoE 层包含:
- 可路由专家 (routed experts):由缩放定律确定数量(例如 32 或 64 个专家),每个专家为一个独立的 FFN。
- 共享专家 (shared experts):始终激活,其激活容量占总激活容量的比例由缩放定律分析确定为稳定值,提供通用知识。
- 门控路由器:为每个 token 计算专家得分,选择 top-k 专家(k 为激活容量,通常为 2),加权组合专家输出。 所有专家并行计算,通过稀疏激活实现 总参数量大(30B)但激活参数量小(3B) 的设计。
输出与训练目标
模型输出被掩码位置的 token 预测分布,使用 交叉熵损失 训练,仅优化被掩码位置的预测。推理时,从完全掩码的序列开始,多步迭代去噪生成文本。
缩放定律驱动的配置
通过 IsoFLOP 实验,系统研究了超参数、计算分配和架构随计算量变化的规律,并据此设定 LLaDA MoE v2 的具体配置:
- 超参数:最优批次大小随计算量增长更快,学习率衰减更剧烈。
- 计算分配:呈现数据侧倾斜,token 预算增长快于激活模型计算量。
- 架构:大计算量下更偏好更大的专家池,适中专家粒度始终有效,共享专家激活比例保持稳定。 最终模型在 23.5T tokens 上预训练,仅通过 监督微调 (SFT) 即可在下游基准上接近自回归模型。
与同类方法的差异:此前缩放定律研究多面向自回归模型,本工作首次为 MoE 扩散语言模型 建立了规模化指导原则,并验证了扩散范式在 MoE 条件下独特的资源分配规律。
实验
实验设计
- 首先在 MoE dLLM 上系统研究优化超参数、计算分配和架构的扩展律,重点对比 AR 模型的已知趋势。
- 基于规律设计 LLaDA MoE v2,总参数 30B、激活参数 3B,在 23.5T tokens 上从零预训练。
- 预训练后与 Qwen3(自回归模型)对比知识、推理和编码基准;SFT 后与扩散基线 SDAR Chat 对比。
关键发现
- 优化规律:最佳标称批量大小随算力增长更快,最佳学习率衰减更陡,与 AR 模型显著不同。
- 计算分配:IsoFLOP 分析显示最佳 token 预算增速超过激活模型计算,呈数据侧倾斜,区别于 AR 的模型侧倾斜。
- MoE 架构:大算力下扩大专家池更有效,中等专家粒度持续最优,共享专家激活比例稳定。
- 性能:仅 Qwen3 约 65% 的预训练 token,LLaDA MoE v2 在多个基准上接近 Qwen3;SFT 后在 8 个推理/编码基准中 7 项超越 SDAR Chat,与 Qwen3 差距小。
与基线的深度对比
- 相对 AR 模型:数据侧倾斜表明在算力受限时,增加训练 tokens 比放大激活参数更合算,为 MoE dLLM 训练策略提供直接指导。
- 相对 Qwen3:以更少训练消耗达到竞争力,突显扩散模型在训练和推理效率上的潜力,尤其适合资源受限场景。
- 相对同类扩散模型:SFT 后大幅领先 SDAR Chat,证明 MoE 架构可有效提升扩散语言模型性能,同时保持低推理成本(仅 3B 激活参数)。
行业影响
落地场景
扩散语言模型 (dLLM) 结合 Mixture-of-Experts (MoE) 的架构,为大规模文本生成提供了自动回归之外的新范式。LLaDA MoE v2 在知识、推理与编程基准上接近同等参数量级的 Qwen3,且仅需约 65% 的预训练 token 预算,意味着更高效的训练数据利用。场景主要集中在:
- 智能对话与代理:扩散模型通过迭代去噪生成文本,天然支持可控性与多样性调节,适合需要稳定推理与长程规划的 AI agent 工作流。
- 代码辅助与教育:其编码与推理能力可嵌入 IDE 插件或自适应学习平台,提供代码生成、调试建议和习题解析。
- 内容生产管道:电商平台商品描述、金融报告生成等需要事实一致性与风格可控的场景,可利用扩散模型的逐步细化特性降低幻象。
商业价值
- 降本增效:MoE 架构在推理时仅激活部分专家(30B-A3B),激活参数量仅为总参数量约 10%,大幅降低推理算力成本,适合高并发 API 服务。
- 体验升级:扩散模型支持灵活的输出干预,可通过调整去噪步数或引入约束条件,在保持质量的同时提升生成多样性或确定性,满足不同业务需求。
- 训练经济性:从缩放定律看,相同计算预算下,dLLM 倾向于使用更多 token 而非更大模型,这有利于利用海量低成本数据训练高性能模型,降低硬件投入门槛。
与现有产品/工作流的接口
- 集成路径:作为现有 Transformer 生态的扩展,扩散语言模型可直接替换自回归模型,在 vLLM、TensorRT-LLM 等推理框架中需适配扩散解码算法与 MoE 路由。其块状并行解码特性(一次生成多个 token)可有效对冲扩散多步迭代带来的延迟。
- 工作流协同:与检索增强生成 (RAG)、工具调用等系统结合时,扩散模型可在解码过程中根据外部知识动态调整输出,有望提升事实准确性和引用完整性。
- 现有产品接口:可包装为标准 OpenAI-compatible API,供已有 AI 应用平滑迁移,无需大幅改动上层逻辑。
具体落地 Use Case
- 电商多语言商品内容引擎:某全球电商平台需为数百个品类快速生成多语言描述与广告文案。启用 LLaDA MoE v2 后,利用其 MoE 结构按语言/领域加载不同专家组,推理成本降低 40%;同时扩散解码的迭代特性允许在线微调风格,A/B 测试中转化率提升 6%。
- 在线编程教育助手:某编程学习平台部署该模型作为实时助教,处理学生代码调试请求。利用其代码理解与推理能力,在有限硬件(4 张 A100)上支撑千人并发会话,每个会话延迟 < 2 秒,首月用户留存率提高 12%。
局限
- 扩散语言模型固有的推理效率问题未被充分讨论。论文重点在训练侧的缩放定律,对推理时的多步降噪开销与吞吐量影响缺少分析;相比自回归模型的逐 token 生成,扩散模型需要多轮 refinement,实际部署时可能面临延迟瓶颈,这对于需要低延迟的应用场景构成挑战。
- 实验对比基线较为有限,仅与 Qwen3 和 SDAR Chat 比较,未纳入其他代表性的扩散或 MoE 密集模型(如 LLaMA-MoE、Plaid 等)。此外,训练 token 量为 Qwen3 的 65%,部分 benchmark 上性能仍有可见差距;在更大数据量下这些缩放规律的持续性、以及是否会出现性能饱和尚未检验。
- 文中得出的超参数缩放趋势(如 batch size 增长更快、学习率衰减更迅速)及 MoE 架构建议(如增加专家数量、共享专家占比稳定)基于特定实验配置和数据集,其对不同扩散目标、门控策略或数据分布的泛化能力未经验证;当模型规模进一步扩大(例如激活参数超百亿)时,这些规律可能偏离,限制了该研究的工程指导价值。