LegalPincite:多层级法律信息检索数据集
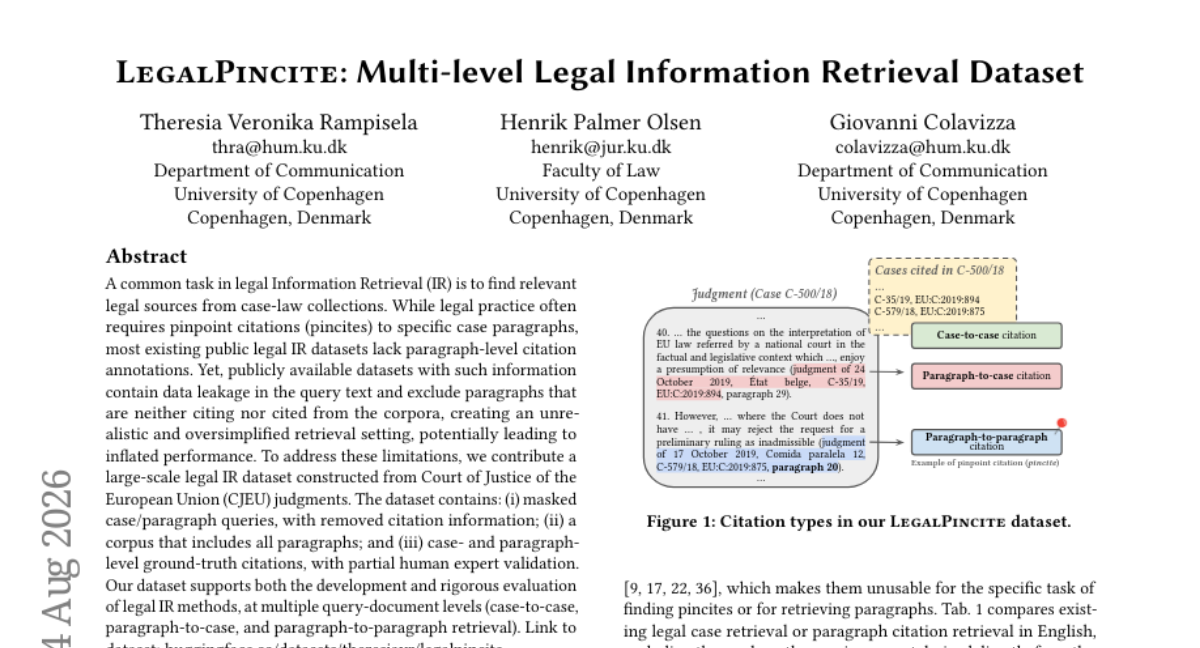
法律信息检索(IR)的常见任务是从判例法集合中查找相关法律来源。法律实践通常需要 pinpoint citations(pincites)定位到具体判例段落,但现有公开法律IR数据集大多缺乏段落级引用标注。少数包含此类信息的数据集则存在查询文本中的数据泄漏,且将既非引用也非被引用的段落排除在语料之外,导致检索环境不真实且过于简化,可能产生虚高的性能。 为克服上述局限,我们构建了大规模法律IR数据集 LegalPincite,基于欧盟法院(CJEU)判决。数据集包含:(1) 掩码的案件/段落查询,已移除引用信息;(2) 包含所有段落的语料库;(3) 案件级与段落级真值引用,并经过部分人类专家验证。 LegalPincite 支持多层级查询-文档检索任务(案件到案件、段落到案件、段落到段落),可用于法律IR方法的开发与严格评估。数据集链接:https://huggingface.co/datasets/theresiavr/legalpincite
论文精读
TL;DR LegalPincite 构建了首个带段落级引用标注、消除数据泄露的大规模法律检索数据集,支持案例/段落多粒度评测,为真实场景下的精准法源检索提供基准。
问题
问题背景
法律信息检索(Legal IR)的核心任务是依据查询从判例集合中检索相关法律源文。在实际法律实践中,律师和法官不仅需要整篇判例,更需要精确定位到具体段落(即 pin-point citation, pincite),以支撑论证或判决。然而,现有公开的法律检索数据集大多仅提供文档级(整篇判例)的相关性标注,缺少段落级标注,难以驱动精细化检索模型的开发。
现有方法局限
当前少数包含段落级引证的数据集存在两个关键缺陷:
- 查询信息泄露:查询文本中直接保留了引证信息(如“See Case X, para. 5”),模型容易学到简单的字符串匹配,而非真正的语义理解。
- 语料库不完整:在构造数据集时,未引用或未被引用的段落被从语料中移除,导致检索环境过于简化,与实际全文检索场景不符。
这些设计缺陷使得模型评测结果虚高,且训练出的模型难以迁移到真实法律工作流中。
为什么这个问题难/重要
段落级法律检索的难度在于:
- 语义粒度细:段落级匹配要求模型理解法律论点之间的逻辑关联,而非仅主题相关性,对语义表征能力要求极高。
- 数据标注昂贵:法律段落引证需要专家逐段核对,大规模人工标注难以实现,因此自动化构建高质量数据集极具价值。
- 实际需求迫切:全球法律 AI 市场对精准法律检索的付费意愿持续走高,产品级应用(如司法辅助、律师工作台)亟需段落级检索能力。
本工作通过构造符合真实检索约束(查询去引证、完整语料)的多粒度数据集,直击上述痛点,为法律 IR 方法从文档级走向更细粒度的落地提供了关键评测基准。
行业类比
类似 RAG(Retrieval-Augmented Generation)在知识密集型任务中需要从海量文本中定位支撑句,法律段落检索可视为垂直领域的高精度证据召回,对幻觉敏感的法律文书生成至关重要。
核心洞察
- 该数据集首次在法律 IR 领域同时修复了**查询数据泄露**与**语料库不完整**两大常见缺陷,构建了更接近真实场景的评估基准。以往数据集的查询文本可能包含引用信息,导致模型通过简单规则即可匹配,虚高指标;而 LegalPincite 将查询中的引用信息进行掩码处理,强制模型基于语义检索。同时,它保留了所有段落在语料库中,避免了只保留引用与被引用段落的简化设置,使得检索难度更贴近实际,可更可靠地评估法律 IR 模型的真实泛化能力。
- LegalPincite 支持**案例到案例、段落到案例、段落到段落**三个粒度的检索任务,这种多层级设计更贴合法律从业者的真实工作流。现有数据集大多仅支持案例级检索,而实务中律师常需定位到支持特定法律论点的具体段落。该数据集不仅提供段落级真实标注,还允许统一框架下研究不同粒度的检索模型,为开发细粒度法律 IR 系统提供了统一的训练与评估平台,有助于推动法律 AI 从文档推荐走向精准的论据支撑工具。
方法
数据集构建流程
LegalPincite 的构建遵循 CJEU 判决书采集 → 段落级处理 → 多级查询生成 → 引用标注与验证 的管线。
- 输入: 收集来自欧盟法院 (CJEU) 的全部已公开判决书原始文本。
- 关键模块:
- 段落分割与语料库构建: 将每份判决书按段落拆分为独立单元,所有段落(无论是否包含引用)均保留在语料库中,确保检索环境的真实性。
- 查询生成: 抽取判决书中包含引用的段落作为查询源,将引用标记掩码处理,移除具体的案例编号或段落指示信息,形成案例级 (case-level) 和段落级 (paragraph-level) 的掩码查询。
- 多级真实引用标注: 提供两级标注——案例对案例、段落对段落(也包含段落对案例),部分标注经过法律专家人工校验,保证高质量。
- 输出: 最终数据集包含掩码查询、完整段落语料库以及多级真实引用,支持案例到案例 (case-to-case)、段落到案例 (paragraph-to-case) 和段落到段落 (paragraph-to-paragraph) 三种检索任务。
相比以往数据集,LegalPincite 的关键差异在于消除查询中的引用泄漏且将非引用段落纳入语料库,避免了由于简化数据设置而导致的性能虚高,为法律信息检索提供了更严格、更贴近实际应用的基准。
实验
实验设计:本文在 LegalPincite 数据集上定义了三种检索任务——案例到案例(case-to-case)、段落到案例(paragraph-to-case) 和 段落到段落(paragraph-to-paragraph),并评估了包括稀疏检索(如 BM25)与稠密检索(如 DPR、ANCE)在内的基线模型。通过掩码查询中的引用信息并保留所有段落于语料库,实验消除了先前数据集常见的 数据泄漏 和 语料库不完整 问题。
关键发现:
- 段落级检索远比案例级检索困难,尤其在 段落到段落 任务中,模型需精细匹配法律论据片段。
- 移除查询中的引用信息(如“see paragraph 42”)显著降低了基线性能,验证了数据泄漏会 虚增 指标。
- 当语料库包含所有段落(包括非引用段落)时,检索更符合真实场景,但也导致性能下降,凸显现实设定对鲁棒性的要求。
与基线对比解读:
以往数据集(如 COLIEE、CaseLaw)多仅支持案例级检索,且查询文本中常残留引用线索,段落实体被选择性排除。LegalPincite 通过彻底掩码和完整语料库,构建了更严格的评估场景。在此设定下,现有稀疏和稠密模型仍有较大提升空间,尤其是段落级别的语义对齐。这提示法律 IR 社区需开发能理解细粒度法律推理的模型,而非依赖表面的引用模式匹配。
行业影响
落地场景
LegalPincite 数据集直接服务于法律科技产品的精准判例检索能力升级。核心应用包括:
- 智能法律研究平台:辅助律师从海量判例中快速定位与当前案件最相关的段落,而不仅是整篇判决书,实现从“案到案”到“段到段”的检索粒度提升。
- 合同/诉状起草助手:在起草法律文书时,系统可自动推荐支持论点的精确引用来源,并通过段落级对齐确保引用无误。
- 法院/律所内部知识管理:构建判例知识图谱,实现判例间论断的自动关联与溯源,提升内部知识复用效率。
商业价值
数据集的多层级标注(案例级、段落级)和严格的数据清洗(移除引文泄露、保留全量语料)直接解决了法律检索中高误配成本和训练-评测偏差的痛点,带来三重价值:
- 降本:减少律师手动查阅判例的时间(通常占案件准备时间的 30%),自动化准确度提升可显著降低人力成本。
- 增效:段落级检索直接输出可引用的具体论述,加速文书起草和论证流程,提升律所案件吞吐量。
- 体验提升:为用户(律师、法务)提供更可信、更透明的检索结果,增强产品黏性。对于提供法律 SaaS 或 API 的企业,更高准确率意味着更强的市场竞标能力。
与现有产品/工作流的接口
集成LegalPincite 训练出的模型可无缝嵌入现有检索管线:
- 搜索增强架构:作为段落重排序模块(paragraph re-ranker),叠加在传统关键词/向量搜索引擎之上,对已召回案例进行段落级精细排序。
- 生成式法律 AI 工具:为 LLM 提供可验证证据支撑。在 RAG 流程中,用段落级检索结果替换整篇文档,减少幻觉,确保每个生成陈述都能定位到出处。
- 数据标注工作流:可直接采用数据集的格式化标准定义法律文本解析、段落切分及引用关系抽取的 pipeline,降低工程化落地门槛。
具体落地 Use Cases
- 电商平台纠纷智能裁决辅助:大型电商平台内的买卖纠纷仲裁常需引用历史仲裁判例。系统集成 LegalPincite 模型的段落检索能力,可自动推荐与当前纠纷细节最匹配的仲裁段落,仲裁员一键采纳,将平均裁决时间从数小时压缩至分钟内。
- 金融合规审查加速:金融机构在审查反洗钱、制裁名单等合规文件时,需要对比大量金融法院判例。利用段落级检索,合规分析师可迅速找到与当前可疑交易模式相似的判例段落作为决策依据,减少误报和漏报,并使审计痕迹更清晰。
局限
- **数据集领域与语言单一**:LegalPincite 仅包含欧盟法院 (CJEU) 的英文判决,虽然 CJEU 判例在欧盟法律体系中具有权威性,但不同法域 (如普通法系与大陆法系) 的引用模式和论证风格差异显著,且 CJEU 判决的写作风格相对统一,这使得基于该数据集训练的模型泛化到其他法院或语言时性能可能大幅下降。此外,CJEU 案例主要涉及欧盟法,其法律概念和议题覆盖范围有限,难以代表刑事、合同纠纷等常见法律检索场景,限制了该基准的生态多样性。
- **引用标注的自动提取与部分验证**:段落级 ground-truth 主要依赖判例文本中已有的引用标记 (如 'paragraph X of Case Y') 自动解析,虽然辅以部分人类专家验证,但自动提取可能遗漏隐含引用、不规范引用或跨段落语义关联,且人类验证仅覆盖子集,导致标注本身存在系统噪声。在严格评估中,模型可能因学习到提取模式而非真正理解法律论点而获得虚高指标,影响对真实检索能力的判断。
- **查询构造简化了真实交互场景**:数据集的查询通过直接掩码原段落中的引用信息生成,这虽然消除了数据泄露,但形成的查询本质上仍是从完整论证中摘取的片段,包含较完整的上下文线索。实际法律检索中,用户输入的查询通常为短句、关键词或问题,缺乏段落级详尽的上下文,且常需跨多段落推理。该构造方式可能高估模型在真实场景下的表现,与律师实际撰写查询的行为存在语义鸿沟。