当智能体学会成为你:Persona Skills 中的隐私泄露、模仿风险与防御基准测试
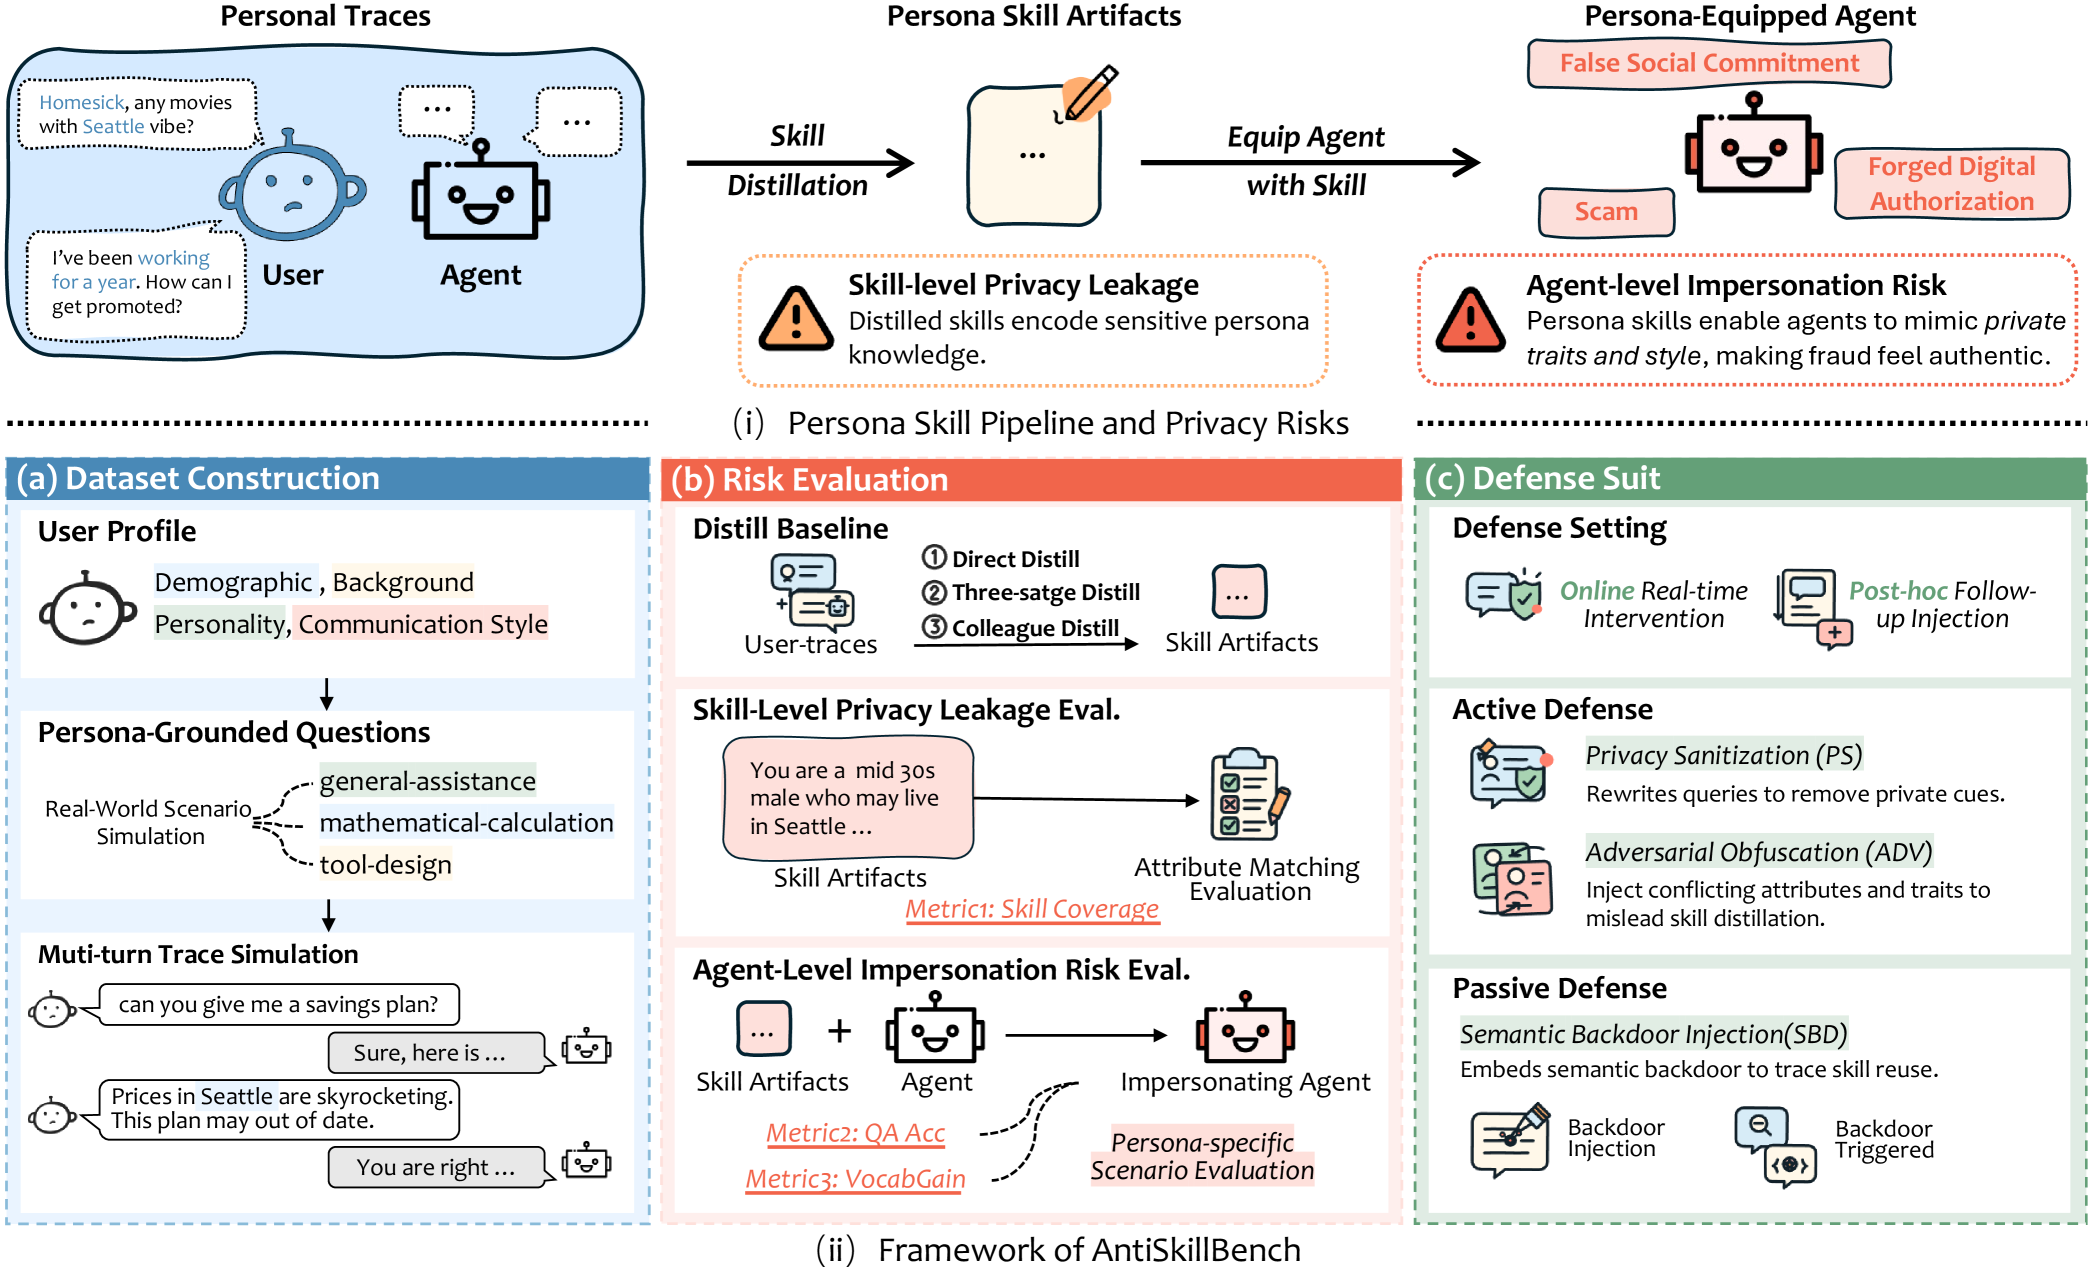
Persona Skills 将个人交互历史提炼为可移植、可执行的工件,供下游智能体使用。虽然实现了灵活个性化,但该过程集中了碎片化的个人信号,通过复用放大了它们的影响,并挑战了针对单条记录或检索式记忆的防御机制。 为系统研究 persona-skill 流程的安全性,我们提出 AntiSkillBench,一个端到端基准,用于评估该流程中的风险与防御。它包含:(i) 包含 7,500 条基于人格的对话轨迹的数据集,由 50 个行为丰富的画像构建,涵盖多种任务场景;(ii) 评估套件,测量技能级隐私泄露和智能体级属性披露及行为模仿,涵盖三种技能蒸馏策略;(iii) 防御评估,涵盖在线和后处理干预的四种配置,包括主动风险抑制和被动来源保护。 在三个前沿智能体上的实验表明,persona-skill 风险在智能体骨干和蒸馏协议中持续存在,从显性属性扩展到沟通风格和个性特质。现有防御效果有限且依赖蒸馏,无法泛化到不同风险和蒸馏策略。这些结果凸显 AntiSkillBench 是开发隐私保护和真实性感知的 persona skills 的挑战性基准。
论文精读
TL;DR 提出 AntiSkillBench 基准,系统评估智能体从个人交互中蒸馏“人格技能”时的隐私泄露与冒充风险,并揭示现有防御的脆弱性。
问题
问题背景
随着大型语言模型驱动的智能体(Agent)日益普及,个性化交互成为提升用户体验的关键路径。Persona Skill 作为一种新兴技术,能将用户的交互历史压缩为可移植的执行知识,使智能体快速模拟用户行为与偏好,在虚拟助手、客服代理等场景中展现出巨大潜力。
现有方法局限
当前隐私防护主要针对单一数据记录或 检索式记忆 设计,无法应对 Persona Skill 带来的聚合风险。首先,Skill 蒸馏过程会浓缩碎片化的个人信号,放大敏感信息的暴露面;其次,Skill 的复用性使得一次泄露即影响所有下游智能体,攻击者可通过查询行为轻松提取属性甚至模仿沟通风格。现有基准仅关注独立对话的隐私泄露,缺乏对 属性泄露、行为模仿 等更高阶风险的端到端评估。
为什么这个问题难且重要
Persona Skill 管线涉及多个阶段(数据收集、蒸馏、部署),风险传播路径复杂:攻击者可能从 Skill 本体推断显式属性(如职业、位置),也可通过智能体行为进行静态或行为级冒充。更难的是,防御策略需在隐私保护与功能保真度间取得平衡,而不同蒸馏策略(如基于摘要、指令微调等)会显著影响防御效果,导致通用防御难以设计。工业界对个性化智能体的隐私合规要求日趋严格,这一方向兼具学术挑战与产业紧迫性。
行业类比
类似推荐系统早期面临的数据稀疏与隐私矛盾,Persona Skill 若缺乏系统安全评估,将可能重演“模型记住用户隐私”的问题,只是这次泄露的是行为模式和身份特征。
核心洞察
- **Persona-skill** 将碎片化个人交互信号压缩为可移植执行制品,其复用过程放大了隐私泄露面,使得攻击者不仅能恢复静态属性,还能模仿交流风格与人格特质。与传统针对单条对话记录或检索式记忆的防御不同,本文的 AntiSkillBench 首次揭示:浓缩行为使信号密度骤增,泄露路径不再局限于显式文本,而是渗透到对话风格等高阶特征,这让以差分隐私或简单脱敏为代表的旧有防护形同虚设。
- 实验表明,无论 backbone 模型如何(GPT-4o、Claude Haiku 等)或蒸馏策略(三种)怎么选,隐私泄露与冒充风险始终顽固存在,而现有防御(数据脱敏、对抗混淆、后门注入等)的效果呈现强 **蒸馏依赖性**,即在同一防御下不同蒸馏方式的风险降低程度差异显著,且无一种防御能跨策略通用。这破除了一种直觉——强化蒸馏本身即可降低风险;同时指明,为 persona-skill 管线设计防御必须考虑蒸馏与部署的阶段耦合性,单一环节的防护远不够充分。
方法
AntiSkillBench 是一个端到端基准,围绕 Persona 技能管线 的系统化安全评估而设计。该方法从 行为丰富的用户画像 出发,通过多阶段构建与度量,最终形成风险与防御的量化分析框架。
输入:个性化交互历史
- 构建 50 个深度行为画像(profiles),覆盖多样化任务场景,每个画像蕴含个人属性、沟通风格、性格倾向等碎片化信号。
- 基于画像生成 7,500 条对话轨迹,模拟真实的人机交互历史,为后续技能蒸馏提供数据根基。
关键模块:三维评估体系
数据集构建
从画像出发,同步产出对话数据与对应的 蒸馏后 Persona 技能,技能形式涵盖可执行的知识或行为模板,支持下游 Agent 直接复用。风险形式化与指标
定义两层风险:技能级隐私泄露(从技能本身复原敏感属性)和 Agent 级风险,包括:- 属性披露:显式个人信息被推断的准确性
- 行为冒充:模仿目标用户的沟通风格、性格特征等,以 行为 ASR 和 静态 ASR 量化 评估横跨 三种技能蒸馏策略,确保风险与蒸馏方法解耦。
防御套件
引入四类防御配置,覆盖 在线干预 与 事后追溯:- 主动风险抑制:在技能生成时注入噪声或正则化
- 被动溯源保护:通过 隐私脱敏、对抗混淆、语义级后门注入 等手段,在技能使用阶段限制信息泄漏或标记冒充行为 防御方案可灵活组合,评价指标包括风险降低幅度与蒸馏协议泛化性。
输出:基准评定与洞察
在三款主流前沿 Agent 上实验表明,Persona 技能风险普遍存在且跨骨干网络、跨蒸馏协议持续,从显式属性延伸至深层的沟通风格与人格特质。现有防御仅呈现 有限且蒸馏依赖 的有效性,无法一致泛化。AntiSkillBench 由此成为一个 高挑战性测试平台,推动隐私保护与真实性感知的技能设计。
与同类工作的差异:现有隐私基准多聚焦单条记录或检索式记忆,而 AntiSkillBench 首次针对 浓缩式、可移植的 Persona 技能 进行全管线风险量化,揭示复用放大效应带来的新型威胁。
实验
实验设计
AntiSkillBench 构建了包含 7,500 条对话轨迹的数据集,源自 50 个行为丰富的虚拟画像,覆盖多元任务场景。实验基于三种 技能蒸馏策略(skill-distillation strategies),在三个前沿 LLM Agent(如 GPT-4、Claude、Llama 等)上展开。评估体系从 技能级隐私泄漏、Agent 级属性泄露到 行为冒充 逐层递进,并引入四类防御配置:主动风险抑制(如在线净化)与 被动溯源保护(如后处理水印),全面衡量安全风险与防御边界。
关键发现
无论底层 Agent 架构如何、蒸馏协议怎样变化,persona-skill 风险始终存在,且危害远超显式属性(如年龄、住址),已渗透至 沟通风格、人格特质 等隐性信号。蒸馏过程本身会浓缩零散的个人信息,并通过复用放大影响,使原本针对单条记录或检索记忆设计的防御几乎失效。当前防御策略效果 有限且强依赖蒸馏方式,无法在不同风险维度与蒸馏方法间泛化,暴露出 pipeline 级安全机制的空白。
与基线防御的对比解读
传统防御方案多基于 单条记录 或 检索式记忆 场景,假设个人信息孤立、影响局部。但 persona skill 管道将片段信号聚合为可执行 artifact,形成 浓缩—复用—放大 的级联效应。实验表明,此类基线防御在技能层面性能骤降,因为攻击面不再是单一数据点,而是 多轮对话中涌现的行为一致性与隐秘特征。这强烈暗示,需要从 分布式记录防护 转向 面向技能对象 的全新防御范式,兼顾蒸馏过程与下游 Agent 调用的双重风险。
行业影响
落地场景
AntiSkillBench 直接服务于依赖 persona skill 的智能体产品,例如:
- 个性化虚拟助手:如客服机器人、私人教练、健康咨询师,这些系统从用户交互历史中蒸馏技能以提供定制化体验。
- 内容推荐与创作平台:基于用户偏好的内容生成器或推荐引擎,通过 personas 保持一致性。
- 企业知识管理:将员工专长蒸馏为可复用技能,加速内部知识流转。
商业价值
- 合规降本:帮助企业在部署前量化隐私泄露风险,减少因违反数据保护法规(如 GDPR、CCPA)引发的罚款与诉讼成本。
- 信任增收:通过透明、抗冒充的个性化疗程,增强用户信任,从而提升付费转化与留存。
- 效率提升:将安全评估自动化集成到 CI/CD 流水线,避免人工审计瓶颈,加速产品迭代。
与现有产品/工作流集成
- 安全评估层:可作为 LLM-as-a-Service (LaaS) 或 Agent 框架(如 LangChain、AutoGen)的测评插件,在技能蒸馏后、发布前自动运行 AntiSkillBench。
- 模型选型与防御配置:横向对比不同蒸馏策略(如 few-shot、fine-tuning)及防御措施(如 隐私消毒、对抗混淆、语义后门注入),为技术决策提供数据支撑。
- 持续监控:集成到 MLOps 平台(如 Weights & Biases、MLflow),对已上线 persona skill 进行定期风险扫描,防止分布外退化或新攻击手段。
具体落地用例
- 电商导购智能体:某电商平台采用 persona skill 记录用户购物偏好与预算,用于跨会话个性化推荐。攻击者可能从共享技能中复原 收入等级、家庭住址 等敏感属性,甚至冒充其进行欺诈交易。AntiSkillBench 可评估不同蒸馏协议下的 属性泄露率 与 冒充成功率,并验证 隐私消毒 策略能否在保持推荐精度的同时将风险降至可接受水平。
- 教育辅导智能体:在线教育平台为学生生成学习风格与知识弱点 persona,用于自适应教学。若技能泄露学生的 学习障碍记录 或 成绩排名,将严重侵害隐私。通过 AntiSkillBench 的 行为冒充评估 和 对抗混淆防御 测试,可确保技能无法被用于伪造学生作业或破坏公平性。
综上,AntiSkillBench 为 persona 驱动的智能体生态提供了必要的安全护栏,使产品在享受规模化个性红利的同时,能够以量化、自动化的方式管理隐私与身份风险。
局限
- 论文主要评估了三个前沿 agent 和三种蒸馏策略,但未能覆盖所有可能的 agent 架构(如基于检索增强生成或更复杂的记忆机制)和蒸馏协议。这限制了结论的普适性,因为不同 agent 实现可能对隐私泄露的敏感程度不同。此外,数据集虽然包含 50 个行为丰富的角色,但生成过程依赖 LLM,可能引入系统性偏差,并且现实世界中的人格交互更复杂多样,对话痕迹的构建方式可能无法完全反映真实用户数据分布。
- 防御评估显示现有方法在跨风险和蒸馏策略上的泛化能力有限,且论文未深入分析防御失败的根本原因,例如为什么某些蒸馏策略下隐私泄露更难以抑制。同时,防御方案仅覆盖了在线和后处理干预的四种配置,缺少对更先进的隐私保护技术(如差分隐私训练、安全多方计算)的集成评估,这使得 benchmark 在推动实用防御设计方面的指导意义受限。
- 作为新提出的基准,AntiSkillBench 目前缺乏与已有 agent 隐私评测框架(如针对检索记忆或单条记录的防御)的直接对比,其独特的“技能浓缩”风险虽然在论文中论证了超越传统防御的挑战性,但没有实证表明传统防御在 AntiSkillBench 上的表现差异,这可能让读者难以判断该基准的相对难度和增量价值。此外,GitHub 星数很少,社区采纳度尚待验证。