Zero-Mem: 面向 LLM Agents 的零 Token 记忆操作
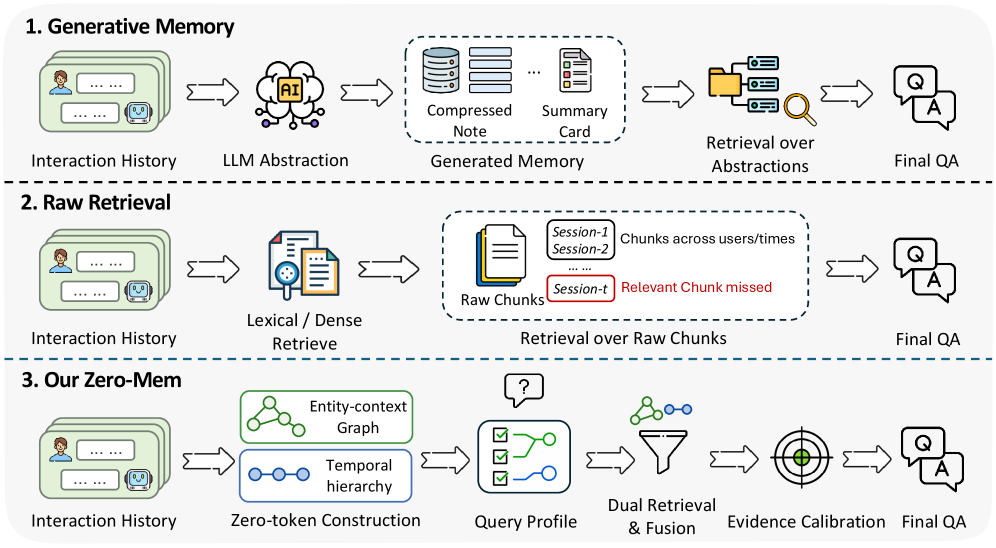
LLM agents 需要记忆才能在长时间交互中保持一致行为,但许多系统依赖额外的 LLM 调用来操作记忆。生成中间记录并协调检索会带来持续的 token 和时间开销,而省略或合并细节可能掩盖原始证据。我们提出一个问题:结构化记忆访问是否真的需要生成? Zero-Mem 引入了零 token 记忆操作:除最终问答外,没有任何步骤调用 LLM 或消耗 LLM 输入/输出 token;编码器计算单独核算。Zero-Mem 将原始交互轨迹作为记录来源,并以两种互补方式组织:实体-上下文图 暴露跨交互的连接,时间层次 保留对话局部性和会话状态。对于每个查询,Zero-Mem 权衡两种视图,从两者检索,并沿结构恢复支持关系或上下文。确定性校准 先丢弃冲突证据,再确保读者答案基于检索到的轨迹。只有最终 QA 读者调用 LLM。 在长记忆与长上下文问答基准上,Zero-Mem 实现了有竞争力的性能,同时彻底消除了记忆操作中的 LLM 调用与 token 消耗。使用相同的最终 QA 读者和上下文预算,它相对于最快的对比基线将记忆操作时间成本降低了 57.6%。消融实验支持两种视图及其查询依赖协调的贡献。总体结果表明:结构化代理记忆无需生成过去的中间表示。
论文精读
TL;DR Zero-Mem 为 LLM Agent 设计零 token 记忆操作:除最终问答外不调用 LLM,通过实体‑上下文图与时间层次双视图检索及确定性校准,消除记忆环节的 token 消耗与 LLM 调用,时间成本降低 57.6%,性能保持竞争力。
问题
问题背景
LLM agent 需要在多轮交互中维持一致的行为与知识状态,长期记忆 成为关键组件。当前研究的焦点是:如何在不断积累的交互历史中高效存取信息,使 agent 能准确回答跨越长时间窗口的问题。
现有方法局限
多数 agent 记忆系统采用 生成式记忆操作:
- 额外 LLM 调用:使用独立的 LLM 对历史进行摘要、融合或重写,生成中间记忆记录,并再次调用 LLM 决定检索哪些记录。
- 高昂 token 开销:每次记忆操作都消耗输入/输出 token,在多轮对话中成本累积严重。
- 信息损失:压缩或选择性存储可能遗漏关键细节,模糊原始交互证据,导致回答时上下文不足或失真。
这些方法将记忆管理与最终问答耦合,使得记忆操作本身成为吞吐量和延迟的瓶颈,且难以在固定预算下扩展至超长对话。
为什么这个问题难/重要
技术挑战在于:
- 结构化存取与生成的解耦:检索相关历史时,既要保证证据的完整性和原始性,又要避免引入生成式开销。
- 多维度信息组织:交互历史包含实体关系、时序依赖等异构信息,单一索引难以兼顾精确匹配和上下文关联。
- 冲突证据的校准:不同历史片段可能包含矛盾信息,需要确定性机制筛选,而非依赖生成模型“猜测”。
业界关注度高,因为 agent 在客服、虚拟助手、游戏 NPC 等长程交互场景中,延迟和成本 直接影响可用性与规模化部署。
行业类比
这类似于 搜索引擎的倒排索引与网页快照:索引让系统快速定位相关信息,而保留完整页面避免了摘要带来的信息损耗;Zero-Mem 正是为 LLM agent 构建了无需额外生成的“索引+原文”记忆基座。
核心洞察
- 零 Token 记忆操作解耦了记忆与生成,挑战了当前 LLM agent 系统依赖中间生成步骤的主流范式。传统记忆机制通过额外 LLM 调用进行摘要、整合或检索,不仅产生持续的 token 开销和延迟,还可能因压缩或改写而丢失原始证据。Zero-Mem 直接用原始交互轨迹构建实体-上下文图和时序层次,并在检索时进行确定性校准,仅在最终问答环节调用 LLM。这证明结构化的记忆访问无需生成中间表示,大幅降低运营成本,同时确保了回答的可追溯性与完整性。
- 双视图索引与查询自适应协调实现了更精准的证据恢复,优于单一向量存储或固定检索策略。Zero-Mem 的实体-上下文图捕获跨会话的关系链接,而时序层次保留对话的局部上下文,两者互补。在回答查询时,系统根据查询内容动态权衡两个视图,并沿图结构传播或沿层次回溯,从而检索出支持关系或周围语境。这种确定性检索避免了生成模型的不稳定性,且在长记忆和长上下文基准上达到有竞争力性能,同时将记忆操作时延降低 57.6%,对实时系统和成本敏感型应用具有显著工程价值。
方法
输入:LLM Agent 在多轮交互中的原始对话轨迹(不经过任何摘要或改写)。
关键模块
零Token记忆基座 (
Provenance-preserving Token-Free Memory Substrate)- 以保留来源的方式存储原始轨迹,构建两种互补结构:
- 实体-上下文图 (
Relational trace graph):将实体作为节点,交互中共现或显式关系作为边,捕捉跨对话的实体关联。 - 时间层次结构 (
Hierarchical trace units):按对话轮次、时段建立树状索引,保留会话局部性与时间顺序。
- 实体-上下文图 (
- 同时维护词汇索引(如 BM25)和稠密向量索引(编码器输出,仅计编码算力),供后续高效检索。
- 以保留来源的方式存储原始轨迹,构建两种互补结构:
查询条件证据路由 (
Query-Conditioned Evidence Routing)- 双视图证据检索 (
Dual-View Evidence Retrieval):对每个查询,从实体图和层次结构分别检索相关轨迹片段。- 图证据传播 (
Graph evidence propagation):从查询命中的实体出发,沿边扩展,收集周围关系证据。 - 层次证据检索 (
Hierarchical evidence retrieval):利用时间索引定位到最相关的对话窗口,提取连续上下文。
- 图证据传播 (
- 系统会根据查询特性动态权衡两个视图的贡献(如实体型问题更依赖图,时序型问题更依赖层级)。
- 双视图证据检索 (
双视图证据闭包 (
Dual-View Evidence Closure)- 合并两路检索结果,并追踪证据在原始轨迹中的位置,形成有源可溯的证据集合。
确定性证据校准 (
Deterministic Evidence Calibration)- 通过规则(非 LLM)识别并剔除相互矛盾的证据片段,确保留存的轨迹一致、可信,避免后续阅读器被误导。
输出:将校准后的证据连同原始问题,送入唯一的 LLM 调用(最终 QA 阅读器) 生成答案。
与同类方法的关键差异:传统记忆机制(如 MemGPT、RAP)常用 LLM 生成中间摘要或协调检索,产生额外 token 与延迟;Zero-Mem 用纯结构化访问代替生成式中间表示,完全消除记忆操作中的 LLM 调用与 token 消耗,同时通过双视图及校准保持证据准确性,显著降低时间开销并保持竞争力。
实验
实验设计
Zero‑Mem 在 LoCoMo 和 HotpotQA 两个长记忆问答基准上评估,统一使用 final‑QA reader 并固定上下文窗口预算,对比多种依赖额外 LLM 调用的记忆系统。评估维度包括端到端问答准确性、记忆操作耗时以及 LLM token 消耗。消融实验逐步移除实体‑上下文图谱或时序层次结构,观察双视图设计和查询依赖路由对性能的贡献。
关键发现
Zero‑Mem 在完全不调用 LLM 进行记忆操作的前提下,取得了与基线 competitive 的问答准确率。在相同 reader 和上下文预算下,其记忆操作时间相对最快的基线方法降低 57.6%。消融表明,实体‑上下文图谱负责跨交互关联,时序层次提供会话局部性,二者互补且依赖查询权重动态组合;去掉任一视图均导致明显的性能下降。
与基线对比的深度解读
典型记忆系统每次访问记忆都需生成中间摘要或检索计划,累计 token 开销随交互轮次线性增长,且可能丢失原始证据细节。Zero‑Mem 反过来将原始交互痕迹作为唯一信源,通过确定性图传播和层次检索取代生成式记忆中介,最终仅用一次 LLM 调用完成答案生成。这一设计证明,结构化记忆的访问与组织本身不需要引入额外的生成过程,为构建高效、可追溯的 LLM agent 记忆提供了新的工程范式。
行业影响
落地场景
Zero-Mem 适用于需要长期交互记忆的 LLM agent 系统,如智能客服、个人助理、教育辅导、金融顾问、游戏 NPC 等。它直接操作原始对话痕迹,无需生成中间记忆记录,因而特别适合要求证据可追溯、低成本的场景。
商业价值
- 降本:彻底消除记忆操作中的 LLM 调用,token 消耗近乎归零,直接减少 API 支出。论文数据显示,记忆操作时间成本相对最快基线降低 57.6%,同等服务质量下可大幅节省算力。
- 提速:减少 LLM 调用步骤,降低端到端延迟,改善实时交互体验。
- 增收:更低的运营成本允许更优惠的服务定价,突破原有限制处理更多并发请求,提升 ARPU。
与现有产品/工作流的接口
Zero-Mem 作为记忆子系统,可替换现有 agent 框架(如 LangChain、AutoGPT、MemGPT)中的记忆模块。它仅负责检索与校准,最终 QA 仍调用 LLM,解耦设计使得迁移成本可控:先替换记忆检索部分,逐步切换。其实体-上下文图和时间层次可基于现有图数据库或向量存储实现,与主流基础设施兼容。
具体落地 Use Case
- 电商智能客服:某跨境电商平台的客服 agent 需维护多轮对话上下文(如商品对比、优惠询问),Zero-Mem 直接检索原始对话中与当前问题相关的片段,无需每轮生成摘要,降低 LLM 成本,减少响应时间。
- 企业知识助手:某 SaaS 公司内部问答 agent 需跨会话记住员工查询历史,Zero-Mem 通过实体-上下文图关联相关文档和对话,避免记忆生成开销,使知识检索更高效、证据更可靠。
局限
- **构造外部存储的预处理依赖及可扩展性隐患**:Zero‑Mem 将全部交互原始轨迹构建为实体‑上下文图与时间层级结构,这高度依赖实体链接、共指消解等预处理模块的准确性,若这些模块在噪声文本上失效,证据路由质量将严重下降。另外,尽管本工作未直接讨论存储开销,长期运行的 agent 持续追加轨迹会使图规模线性膨胀,导致检索时图遍历与邻居证据传播的延迟显著增加,最终抵消零 token 的成本优势。
- **任务泛化与校准策略的局限**:验证仅覆盖 LoCoMo 与 HotpotQA 两个长记忆/长上下文 QA 设定,未涉及工具调用、多轮对话生成或交错式环境反馈等真实 agent 场景,因此在更复杂推理范式下的效果未知。此外,**确定性证据标定**采用直接丢弃冲突证据的策略,虽能抑制幻觉,但在需要融合多对矛盾证据以抽取关键信息的场合(如观点摘要、多方辩论分析)可能导致信息丢失,制约模型在高冲突型任务上的性能上限。
- **零 token 不等于零计算**:Zero‑Mem 宣称在记忆操作环节消除 LLM 调用与 token 消耗,但编码文本以生成向量的编码器(如基于 Transformer 的 dense embedding 模型)仍消耗可观的计算与内存资源;论文将编码开销“单独核算”,但在端到端系统中该开销可能成为新的瓶颈。随着知识库增大,编码、索引更新与图遍历的累积成本会稀释零 token 带来的延迟改进,这一点在效率分析中还未充分建模。