SAF-OPD: 稳定优势融合用于在线策略蒸馏
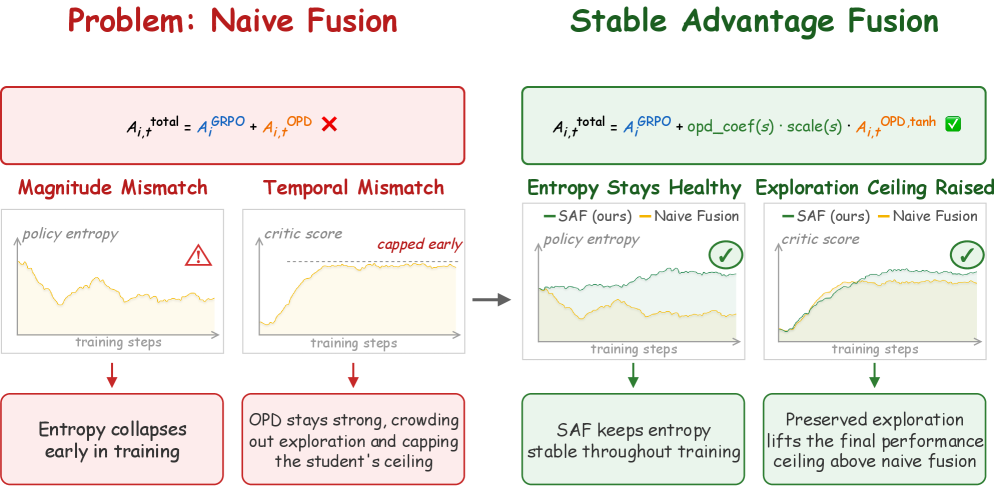
RLVR 将单一 response 级奖励广播到每个 token,而 OPD 则用更强的教师模型为每个 token 评分,提供密集优势,但其性能上限受限于教师质量,且会抑制超越教师的探索。两者具有互补性,因此融合 RLVR 与 OPD 很有前景,但我们发现:用固定系数融合两种优势会引发熵崩塌,原因有两个失配:幅度失配(token 级 OPD 优势可能远超有界的 RLVR 优势,从而抹掉后者的信号)和时间失配(持续全强度的 OPD 不断将学生拉向教师,限制了超越教师所需的探索)。 我们提出 SAF(Stable Advantage Fusion)框架,通过一个轻量级四阶段流水线解决上述问题,该流水线仅作用于 OPD 优势:采用 sparsify-then-compress 机制控制幅度,搭配 warm-up-then-anneal 机制控制时间;每个阶段可独立开关,额外开销可忽略不计。 以 GRPO 实例化 RLVR,我们在 Qwen3-1.7B/4B/8B 上评估了 SAF,涵盖七个数学推理与代码生成基准。结果表明:SAF 避免了熵崩塌,且一致优于固定系数的 GRPO+OPD 融合,在全部六个模型-领域设置中将综合分数提升了 0.51-2.70%,同时训练更加稳定。
论文精读
TL;DR SAF-OPD 通过稀疏化-压缩和预热-退火双机制,解决优势融合的幅值与时序失配,防止熵崩溃,使学生模型稳定超越教师性能。
问题
问题背景
当前,强化学习结合可验证奖励(RLVR) 已成为提升大语言模型数学推理与代码生成能力的标准范式,但它将粗粒度的响应级奖励广播到每个 token,缺乏细粒度的 token 级信号。
现有方法局限
为了给每个 token 提供更细粒度的指导,在线策略蒸馏(OPD) 通过与更强教师模型的 token 级分布匹配来提供稠密优势信号。然而,将 RLVR 与 OPD 直接融合会导致熵坍缩(entropy collapse)——模型在训练中迅速丧失探索能力,最终性能甚至不及单独用 RLVR。其根因在于两个校准失配:
- 幅度失配(magnitude mismatch):OPD 产生的 token 级优势值可能远大于 RLVR 的响应级优势,导致 RLVR 信号被淹没,粗粒度的正确性反馈失去作用;
- 时序失配(temporal mismatch):训练全程保持全强度的 OPD 会持续将学生拉向教师,抑制其超越教师所需的探索行为,使模型永远无法突破教师上限。
技术挑战与重要性
这两个失配问题之所以困难,是因为它们并非独立存在:降低 OPD 强度可以缓解幅度冲击,但也会削弱 token 级指导;过早减弱 OPD 又可能导致训练前期缺少有效监督。如何在不引入额外复杂架构的前提下,动态平衡这两种优势信号的强度与介入时机,是实现稳定、可超越教师的蒸馏策略的关键。该问题直接关系到 RLVR 蒸馏方案能否从实验室走向大规模生产,因而在工业界和学术界均受到高度关注。
行业类比
这类似乎在自动驾驶感知模型中,将相机与LiDAR数据融合时,若不对齐两种传感器的尺度与置信度时序,反而会因传感器冲突导致错误检测——多信号源的校准始终是融合的核心。
核心洞察
- RLVR 与 OPD 的简单融合由于优势信号的幅度失配和时间失配导致熵崩塌,现有固定系数方法无法自动适应。SAF 提出对 OPD 优势进行稀疏化后接 tanh 压缩的幅度控制,以及 KL 触发预热加线性退火的时间控制,从根源上解决了两类失配,将 token 级优势融合转化为校准问题,这比单纯调权重更稳定、可解释。
- 传统在线蒸馏将学生性能锁定在教师水平以下,但 SAF 通过 temporal control 机制实现了超越教师。预热阶段逐步注入 OPD 信号引导学生学习高质量模式,退火阶段逐渐释放约束鼓励探索,这种“先跟随再超越”的调度策略使学生在 RLVR 框架下首次系统性地突破教师上限,与固定强度蒸馏的模仿范式形成鲜明对比。
方法
输入与问题定义
SAF 接收两个来自同一在线策略 rollout 的优势信号:
- RLVR 优势:由序列级可验证奖励广播到每个 token,有界且 coarse,负责探索与最终任务目标对齐的方向;
- OPD 优势:由教师模型逐 token 提供,密集但无界,负责引导分布向教师靠拢。
固定系数融合时,出现两类失配:幅度失配(OPD 优势尖峰易淹没 RLVR 信号)和时间失配(持续高强度 OPD 抑制后期探索,阻碍超越教师)。
关键模块:四阶段轻量管道
SAF 仅对 OPD 优势施加处理,四阶段可独立开关,无显著开销。
幅度控制:Sparsify-then-Compress
- Top-k% 稀疏化:每个序列仅保留 OPD 优势绝对值最大的前 k% 个 token 位置,其余置零。这滤除噪声,保留最急迫的教师指导。
- 有界 tanh 压缩:将保留后的 OPD 优势通过
tanh映射到固定区间(如[-c, c]),使之与 RLVR 优势的幅度范围匹配,消除数量级差异。
时间控制:Warm-up-then-Anneal
- KL 触发预热:训练初期,当学生与教师的 KL 散度低于阈值时,不引入 OPD 信号;一旦 KL 超过阈值,按阶梯或线性 ramp-up 逐步提升 OPD 融合强度,避免早期过度模仿。
- 线性退火:达到预设全强度步数后,OPD 融合权重线性衰减至接近零,剩余步数以 RLVR 信号为主,鼓励学生自由探索,有机会超越教师。
融合与输出
处理后的 OPD 优势与原始 RLVR 优势相加,得到稳定融合优势,直接用于策略梯度更新(如 GRPO)。框架对 RLVR 类型不敏感,可便捷替换。
与同类方法差异
现有 OPD+RLVR 方法普遍采用固定加权求和,必须手动搜索系数且无法避免熵崩溃。SAF 不依赖固定系数,通过幅度压缩和随时间衰减的权重注入,自适应平衡信号强度,首次系统性解决融合失配问题,在维持训练稳定性的同时实现 student 可以超越 teacher 的性能增益。
实验
实验设计:在七个数学推理与代码生成基准上,以 GRPO 作为 RLVR 实例,对比固定系数融合与 SAF 框架,模型为 Qwen3-1.7B/4B/8B。评估指标为总体得分,并分析训练动态、熵变化与跨规模泛化性。
关键发现:
- SAF 完全避免熵崩溃,而固定系数融合在多数设置中遭遇严重退化。
- 在所有六个模型-域设置中,SAF 总体得分提升 0.51% 至 2.70%,训练稳定性显著提高。
- 幅度控制(Sparsify-then-Compress)有效抑制 OPD 优势值的极端尖峰,时间控制(Warm-up-then-Anneal)则平衡了探索与蒸馏。
深度解读:融合 RLVR 与 OPD 时,幅度错配会淹没稀疏奖励信号,时间错配提前将学生拉向教师,阻碍超越。SAF 通过轻量级后处理管道对 OPD 优势进行重校准,不增加显著开销。这为在策略强化学习中引入稠密教师信号提供了稳定而高效的范式,尤其适用于数学与代码等需要可验证奖励的长链条任务。其模块化设计使各阶段可独立开关,便于实际部署调试。
行业影响
落地场景
SAF-OPD 提出的稳定优势融合策略,为任何需要结合可验证奖励(RLVR)与在线蒸馏(OPD)的 LLM 后训练场景提供了即插即用的训练框架。典型产品线包括:
- 代码助手与数学解题工具:利用 RLVR 提升最终答案正确率,同时用 OPD 从更强模型中继承推理风格,避免训练崩溃,直接提升生成质量。
- 企业内部知识问答系统:通过 RLVR 确保事实准确性,OPD 保持回答的结构化与流畅度,可在不增加推理成本的情况下超越教师模型。
商业价值
- 降本增效:SAF 的四阶段 pipeline(稀疏化→压缩→预热→退火)计算开销极低,无需额外模型推理或复杂超参搜索,可直接替代现有固定系数融合方案,减少反复试错的算力浪费。
- 能力突破:实验显示在 Qwen3-1.7B 到 8B 多个规模上,安全避免熵坍塌,综合得分提升 0.51–2.70%,同时训练更稳定,意味着能以更低成本训练出超越教师模型的学生模型,在商业 API 服务中降低模型尺寸和推理成本。
与现有工作流的接口
SAF 仅作用于 OPD 的优势项,与 RLVR 基座(如 GRPO)解耦,可作为轻量级插件集成到现有 RLHF/RLVR 流程中:
- 保留现有奖励信号和策略优化算法不变;
- 将 OPD 生成的 token 级优势
A_OPD输入 SAF 模块,输出修正后的A_OPD_safe; - 与 RLVR 优势简单相加或加权组合。
代码改动集中在优势计算阶段,不影响训练主循环,适合在 DeepSpeed、FSDP 等分布式训练框架中部署。
具体落地 Use Case
场景一:电商智能客服代码生成
在电商平台,客服机器人需根据用户问题生成准确的 API 调用代码。RLVR 可基于最终执行结果给出奖励,但训练不稳定;OPD 从大型代码模型中蒸馏风格,却可能限制创造性修复。SAF 融合后可稳定训练,使得中小模型生成的代码既准确又符合工程规范,直接提升自动化工单处理成功率。
场景二:全球性在线教育平台的数学批改反馈
自动批改系统需对学生的解答步骤给出详细纠正。使用 RLVR 奖励最终答案正确性,OPD 捕捉教师模型的解释风格。SAF 避免训练中熵崩溃,使小模型既能给出正确判定,又能生成 pedagogically 合理的解释,降低对昂贵教师模型 API 的依赖,实现大规模个性化反馈。
局限
- 论文仅在 Qwen3 的 1.7B、4B、8B 三个相对较小的模型规模上进行了实验,且测试任务集中在数学推理与代码生成,未在数十B参数级别的大模型或更广泛的任务(如开放域对话、翻译)上验证方法,其可扩展性与跨领域泛化能力有待进一步确认;同时,教师模型固定,SAF 框架对教师能力的依赖未讨论,学生超越教师的上限可能受到教师质量制约。
- SAF 引入了四阶段管道,每个阶段均涉及关键超参数(如稀疏化比例、tanh 压缩边界、KL 触发阈值、预热步数与退火步数等),这些参数对不同模型和任务可能需要精细调整,调参成本较高,限制了方法的即插即用性;轻量级设计虽减少了计算开销,但各阶段的有效性可能对数据分布和奖励尺度敏感,实际部署时仍需大量尝试。
- 实验对比的基线主要为固定系数融合以及纯 RLVR/OPD,未涉及更复杂的自适应融合策略(如基于梯度冲突或不确定性加权的动态权重方法),因此无法确定 SAF 相比这些动态机制是否仍有优势;同时,仅基于 GRPO 实现 RLVR,未扩展到 PPO 等其他常用策略梯度算法,融合框架在其它算法下的行为与稳定性尚不明确。