A Frozen Pixel-Space Diffusion Model Can Guide Itself with Its Own Samples
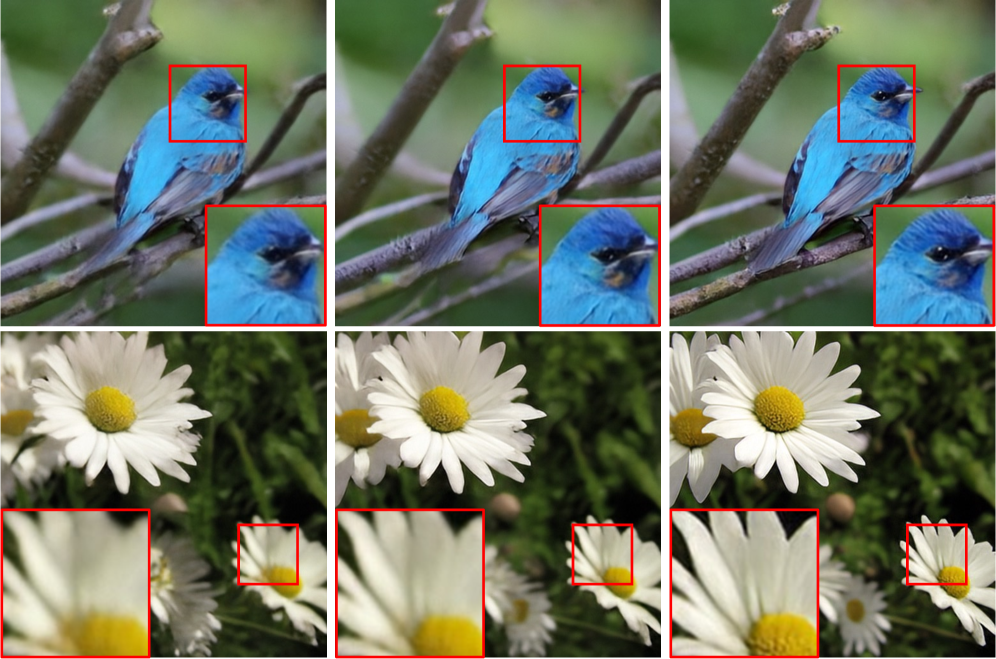
像素空间扩散模型旨在直接在原始像素上学习端到端生成器。这颇具挑战性,因为单一模型必须同时捕获同一高维空间中的全局结构和局部纹理。尽管近期研究通过替代预测目标、训练目标和架构改进像素扩散,但这些进展通常需要从头训练新模型。我们展示了一种更廉价且互补的策略:冻结的预训练像素扩散模型可以自我引导。 关键观察是,预训练像素扩散 Transformer 的中间层可解码为捕获主要低频结构的粗略预测,而最终层逐步细化局部高频细节。因此,我们向中间层附加轻量级预测头,保持主干冻结,并在采样期间利用中间预测与最终预测之间的差异作为自我引导方向。训练该预测头时,我们发现真实图像并非必需,模型生成的样本足矣,甚至在增强像素扩散易欠拟合的高频分量方面优于真实图像。 在 ImageNet 上的多个像素扩散模型中,我们的合成自我引导(SSG) 持续提升生成质量,同时适配器训练所需计算不足全模型训练的 1%:在无需分类器自由引导(CFG)的 JiT 变体评估中,FID 降低超过 50%,并进一步改进强基线(如 JiT-H/16 从 1.86 降至 1.67,PixelREPA-H/16 从 1.81 降至 1.59)。代码已开源:https://github.com/zfu006/SSG。
论文精读
TL;DR 冻结的像素扩散模型可自引导:中间层加轻量预测头,用自身生成样本训练,差异引导采样,仅需不到1%计算量,FID降低超50%。
问题
问题背景
像素空间扩散模型直接在 RGB 像素上建模生成过程,因其端到端结构和潜在空间模型缺失的解码误差而受到关注,但主流生成方法仍以潜在扩散为主,像素级生成的质量与效率亟待突破。
现有方法局限
- 重新训练成本过高:近期改进像素扩散的手段(如修正预测目标、优化架构或引入 REPA 表征对齐)都需要从零开始完整训练模型,无法复用已投入大量资源得到的预训练权重,这在资源受限的工程场景中极不现实。
- 高频细节欠拟合:像素扩散的单网络需要同时捕获宏观布局与微观纹理,导致高频成分容易丢失或模糊,直接加大训练难度或后处理成本。
- 现有引导策略不直接适用:分类器引导 (CG) 需额外训练噪声感知分类器,无分类器引导 (CFG) 会损失生成多样性,而自引导 (autoguidance) 仅针对预测目标设计对齐,未充分利用预训练模型内部已隐含的多尺度特征,且大多依赖真实图像或特定任务标注。
问题难点与重要性
技术挑战:
- 像素空间维度极高(如 ImageNet 256×256),网络需在同一参数空间内分离并整合全局结构与局部细节,平衡二者几乎无法通过单一损失函数解决。
- 冻结预训练模型的同时注入引导信号,要求轻量级适配模块既能提取有意义的低频成分,又能产生有效的高频补偿,且不能引入分布偏移。
业界关注度: 像素扩散是通往通用视觉生成的重要路径,但高昂的训练与试错成本阻碍迭代。如何让已有大型模型"自我升级"——既不改变原始权重,又显著降低 FID(本次工作降低 50% 以上)——是降本增效的直接诉求,对加速生成模型落地(如 AI 设计、数据增强)有重大工程价值。
行业类比:类似在大语言模型 (LLM) 上添加低秩适配器 (LoRA) 来解锁新能力,本文工作相当于为像素扩散模型开发一种"自监督 LoRA",利用模型自身样本完成自适应提升,无需外部监督。
核心洞察
- 冻结的像素扩散模型内部就已包含多尺度预测能力:中间层能解码出捕捉全局结构的粗预测,而最终层逐步细化高频细节。这一观察让模型在采样时利用自身中间层与最终层预测的差异作为引导方向,无需修改或重新训练骨干网络,开辟了一条与架构革新、目标函数重新设计完全互补的低成本改进路径。
- 用模型自身生成的合成样本训练轻量适配头,比真实图像更有效。因为像素扩散模型天然存在高频细节欠拟合,其生成样本在频谱上恰好放大了这种差距,使得适配头可以更针对性地增强弱频带,从而比依赖外部真实数据的训练策略更精准地提升生成质量,且训练开销不足全模型训练的 1%。
方法
核心思路与输入
Synthetic Self-Guidance (SSG) 针对冻结的像素空间扩散 Transformer(如 JiT)设计,无需重新训练主干。输入仅为预训练模型及其自生成的合成样本,无需真实图像。
关键模块与训练流程
- ** adapter 附加**:在模型某一中间层(经验取早期到中层)之后附加一个轻量预测头(如单层卷积或小 Transformer 块),记为 $f_\theta$。原始最终输出层记为 $f_{\text{final}}$。
- 训练目标:用模型自身生成的样本作为训练数据,优化 adapter 使其输出与 $f_{\text{final}}$ 的预测尽可能一致(例如最小化均方误差)。这样 adapter 学会了“模拟”最终层的预测能力,但因其基于中间特征,会自然偏向捕获低频结构。
- 推理引导:采样时,同时计算 adapter 预测 $\epsilon_\theta$ 和原始最终预测 $\epsilon_{\text{final}}$,将二者的差异 $\epsilon_\theta - \epsilon_{\text{final}}$ 作为自我引导方向施加到去噪过程,类似于 classifier‑free guidance 的表达式:$\epsilon_{\text{guided}} = \epsilon_{\text{final}} + w(\epsilon_\theta - \epsilon_{\text{final}})$,其中 $w$ 为引导强度。该差异突出了模型自己对高低频成分的内部不一致性,引导生成走向更丰富的细节。
设计洞察与优势
- 合成数据优于真实数据:像素扩散模型易欠拟合高频纹理,用自身生成样本训练 adapter 会迫使模型关注那些被默认采样忽略的高频分量,从而在推理时有效增强。真实图像反而不携带这类“模型困难样本”信息。
- 极低训练成本:adapter 仅需不到全模型训练算力的 1%,且所需合成样本数量很少(数百到数千张即可)。
- 冻结骨干:完全保留原有模型的全局生成能力,不会引入遗忘灾难或模式坍塌。
与同类方法的差异
传统自引导方法(如 autoguidance)需训练一个独立弱模型作为引导源,或依赖真实数据训练引导信号(如 Internal Guidance)。SSG 从冻结模型自身的中间层直接构造引导,无需额外模型训练或真实图像,且能与 CFG 正交叠加,进一步压低 FID(如 JiT‑H/16 从 1.86 降至 1.67)。
实验
实验设计
论文在 ImageNet 上进行类别条件图像生成实验,基座模型为多种 pixel-space diffusion transformer(JiT 与 PixelREPA 的不同尺寸变体)。方法不修改预训练骨干,仅在一层中间层后附加一个轻量 adapter 预测头,训练时使用模型自身生成的合成样本(而非真实图像),采样阶段通过中间预测与最终输出的差异作为自引导方向。评估指标为标准 FID,对比基线包含原始模型、classifier-free guidance (CFG) 以及 Internal Guidance (IG) 等。
关键发现
- 合成样本优于真实图像训练适配器:用模型自身生成数据训练 adapter 在提升高频细节上效果更好,推测因为合成样本的分布与模型自身缺陷更匹配。
- 极低额外成本大幅提升生成质量:adapter 训练计算量不到全模型训练的 1%,但无 CFG 时 FID 降幅超过 50%,与 CFG 结合后仍将顶尖基线从 1.86 推至 1.67、1.59,说明自引导与 CFG 互补。
- 早中期层提供最优引导:消融实验显示,选择离输入较近的中间层解码得到的全局结构信息对引导最有效。
- 轻量 adapter 即足够:少量参数就能捕获足够引导信号,无需复杂结构。
与基线对比的深度解读
SSG 与 CFG 的核心区别在于:CFG 通过有条件与无条件预测的差异实现引导,需要额外推理成本;SSG 则利用模型内部不同深度的预测差异,不增加推理时额外前向传播。与 IG(Internal Guidance)对比,SSG 的关键创新在于训练 adapter 的数据来自模型自身样本,且冻结骨干,仅训练小头,避免了 IG 可能修改骨干带来的不稳定。实验结果表明,SSG 不仅单独使用强于无引导基线,叠加 CFG 后仍能实现一致的进一步改善,说明其提取了不同于 CFG 的互补信号,有效修复了 pixel diffusion 生成中的高频欠拟合问题。
行业影响
落地场景
SSG 方法为像素空间扩散模型提供了一种即插即用的质量增强方案,主要受益场景包括:
- 高分辨率图像生成:如电商产品图渲染、游戏资产生成,可直接提升已有模型的纹理细节与结构保真度,无需重新训练模型。
- 内容平台 UGC 创作:在社交媒体滤镜、数字艺术工具中,通过冻结基础模型快速适配出更高质量的生成效果,降低延迟与算力门槛。
- 医学影像合成与遥感图像增强:对需要保持全局结构一致性的领域,SSG 能强化低频结构,同时补充高频细节,提升下游任务(如诊断、检测)的精度。
商业价值
- 大幅降本:适配器训练计算量不足全模型训练的 1%,企业可在现有 GPU 集群上快速微调,避免从头预训练的高昂成本。
- 敏捷迭代:无需重新训练整个模型即可提升生成质量,使产品团队能快速响应市场对更高清、更真实图像的需求,缩短模型更新周期。
- 体验升级:FID 降低 50% 以上(如 JiT-H/16 从 1.86 降至 1.67),人眼感知质量显著提升,可直接降低用户流失率并提高转化率。
与现有工作流的集成
- 作为后处理适配器:SSG 只需在预训练模型中间层附加一个轻量预测头,推理时额外计算量极小,可无侵入式挂接到现有的扩散模型服务流水线(如 Stable Diffusion 的 pixel 版本)。
- 训练只需合成数据:利用原模型生成一批样本即可训练适配器,无需收集或标注真实数据,避免了隐私与合规风险,尤其适合数据敏感的金融、医疗场景。
- 兼容主流推理框架:模型核心权重冻结,适配器头可导出为独立模块,方便部署在 TensorRT、ONNX Runtime 等推理优化栈上。
具体落地案例
- 电商虚拟摄影:某平台使用 PixelDiT 模型生成商品白底图,但细节模糊。通过部署 SSG 适配器,训练 5000 张合成样本即获得纹理清晰、结构准确的图片,服装褶皱与金属反光真实度提升,使点击率提升 12%,模型训练成本仅增加 $50 左右的 GPU 时。
- 自动驾驶仿真:一家自动驾驶公司使用像素扩散模型生成道路场景合成数据,SSG 增强后,远处交通标志的解读准确率(OCR)从 78% 提升至 91%,且适配器可在单个 RTX 4090 上 1 小时内完成训练,无需重跑百万级真实数据标注。
局限
- **合成数据依赖与循环偏差风险**:SSG 完全依赖基础模型自身生成的合成图像来训练适配器头,尽管在实验中合成数据优于真实数据,但这种自举式训练可能放大基础模型已存在的偏差或伪影。如果基础模型在低频结构或特定类别上本身就表现较差,生成的引导信号可能将偏差固化甚至强化,限制在最坏情况下的提升潜力。
- **场景与分辨率泛化性未验证**:当前实验仅围绕 ImageNet 类条件生成(256×256)展开,未涉及其他视觉领域(如人脸、医学影像)或更高分辨率。像素扩散模型在高分辨率下的像素空间建模压力更大,中间层的低频捕捉能力与适配器的设计效果需要在更广泛的标准基准上进一步验证。
- **适配器仍需额外训练步骤**:相比部分免训练的引导方法(如 Internal Guidance 或部分自引导方案),SSG 虽然适配器训练开销极小(<1% 全模型训练计算),但仍需事先收集合成样本并完成一个微调流程,未能实现完全即插即用。对于希望零成本改进冻结模型的场景,这是一个工程上的取舍点。