ExtractBench: 面向模式引导企业文档提取的基准测试
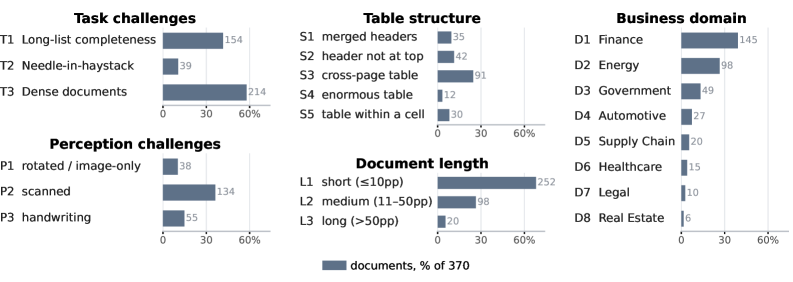
企业工作流日益依赖智能体进行模式引导提取:给定文档和用户定义的模式,智能体需忠实遵循模式,生成正确输出,并以源证据作为溯源元数据。我们提出 ExtractBench,这是首个同时评估数值准确率、大规模记录完整性、溯源性及测量成本的模式引导提取基准。 评估系统包含 370 份企业文档 中的 4,869 页,覆盖 8 个业务领域 和 67 种文档类型,并带有清晰标注以区分挑战场景。可扩展的模式与真值构建流程结合了独立系统对真实文档的一致性、合成列表的已知值以及人工对表单的验证。 我们报告顺序无关的数值 F1 用于评估数值准确率,并采用两种溯源性指标(词级和页级 F1)衡量源头可追溯性。商业 VLM 在短文档上表现良好,但在长文档上常常截断记录列表;而编码智能体虽准确率更高,但成本显著增加。LlamaExtract Agentic Plus 在所有三项指标上均排名第一,其准确率与编码智能体相当,但成本仅为后者的极小部分。 数据集与评估代码已公开:https://huggingface.co/datasets/llamaindex/ExtractBench{HuggingFace} 和 https://github.com/run-llama/ExtractBench{GitHub}。
论文精读
TL;DR ExtractBench 首次同时评估企业文档模式引导提取的值准确性、记录完整性与来源 grounding 及成本,通过跨 8 领域 4,869 页基准揭示编码代理准确但昂贵,而 LlamaExtract Agentic Plus 以更低成本达到同等准确性。
问题
问题背景
企业自动化流程中,智能体(agent)执行模式引导的文档提取(schema-guided extraction)的需求日益增长:根据用户定义的输出模式,从异构文档中精确提取结构化字段,并提供溯源证据(grounding evidence)作为元数据。
现有方法的局限
过往基准(如 SROIE、DocILE)多聚焦固定本体(fixed-ontology)的信息提取,评价指标单一(仅值准确率),忽视以下关键维度:
- 记录完整性:长文档中列表字段经常被截断,已有评测未覆盖逐条完整性。
- 溯源准确度:词级/页级溯源(word-/page-level grounding)未纳入评分,难以验证模型是否“读懂”原文。
- 成本与质量平衡:商用 VLM 在短文档上表现良好,但长文档上常出现记录列表截断;编码智能体准确率更高但成本剧增,现有基准未提供统一的成本-质量前沿分析。
- 多领域与挑战场景覆盖:缺乏对手写扫描件、退化重摄文档、密集表格等多维度感知挑战的系统性标注。
难点与重要性
真实企业文档存在格式剧变、长尾表格、视觉退化等问题,模式往往随业务需求动态改变。现有系统在长文档序列截断、大模式吞吐和低成本高精度三者间的折中缺乏量化标尺。业界需要一个能同时衡量值准确率、记录完整性、溯源可靠性和推理成本的基准,否则模型选型与工程落地决策如同“盲飞”。
行业类比
类似于从海量合同、财报或医疗记录中按需提取关键条款与数值,任何结构化信息提取系统若不能可靠溯源并控制成本,便无法从实验走向生成式 AI 应用的生产环境。
核心洞察
- ExtractBench是首个同时评估抽取准确率、记录完整性、溯源证据和计算成本的文档抽取基准。之前的工作如SROIE、DocILE只关注固定本体的准确率,忽略了实际部署中成本与完整性验证,而ExtractBench通过引入array alignment和缺失值语义,实现了对复杂嵌套字段和长列表的全面评测。
- 该基准独创性地提出了word-level和page-level的grounding F1指标,强制要求模型提供输出值的页面和文本来源。这种对溯源(grounding)的显式评分,直接对应企业场景中审计和纠错的需求,且揭示了当前许多模型虽然输出正确但无法提供可靠来源的“grounding gap”。
- 实验系统比较了VLM、编码代理和专用提取服务在成本-质量前沿上的表现,发现商业VLM在长文档上普遍存在列表截断,导致高精度但低召回;而LLamaExtract Agentic Plus以极低代价达到编码代理的水平,为实际选型提供了量化决策依据。
方法
整体流程
ExtractBench 针对 schema-guided extraction 任务构建端到端评测管道,流程如下:
- 输入:原始文档(PDF / 扫描件)与用户定义的 schema(指定需提取的字段结构及数据类型)。
- 关键模块:
- 语料构建:混合三类数据源——真实企业文档(标注由多系统共识 + 人工校验生成 ground truth)、合成长列表(注入已知值以自动校验)和扫描表单(经五阶段人工标注与裁决)。所有文档按业务领域、文档类型、感知挑战(如手写、表格)、文档长度等维度标记。
- 评估指标:采用 order-insensitive value F1 衡量字段值准确率;引入 word-level 与 page-level grounding F1 评估提取证据的定位精度;同时记录 token 消耗成本,形成质量-成本分析。
- 提取系统标准化:评测覆盖三类方法——视觉语言模型(VLM)、coding agents(可生成并执行代码)和专用文档提取 API,统一配置 API 调用与自托管环境。
- 输出:每系统输出的结构化记录与 ground truth 对齐,计算 值准确率、记录完整性、grounding 召回/精度、归一化成本,生成多维度排名与失败模式分析(如长文档截断、大 schema 管道崩溃)。
与同类基准的关键差异
ExtractBench 是首个在统一框架下同时量化 值级 F1、大规模记录完整性、证据接地精度与实测成本 的评测集,并覆盖 67 种文档类型、8 个业务领域的真实企业长尾分布。
实验
实验设计
- 数据集:ExtractBench,含 4,869 页、370 个企业文档,覆盖 8 个业务领域、67 种文档类型,按文档长度(短/中/长)、任务难度(密集文档、针-干草堆、长列表完整性)、感知挑战(扫描/手写)和表格结构划分子集。
- 评估系统:商业 VLM(如 GPT-4V、Gemini)、编码代理(coding agents)、专用提取 API(LlamaExtract Agentic Plus)。
- 指标:顺序不敏感的 value F1(值准确率)、word-level 及 page-level grounding F1(证据定位)、成本(token 计费或 API 定价)。
关键发现
- 商业 VLM 在短文档上表现优秀,但长文档上常截断记录列表,错过大量字段。
- 编码代理通过代码生成保持高准确率和记录完整性,然而推理成本远高于 VLM。
- LlamaExtract Agentic Plus 在所有三个指标上均排名第一,准确率与编码代理相当,成本仅为其一小部分。
- 存在“接地缺口”:部分系统输出正确答案,但无法提供可靠的源证据(word-/page-level 定位不准)。
与基线对比解读
- 相较固定本体提取基准(SROIE、DocILE),ExtractBench 首次在规模上结合值准确、记录完整、接地与成本四个维度,填补了模式引导提取评估的空白。
- 商业 VLM 在成本与接地能力上优于传统 KIE 方法,但长文档场景暴露上下文窗口限制;编码代理以高计算开销换取精度,实际部署时不经济。
- 专用提取系统 LlamaExtract Agentic Plus 在成本–质量前沿上最优,证明面向企业文档的任务感知流程优化能有效平衡准确度与资源消耗,为生产环境提供更实用的选择。
行业影响
落地场景
ExtractBench 瞄准的关键场景是基于用户定义 schema 的文档提取:企业文档(合同、发票、报告、表单等)按需抽取结构化字段,并提供原文依据(grounding)。典型应用包括:
- 金融 / 保险:贷款申请材料自动录入、理赔单据关键信息提取
- 医疗:检验报告、病历的结构化归档
- 供应链:采购订单、物流单据的自动识别与 ERP 对接
- 企业服务:合同条款比对、合规审查证据链自动生成
商业价值
该基准直接量化了三项与业务强相关的指标:
- 值准确率(value accuracy):减少因为提取错误导致的人工复核成本
- 记录完整性(record completeness):避免长列表截断带来的数据漏损,对财务报表、物料清单等场景尤为关键
- 溯源能力(grounding):满足审计与合规要求,提取结果可直接定位到原始文档的页码或词级位置,显著降低合规风险
同时还引入了成本维度,帮助企业在精度与 API 开销之间找到经济最优解。例如,实验显示商业 VLM 在短文档上成本低但长列表容易截断,而编码代理准确但费用高昂;LlamaExtract Agentic Plus 以更低成本达到相近精度,适合大规模部署。
与现有产品 / 工作流的接口
ExtractBench 的评估框架可直接嵌入文档 AI 平台或 RPA 流程:
- 作为模型选择或 prompt 调优的离线评测工具
- 与现有文档处理 pipeline(如 OCR → NER → 结构化输出)对接,增加 schema adherence 和 grounding 模块
- 其标注流水线(模型互验 + 人工校验)可复用于企业私有文档类型的训练数据构建
具体应用案例
- 电商平台发票核对:从供应商上传的扫描发票中按自定义 schema 提取商品明细、税率、总价,并与采购订单自动比对,grounding 能力可定位每一金额的原始位置,快速解决差异。
- 跨国企业合同管理:需从不同语言、格式的合同中抽取条款要点(违约金、管辖法院等)。利用 schema-guided 提取,结合基准中覆盖的多类文档格式,可快速评估并选择适合的模型,降低跨法域合规成本。
局限
- **场景覆盖度有限**:基准涵盖 8 个业务领域与 67 种文档类型,但仍无法穷举所有企业文档的复杂情况(如嵌套表格、多页跨页结构或高度非结构化文本)。评估中记录完整性仅检查列表是否完整,对层次化或嵌套信息的完整性缺乏细粒度度量。此外,基准主要面向英文文档,未涉及多语言与跨语言抽取,而真实跨国企业常需处理多语言文档。
- **标注流水线引入偏差**:真实文档的 ground truth 依赖独立系统的一致性判断,可能继承已有系统的偏见;合成长列表虽可控制 ground truth,但其生成分布可能与真实数据中的不规则性(如不连续编号、重复条目)存在差异。扫描表单的众包验证也存在主观性与标注重叠度不足的风险,最终标注质量可能影响评估结果的可信度。
- **成本评估维度单一**:成本计算基于 API 调用(token 计价)或托管服务费用,未考虑本地部署的硬件成本、推理延迟或人工 post-processing 开销。对于需要高吞吐的生产环境,成本模型可能失真,且未区分一次性成本与持续使用成本,限制了对工业化落地经济性的指导意义。