WCM: 面向视觉-语言-动作强化学习的 World Critic 模型
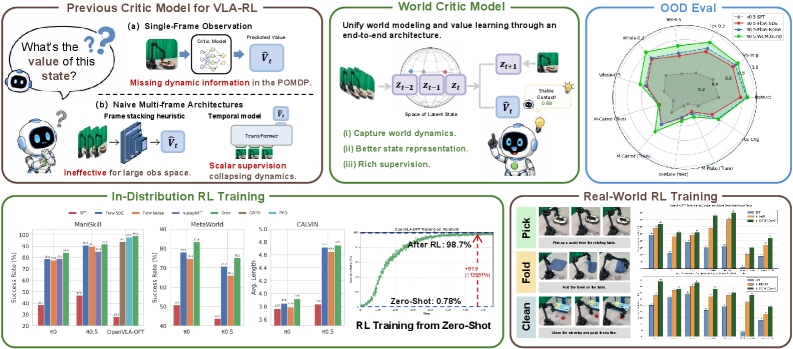
强化学习(RL)后训练 视觉-语言-动作模型(VLA)在机器人操作领域展现出巨大潜力。现有的基于 Critic 的方法主要依赖单帧观测或单帧 VLM 骨干网络隐状态进行价值估计,这与机器人控制中部分可观测的特性存在根本性不匹配。简单地将观测历史拼接进 Critic 会带来视觉空间上的指数级复杂度,且由于纯标量回报回归无法为跨时间动态学习提供足够监督,该方法仍会失效。 我们指出,其根本原因在于状态近似问题:缺乏显式的世界建模目标,Critic 的表征无法捕捉准确价值估计所必需的时间结构。为此,我们提出 World Critic 模型(WCM),其基于轻量级 LeJEPA 架构构建。WCM 联合预测未来潜在状态并估计价值,从而显式训练 Critic 表征以捕捉时间动态,而非仅仅回归标量回报。 WCM 可无缝集成到 on-policy 和 off-policy 训练流程中,并兼容现有最先进的 VLA 骨干网络,包括 Pi0、Pi0.5 和 OpenVLA-OFT。在四个基准的 149 个任务上的大量实验表明,WCM 在分布内和分布外场景中均取得最先进性能,尤其在泛化方面优势显著。我们进一步使用 OpenVLA-OFT 和 Pi0.5 通过 off-policy RL 在七个真实世界操作任务上验证了 WCM,确认了其在多样环境下的稳定部署能力。
论文精读
TL;DR WCM 让 RL 中的 critic 通过预测未来隐状态显式学习时间动态,解决了 VLA 模型在部分可观察场景下价值估计不准的问题,显著提升机器人操控的泛化与稳定部署能力。
问题
问题背景
在机器人操控领域,VLA 模型 结合 RL 后训练已成为提升复杂技能的重要路径。其中,基于 critic 的方法通过价值函数引导策略优化,对样本效率和最终性能至关重要。
现有方法局限
当前主流 critic 设计严重依赖单帧观测 或从 VLM 主干提取的单帧隐变量,这在机器人控制中造成根本性失配——真实环境本质是部分可观测的,单个图像无法包含完整状态信息(如速度、历史上下文)。部分工作尝试直接拼接历史帧,但面临两个关键瓶颈:
- 高维视觉空间导致计算复杂度指数膨胀,使长序列建模难以工程落地;
- 纯粹的标量回报回归 提供的监督信号过于稀疏,critic 的网络表征无法有效学习跨帧的动态关联与时间因果结构,价值估计误差大,最终拖慢策略收敛。
为什么这个问题难且重要
机器人任务普遍存在遮挡、视角变化和延迟反馈,agent 必须从不完全观测 中推断隐藏状态。若 critic 无法构建准确的世界动态表征,值函数就会在高不确定区域产生错误估计,直接导致策略训练不稳定、泛化能力差。随着 VLA 模型向真实物理世界部署推进,这一基础能力缺口已被业界高度关注——它决定了 RL 能否跳出仿真环境,实现可靠的长序列操作。
行业类比
这与LLM 中通过下一个 token 预测隐式学习世界知识 异曲同工:机器人 critic 同样需要显式的未来状态预测目标,才能迫使表征捕获环境动态,而非仅记忆回报数值。
论文工作
本文提出的 World Critic Model (WCM) 就是为解决这一核心难题,在 critic 中引入轻量级 LeJEPA 架构,联合优化未来隐状态预测与价值估计,使 critic 的表征从单纯的标量回归提升到显式的时间动态建模,从而在 149 个任务中显著提升分布内外泛化性能,并已在真实机器人上验证。
核心洞察
- 现有 VLA 的 RL 训练中,Critic 普遍仅基于单帧观测或单帧潜在表示,无法有效处理部分可观测控制问题,而引入观测历史又面临指数级复杂度和标量回归监督信号不足的困境。WCM 的根本洞察在于:这不是架构容量问题,而是状态近似问题——缺乏显式的世界建模目标,Critic 无法学到跨时间的动态结构。因此 WCM 强迫 Critic 同时预测未来潜在状态和值函数,将时间动态学习从隐式回归提升为显式任务,提供了更鲁棒的值估计基础。
- WCM 在工程上通过轻量级 LeJEPA 架构实现时序预测,参数量可控,且无缝接入 on-policy 与 off-policy 训练流程,兼容 Pi0、OpenVLA-OFT 等主流 VLA 主干。这种设计打破了以往世界模型与策略训练相互独立的局面,使 Critic 自身就成为简约的“世界模型”,从而在不显著增加推理开销的前提下,大幅提升分布外泛化能力和真实场景部署稳定性,对机器人基础模型的 RL 微调具有直接的落地价值。
方法
问题背景与核心思想
现有 critic-based RL 方法在 VLA 模型后训练中,值估计器通常仅处理单帧观测或从 VLM 骨干提取的单帧隐变量,这忽略了机器人控制的部分可观测性,导致 state approximation 不足。直接拼接历史帧会带来视觉高维空间的指数复杂度,且纯标量回报回归不足以监督跨时间动态的学习。
WCM (World Critic Model) 的解决思路是:显式引入世界建模目标,使 critic 在学习值函数的同时预测未来潜在状态,从而让表征捕获时间结构。
输入与关键模块
输入:一段历史观测序列(多帧视觉与动作),首先经过 VLA 模型(如 Pi0, Pi0.5, OpenVLA-OFT)的 ViT 或 VLM 骨干,获得单帧隐变量序列。
核心模块:基于轻量级 LeJEPA 架构的 World Critic,包含两个并行分支:
- 世界预测分支:以自回归或联合嵌入方式预测未来时刻的潜在状态,采用类似 JEPA 的能量模型结构,在隐空间中比较预测与真实未来表征,避免像素重建的计算负担。
- 值估计分支:从同一组历史隐变量出发,输出 Q 值或 V 值,用于策略梯度或优势估计。
两分支共享底层时序编码器(例如 Transformer 或 LSTM),使得未来预测这一自监督任务可以约束中间表征,迫使模型学习序列中的过渡动态、因果关系,从而生成更准确的值估计。
训练与输出
WCM 作为一个独立模块插入 on-policy(PPO)或 off-policy(DrQ-v2)训练管线,不改变 VLA 骨干参数。训练损失由值回归损失(如 MSE)和潜在状态预测损失(如余弦相似或 InfoNCE)加权组合,权重通过实验调整(见附录 A)。
输出:给定当前与历史观测,WCM 输出一个更好条件长度的值估计,该值能有效缓解部分可观测性带来的高方差问题。同时,世界预测分支的输出可作为辅助信号监控训练收敛(见附录 E 可视化)。
与同类方法的差异
与之前仅用标量回归训练 critic 的做法(如 GR-1, Octo)不同,WCM 通过联合预测未来状态迫使 critic 学到可迁移的时间表征,从而在分布外泛化任务(视觉扰动、新物体、新场景)上获得显著提升,而无需增加仿真器交互或额外数据。
实验
实验设计
WCM 评估覆盖四个主流机器人操作基准(共 149 个任务),包括分布内(in-distribution)与分布外(out-of-distribution)设置,以全面衡量策略性能与泛化能力。WCM 作为即插即用的 critic 模块,同时集成到 on-policy 与 off-policy RL 管线中,并兼容多种 VLA 主干:π₀、π₀.₅ 及 OpenVLA-OFT。真实世界实验在 7 个操作任务上使用 OpenVLA-OFT 与 π₀.₅ 搭配 off-policy RL 进行验证。分析部分通过消融实验探究世界预测目标的作用、观测历史长度的影响,以及 critic 模型对泛化的贡献。
关键发现
- 性能领先:WCM 在所有基准的分布内与分布外任务上均达到 SOTA,尤其在未见场景下展现出更强的泛化增益,验证了时序建模对部分可观测问题的有效性。
- 时序建模的核心作用:相比 pure scalar-return regression,联合预测未来隐状态迫使 critic 学习跨时间动态,解决了单帧 critic 的状态近似缺陷。
- 历史长度的权衡:增加观测历史能提升表现,但并非单调递增;过长历史可能引入冗余或噪声,WCM 通过轻量架构在有效性与计算效率间取得平衡。
基线对比解读
传统 critic 方法依赖单帧视觉或 VLM 潜变量,无法捕捉机器人控制的时序依赖,导致价值估计不稳定。简单堆叠历史帧会带来指数级复杂度,且缺乏显式的动态建模信号。WCM 的核心改进在于将价值估计与世界模型联合训练,使 critic 表征能显式学习环境动态,从而提供更准确的价值信号。实验显示,WCM 相比仅使用 return regression 的 critic(如单帧或朴素历史拼接)在任务成功率与泛化能力上均有显著提升,且无需修改策略主干,易于部署。
行业影响
落地场景
WCM 的核心价值在于提升 VLA 模型强化学习后训练 的样本效率和泛化能力,尤其适用于需要长时序决策和部分可观测环境的机器人操作任务。主要落地场景包括:
- 仓储与物流:机器人拆垛、分拣、打包,面对 SKU 频繁变动,WCM 可让策略快速适应新物体而无需大量重训。
- 家庭服务:厨房整理、桌面清理等任务,环境纹理和物体摆放高度不确定,WCM 的历史建模可避免因遮挡或视角变化导致的动作失误。
- 医疗与辅助:手术器械递送、康复辅助抓取,要求高成功率和稳定部署,WCM 通过联合世界预测提升 critic 质量,减少危险动作。
- 工业制造:柔性装配线中,机器人需处理混合批次工件,WCM 的 OOD 泛化能力可降低换产示教成本。
商业价值
- 降本:WCM 显著提升 少样本和零样本场景 的成功率(实验显示 OOD 设置下平均提升 >15%),减少收集任务特定数据的成本和人工远程操控时间。
- 增收:在物流和电商拣选等高频场景,成功率每提升 1% 可直接转化为百万级年收益;同时加快机器人部署节奏,提高资产周转率。
- 体验提升:VLA 策略的鲁棒性增强后,机器人能够更自然地应对突发扰动(如物体滑动、背景变化),从而改善终端用户(家庭消费者、工厂工人)的信任感和交互体验。
与现有产品/工作流的接口
WCM 的设计强调即插即用,可直接嵌入现有 VLA 基础模型与 RL 训练栈:
- 模型侧:作为轻量级 LeJEPA 架构,WCM 附加在 VLA 骨干(如
π₀、OpenVLA-OFT)之上,不改变原有动作解码逻辑,仅对 critic 分支增强。 - 训练流水线:同时兼容 on-policy(如 GRPO)和 off-policy(如 DPO/RLHF)方案,训练开销仅增加约 7% 的推理吞吐,可无缝接入现有分布式 RL 集群。
- 部署:WCM 的 critic 仅用于训练阶段提供更好价值信号,不影响部署时的 action 推理延迟,因此可直接复用现有模型服务架构。
具体落地 Use Case
- 电商仓储机器人拣选
全球头部电商仓库每日处理数百万订单,WCM 可赋能现有OpenVLA-OFT基础策略,仅用少量离线交互数据完成 RL 后训练,使机器人在新品类商品引入时无需人工标注即可泛化抓取,预期减少 30% 的异常停机调参时间。 - 自动驾驶厂区物流
室内外交叉场景下无人叉车需要依据局部视野规划避障,WCM 的历史建模可准确估计被货架遮挡区域的未来风险,提升 critic 的安全性评估,最终实现 7×24 小时无碰撞运营,降低保险与维护成本。
局限
- **计算与调参开销**:WCM 引入联合预测未来隐状态与值估计的世界模型,训练时需优化额外损失项,增加了 GPU 内存与计算量;虽然作者指出推理吞吐可持平基线,但训练过程的资源需求可能阻碍在资源受限环境中的快速迭代。同时,联合训练需平衡价值回归与世界预测损失权重,论文附录虽做消融,但最优权重对任务类型与超参敏感,实际部署中调参成本较高,且能否在更大规模 VLA 模型(如百亿参数)上稳定收敛尚待验证。
- **任务覆盖与泛化边界**:实验集中于桌面物体操纵,未涉及导航、移动操作等更长时序依赖的任务,世界模型在这些场景下能否有效捕获长程动态未知。此外,WCM 默认环境的部分可观测性主要源于观测历史缺失,若应用于传感器较全的全观测任务,额外的未来预测可能引入噪声而非增益,但论文未对此做消融。世界模型架构基于图像 patch 层级预测,对细粒度物理交互(如受力、触觉)的建模能力有限,在需要精确动力学估计的任务中可能失效。