RecHarness:一种用于自进化推荐系统的老虎机路由代理式框架
现代推荐模型的优化仍高度依赖工程师手动迭代架构、目标函数和训练策略。基于 LLM 的智能体虽可自动化这一试错过程,但若让 LLM 同时负责选择修改方向和生成具体假设,往往在有限的实验预算下导致搜索不稳定。为此,我们提出 RecHarness,一种老虎机路由代理式框架,用于自动化推荐模型优化。 RecHarness 将优化过程分为两步:老虎机路由器根据历史验证反馈选择下一个修改方向,而 LLM 在该方向内生成具体的优化假设和可执行的代码编辑。为支持长期探索,RecHarness 引入跳盆机制,当局部编辑陷入停滞时激活结构跳跃臂。 在多个推荐任务、数据集和模型骨干上,RecHarness 相比 LLM 推理搜索 实现了更稳定的性能提升,并更有效地利用有限的试验预算。在大型短视频广告平台进行的 7 天线上 A/B 测试中,所选候选方案使 ADVV 提升 2.084%、Revenue 提升 0.534%、Exposure 提升 0.559%。代码已开源:https://github.com/6lyc/RecHarness。
论文精读
TL;DR RecHarness 将推荐模型自动优化解耦为 bandit 路由的方向选择与 LLM 的具体假设生成,引入 jump-basin 机制突破局部停滞,在有限实验预算下实现更稳定的离线提升,并在在线短视频广告场景取得 2%+ 的 ADVV 提升。
问题
问题背景
现代推荐系统模型的优化仍然严重依赖工程师手动调整架构、目标函数和训练策略。尽管基于 LLM 的 ML 工程智能体 (MLE agents) 已能自动化模型开发,但在推荐场景中如何稳定、高效地搜索最优模型变体仍是一个开放问题。
现有方法局限
已有的 LLM 驱动 MLE 智能体 (如 GPT-Engineer、AgentCoder、Reasoning-as-Gradient 等) 通常将优化视为代码搜索问题,让 LLM 同时承担两个角色:
- 方向选择:决定下一步修改哪个维度(例如调整损失函数、引入新特征交互);
- 具体生成:产出对应的代码变更与超参数。
这种“端到端由 LLM 推理搜索”的方式在实验预算有限时暴露明显缺陷:
- 探索不稳定:LLM 的生成具有随机性,容易在狭小区域反复振荡,浪费宝贵的试错机会;
- 缺乏长期规划:无法在局部优化停滞时自动切换到结构性改动(如更换底层架构),导致搜索提前收敛;
- 反馈利用低效:仅依赖验证分数,未充分利用历史实验轨迹的统计信息,没有显式的探索-利用平衡机制。
为什么这个问题难且重要
推荐模型优化的搜索空间极高维且耦合复杂,一次在线实验的成本高昂(尤其在广告、短视频等大规模平台),而离线指标与线上效果之间存在 评估偏差。因此,业界亟需一种既节省实验预算、又能保证搜索稳定性和最终效果的自动化方法。
技术挑战包括:
- 如何在多轮试验中合理分配有限的试错次数(预算约束);
- 如何将离线验证信号转换为可靠的在线性能提升(泛化性问题);
- 如何让自动化系统既能精细打磨局部细节,又能跳出局部最优进行大胆的结构探索(探索深度与广度的均衡)。
行业类比
这一问题类似于 AI 代码生成 中,若让 LLM 同时设计整体架构和逐行实现细节,常因高层规划缺位而产生不可靠的结果;而分离“规划器”(决定修改什么)与“实现器”(生成具体代码)的策略,已在如 OpenAI Codex + 规划模块 等系统中表现出更高的稳定性和任务成功率。
核心洞察
- 将推荐模型优化分解为方向选择和假设生成两步,用 Bandit 路由器基于历史验证反馈动态决定修改方向,再由 LLM 在固定方向内生成具体编辑。这与让 LLM 同时负责方向决策和代码生成的端到端方案形成对比:后者全局搜索空间过大,在有限试验预算下容易陷入不稳定、高方差搜索;而分离式架构将探索-利用平衡交给统计高效的 Bandit 算法,LLM 专注于局部假设生成,从而在相同预算内获得更稳定且一致的性能提升。
- 通过 jump-basin 机制检测优化停滞并激活结构跳跃臂,使系统在局部搜索饱和时自动切换到更大跨度的修改方向,例如改变模型主干或训练策略,而非陷入局部细节微调。相比之下,现有 LLM 驱动搜索通常缺乏显式的停滞检测和全局重启动策略,长期探索能力不足;RecHarness 将这种 basin-aware jump 与 Bandit 的 Thompson 采样结合,形成自我演化闭环,确保在长期迭代中保持有效探索,在线 A/B 测试验证了其对关键业务指标的显著提升。
方法
方法概览
RecHarness 将推荐模型的自动优化建模为一个多臂赌博机问题,把不同的修改方向(例如:调整网络结构、损失函数、训练策略)视为可选的动作/手臂。系统由两个核心组件构成:Bandit Router 和 LLM 代码生成器。
工作流程
- 初始化:给定初始推荐模型代码仓库、训练数据及验证指标。
- 方向选择:每一轮试次,Bandit Router 根据各方向的历史验证反馈(奖励),使用 Thompson Sampling 在探索与利用之间动态平衡,输出本轮应尝试的修改方向。
- 假设生成:LLM 接收所选方向、当前代码快照及近期验证结果,生成一个具体的优化假设(例如“在多头注意力后增加残差连接”)连同对应的可执行代码编辑。
- 执行与评估:自动运行实验,获得验证指标作为奖励,并以此更新 Bandit Router 中该方向的后验分布。
- 长期探索机制:当模型性能在连续多轮中不再提升时,Jump-Basin 模块激活一个Structural-Jump 手臂,引导 LLM 提出更大尺度的架构变更(例如新增特征交叉层或注意力模块),以跳出局部最优。跳跃后若指标改善,可进一步触发超参数重调优。
关键设计
- 双阶段分离:Router 负责战略级方向选择,LLM 专注战术级代码生成,避免让单一 LLM 同时决策方向与细节所导致的不稳定搜索。
- Jump-Basin:通过停滞检测与结构性改造提案,维持长周期探索效率。
与直接的 LLM 推理搜索(让 LLM 一次性生成候选分支并自我评估)相比,RecHarness 将探索控制权外化给可严格计算探索‑利用均衡的 Bandit 算法,在有限试验预算下实现更稳定、可复现的自动优化。
实验
实验设计
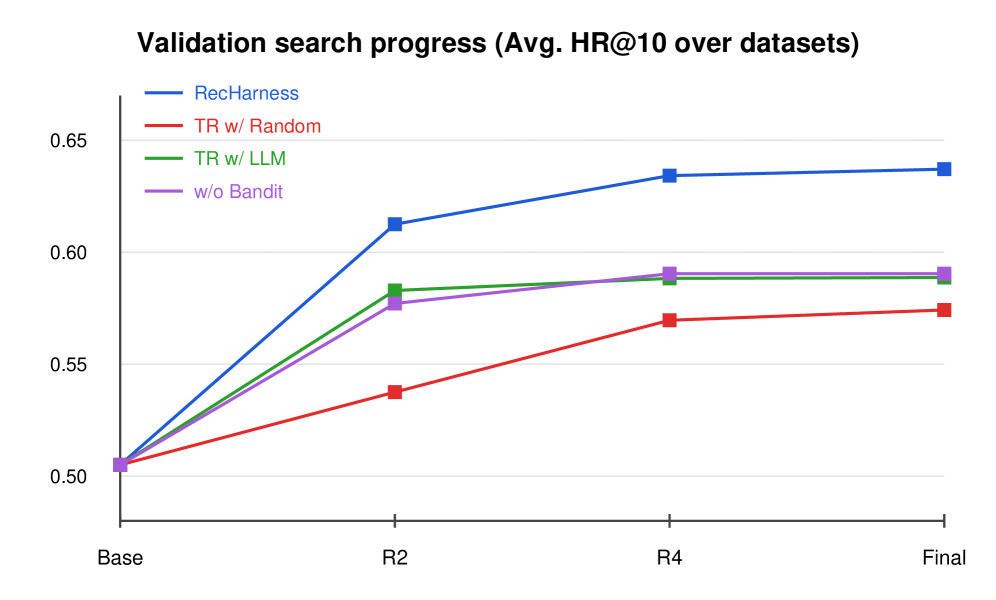
RecHarness 在多个推荐任务、数据集及模型骨干(如 DeepFM, DCN 等)上进行了离线评估,对比基线为基于 LLM 推理搜索(LLM-reasoning search)的自动化优化方法。同时,在大型短视频广告平台执行了为期 7 天的在线 A/B 测试,核心观察指标为 ADVV、Revenue 与 Exposure。消融实验独立验证了 bandit 路由 与 跳跃盆地机制 的贡献。
关键发现
- 稳定性提升:相比 LLM 全权决策的搜索,RecHarness 在有限试验预算下展现出更稳定的性能增益,避免了初期采样偏差导致的剧烈波动。
- 效率优势:固定实验次数下,RecHarness 选出的候选模型在验证指标上持续优于基线,体现了 bandit 策略对探索–利用的更优平衡。
- 跳跃机制有效:当局部编辑收益停滞时,激活的 structural-jump arm 能引导模型结构大幅变动,帮助跳出局部最优。
- 线上成效:所选候选模型在线上 A/B 测试中带来 ADVV +2.084%、Revenue +0.534%、Exposure +0.559% 的显著提升。
基线对比深度解读
传统 LLM-reasoning search 让 LLM 同时负责“修改方向选择”和“具体假设生成”,在有限实验轮次中极易因早期试验噪声导致搜索不稳定,且难以在局部编辑与全局探索间灵活切换。RecHarness 将方向选择独立为 bandit 问题,利用 Thompson 采样 依据历史验证反馈动态分配不同编辑方向(如架构调整、目标函数修改),再由 LLM 在指定方向内生成代码编辑。这一分离显著降低了搜索方差,并允许通过跳跃盆地机制明确介入全局探索。消融实验证实,移除 bandit 路由或跳跃机制均导致性能下降,表明该双层分离架构是实现稳定高效搜索的核心。对工程实践而言,“决策路由 + 内容生成”的范式为自动化模型优化提供了更可靠的路线,尤其适用于实验成本高昂、需要持续进化的推荐系统。
行业影响
落地场景
RecHarness 适用于需要持续迭代推荐模型的各类平台,如 短视频、电商、信息流广告、音乐流媒体 等。它能够自动化地优化模型架构、损失函数和训练策略,覆盖 CTR 预估、多目标排序 与 重排 等核心任务,尤其适合实验预算有限但需要频繁探索新模型变体的业务场景。
商业价值
在大型短视频广告平台的线上 A/B 测试中,ADVV 提升 2.084%、Revenue 提升 0.534%、Exposure 提升 0.559%,直接证明了其增收与扩大用户覆盖的能力。同时,RecHarness 通过 Bandit 路由 和 LLM 代码生成 将人工试错过程自动化,大幅降低工程师的迭代成本,在相同实验次数下获得更稳定且更高的性能收益,从而缩短模型上线周期。
与现有工作流集成
RecHarness 可作为自动化优化层嵌入现有 MLOps 管道:
- 输入:模型代码仓库、验证数据集、评估指标与预算限制;
- 运行:Bandit 路由器 根据历史验证反馈选择修改方向(结构跳跃或局部编辑),LLM 代理 生成具体代码 patch,自动提交实验并收集指标,形成闭环;
- 集成点:通过 API 对接实验平台(如 Kubeflow、MLflow)和代码仓库,无需改动原有训练流水线。
落地 Use Case
- 电商推荐:自动优化多目标排序模型(如 GMV + 转化率),在大促期间快速尝试新的特征交互或损失函数,降低算法团队维护成本,并实时适应业务目标变化。
- 短视频广告平台:持续探索广告排序模型的架构变体,在保障曝光量的同时提升广告价值与收入,替代人工周级迭代。
局限
- RecHarness 的修改方向(架构、目标函数、训练策略等)由人工预定义,搜索空间受限,无法自动发现未预设的创新方向;并且 LLM 生成的代码编辑可能出现语法或逻辑错误,实际运行时需要额外的正确性检查与回滚机制,增加了系统的工程复杂度。
- jump-basin 机制依赖验证指标停滞的阈值判断,超参数敏感,可能在不同任务上需反复调试;在线 A/B 测试仅持续 7 天,缺乏长期稳定性证据,也未讨论模型在分布漂移或冷启动场景下的行为,限制了结论的推广性。
- 实验仅对比了基于 LLM-reasoning 的搜索基线,缺少与经典 AutoML 或神经架构搜索(NAS)方法的比较,难以评估其在推荐场景下相对成熟自动化方案的效率与效果;此外,整个流程为推荐模型定制,迁移至其他 ML 任务(如 CV、NLP)时,优化方向、代码模板和反馈信号均需大幅改造。