Knowing When to Quit: 诊断并训练LLM中止徒劳推理
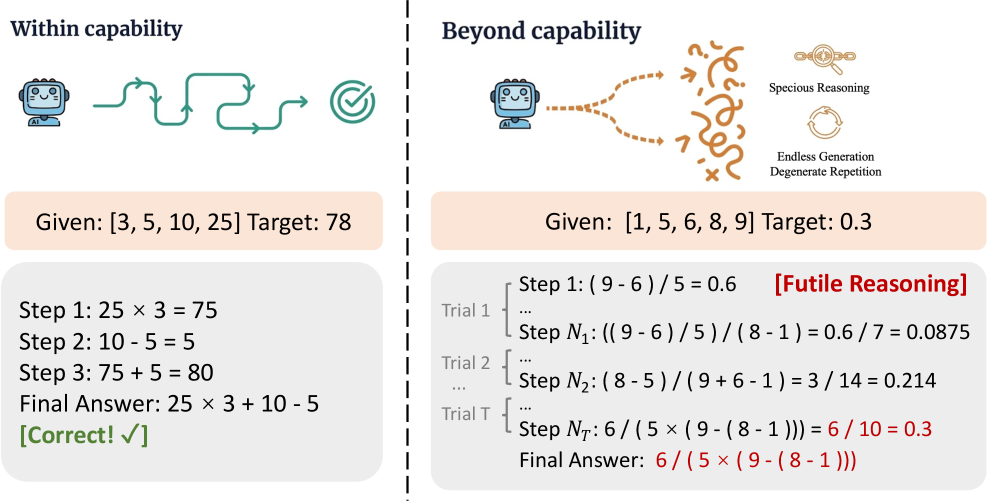
大语言模型在超出能力范围的任务上会产生计算开销巨大但语义空洞的推理,其貌似合理的错误推导可能误导用户,带来风险。本文通过系统性分析刻画了这一徒劳推理现象,揭示了普遍的能力越界以及能力与行为之间的系统性失准。主要失败模式是似是而非的推理,输出表面有效但包含细微错误,且随任务难度上升而加剧。 为解决此问题,我们提出 CaRL(能力对齐强化学习),通过奖励塑形激励模型拒绝而非徒劳推理,并采用事后拒绝增强将失败样本转化为拒绝监督,使模型行为与能力边界对齐。实验表明,CaRL 在各类难度任务上大幅减少徒劳推理,同时保持任务性能,实现了能力对齐行为而不牺牲效用。
论文精读
TL;DR 论文诊断 LLM 在超出能力任务上产生徒劳推理,提出 CaRL 通过奖励塑形与事后拒绝增强对齐能力边界,让模型学会适时放弃,显著减少无效推理且不损失任务性能。
问题
随着大语言模型在数学、代码等复杂推理任务上的能力增强,能力过度自信(capability overreach)问题日益凸显:模型在超出自身能力范围时仍生成看似合理的推理链,不仅浪费计算资源,还可能误导用户。现有工程实践通常通过监督微调或偏好优化鼓励模型尽力求解,但缺少对“何时放弃”的显式建模。
现有方法局限:
- 基于结果奖励的强化学习(如 PPO/DPO)只针对最终答案正确性,不能区分有效推理与无效推理(futile reasoning),导致模型在难题上仍持续生成冗长且错误的推导。
- 简单的拒绝训练容易造成过度拒答,损害正常任务性能;而事后拒绝增强 若不结合能力校准,模型可能在该解答时也放弃。
- 论文指出,仅靠奖励塑形(reward shaping)不足以解决,因为模型无法学习到精确的能力边界;基于拒绝微调(RFT)的泛化性差,难以迁移到不同难度分布。
为什么难且重要:核心挑战在于模型自身难以准确估计能力边界,尤其在分布外任务上,无效推理往往表面合理、难以自动标注。业界对推理成本高度敏感,无效推理意味着算力浪费和误导风险,在高风险场景(如医疗建议、法律分析)中,模型需要诚实地说“不知道”而非强行给出貌似专业的错误答案。
类似自动驾驶在感知不确定时选择安全停车,LLM 也需要在能力边界处主动“刹车”并寻求人类介入,而非输出貌似有理的错误结论。
核心洞察
- 将拒绝(refusal)重新定义为能力校准信号,而非安全对齐或指令遵循。该工作通过量化能力-行为错配,证明超出能力边界的推理并非无害探索,而是产生看似合理但错误的推导,误导用户并浪费计算。与以往用 RLHF 惩罚有害输出不同,CaRL 用奖励塑形直接奖励“放弃”行为,将拒绝作为模型对自身能力边界的诚实判断。这一视角使拒绝对齐从合规问题变为效率与可靠性问题。
- Hindsight refusal augmentation 将失败轨迹转化为拒绝监督,实现了对“何时放弃”的密集学习信号。传统方法如 RFT 或 DPO 只利用成功示例或偏好对,无法有效教会模型识别不可解任务;而 CaRL 把模型实际尝试后失败的样本(包含 specious reasoning)反转为拒绝标签,配合奖励塑形,让模型从自身能力边界中学习。实验表明仅奖励塑形不足以避免 futile reasoning,增加该 augmentation 后才显著降低 futile rate,说明利用失败样本的反思机制是关键。
方法
方法核心
CaRL (Capability-aligned Reinforcement Learning) 将任务求解建模为在“给出答案”与“拒绝回答”之间做决策的强化学习过程,目标是让模型学会在能力边界外主动放弃无效推理。
- 输入:模型接收一个数学推理问题(如 Countdown 任务),可选择生成完整推理链并给出答案,或直接输出拒绝信号。
- 关键模块:
- Capability-Calibrated Reward Shaping:设计校准奖励函数,不仅奖励正确答案,还根据问题难度和模型当前能力动态调整拒绝行为的奖励。对于超出模型能力范围的问题,拒绝会获得较高奖励;对于简单问题,正确求解奖励更高,错误推理和拒绝则获得负奖励。这促使模型在能力边界内积极求解,在边界外主动放弃。
- Hindsight Refusal Augmentation:收集训练过程中的失败样本(模型生成了看似合理但错误的答案),事后将这些样本重新标记为“应拒绝”的监督信号,纳入训练。利用错误案例反向增强拒绝意识,避免模型重复生成无效推理。
- 输出:经过强化学习策略更新后,模型在推理时能够根据问题难度动态调整行为——对可解问题努力求解,对不可解问题输出拒绝,从而减少 futile reasoning。
与同类方法的差异:不同于仅依赖 SFT 或拒绝采样的方法,CaRL 通过奖励塑造显式建模能力边界,并利用失败样本作为拒绝的正例,实现了能力对齐的行为优化,而非单纯抑制错误答案。
实验
实验设计
论文在 Countdown Task 和 Sudoku Task 两个推理任务上系统诊断 LLM 的无效推理现象,并引入 CaRL(Capability-aligned Reinforcement Learning)。CaRL 通过能力校准奖励塑形(对超出能力边界的推理给予拒绝奖励)和事后拒绝增强(将失败轨迹转化为拒绝监督信号)进行强化学习训练。评测指标包括 Accuracy、Reliability Score、Refusal Rate 与 Futile Rate。
关键发现
实验证明 LLM 存在普遍的能力过度自信:面对超出自身能力的任务时,模型仍会生成计算代价高昂但语义空洞的推理链条,其中虚假推理(specious reasoning)是主要失败模式,表现为表面合理但包含细微错误,且随任务难度增加而加剧。CaRL 训练后,模型在保持不同难度任务准确率的同时,大幅降低无效推理比例,并提升拒绝率与可靠性分数,实现能力对齐的行为。
基线对比解读
与标准强化学习(如 RFT)及仅使用奖励塑形的变体相比,CaRL 显著更优:单纯奖励塑形无法充分抑制无效推理,RFT 在未见的困难任务上泛化失败。CaRL 通过将失败样本转化为显式拒绝监督,使模型学会在能力边界处主动放弃,既降低计算浪费,又避免误导用户,体现了不牺牲效用前提下对齐行为的工程价值。
行业影响
落地场景
CaRL 直接适用于需要 LLM 进行多步推理但能力边界不可靠的场景:AI 编程助手在跨仓库重构时、合规审查 Agent 处理多条款交叉引用、电商客服面对复杂组合条件、医疗/金融问答中超出知识范围的问题。这些场景下模型经常产生 specious reasoning(表面合理但含隐性错误),CaRL 训练模型在能力边界处主动放弃,避免误导。
具体落地 use case:
- 企业合同审查 SaaS:模型遇到跨法域/多附件依赖条款时,若强行推理会生成错误风险条款摘要。CaRL 可让模型返回明确拒答 + 转人工复核,降低法务风险。
- 通用代码助手:在大型单仓库重构建议中,超出上下文的依赖关系推理常产生幻觉 diff。CaRL 抑制 futile reasoning,减少用户误信错误修改。
商业价值
- 降本:避免对超限任务进行长链思考的推理 token 消耗,在批处理/Agent 工作流中直接降低 infer 成本。
- 增收/体验:主动拒答比幻觉答案更可信,减少人工审核和售后纠纷;在 SaaS 产品中可形成 “可靠性 SLA” 差异化卖点。
- 风险控制:在金融、医疗等合规场景减少因错误推理导致的法律/监管风险。
与现有产品/工作流的接口
CaRL 基于 RL 奖励塑形与事后拒绝增强,可与已有 RLHF/DPO 管线结合:
- 在 reward model 中增加 拒绝奖励 与 能力校准信号,将 futile reasoning 样本标记为负奖励。
- 利用 hindsight refusal augmentation 将失败轨迹改写为拒绝监督,无需额外人工标注。
- 部署时在推理出口增加 refusal gate,监控
refusal rate与futile rate,将拒答请求分流至规则引擎/人工。
这可以嵌入现有 agent 编排层,如 LangGraph / LlamaIndex 工作流,在不改动基础模型权重的情况下,通过策略层控制能力边界。
局限
- - **任务范围局限**:论文仅在 Countdown 和 Sudoku 两个可验证的合成任务上验证 CaRL,虽然这两个任务能清晰界定 capability boundary,但与开放域问答、代码生成或多跳推理等真实场景差异较大。实际任务往往没有明确的 ground truth 或可自动判定的“正确性”,导致 `capability calibration` 和奖励信号难以直接构造。作者未在更通用的 benchmark(如 MMLU、GSM8K)上检验拒绝行为是否会误伤正常能力,因此方法在复杂生产环境的泛化性仍存疑。
- - **训练成本与奖励设计依赖**:CaRL 的 `reward shaping` 需要预先定义任务难度与模型能力的对应关系,`hindsight refusal augmentation` 则需从失败轨迹中构造拒绝样本,两者都增加了数据工程和调参成本。论文未与更轻量的对齐方法(如 DPO / SFT 变体)进行训练开销对比,也未系统分析 RL 训练不稳定性对最终策略的影响。若 capability 边界估计不准确,模型可能过度拒绝或继续生成错误推理,抵消收益。
- - **评估与对比不足**:评估指标 `Refusal Rate` / `Futile Rate` 能反映推理终止行为,但缺乏用户体验与长期任务成功率的联合度量;同时与现有 confidence-based abstention、self-consistency 等拒绝/自知方法的对比有限。实验模型规模未见大规模(>70B)验证,而小模型上的行为未必能迁移到大模型。对任务难度分布变化时的 **持续校准** 也未讨论,可能导致部署后能力漂移时失效。