AMRD:面向轻量级语音情感识别的自适应多教师关系蒸馏
设备端语音情感识别(SER)对实时应用至关重要,但大型自监督模型虽在 SER 上表现出色,却因成本过高难以部署在边缘设备。多教师知识蒸馏可将它们压缩为轻量学生模型,但面临两个挑战:教师可靠性随批次变化,以及 logit 级蒸馏 忽略样本间关系结构。 为此提出 AMRD(Adaptive Multi-teacher Relational Distillation)方法:一方面用 one-class SVM 对每位教师的 logit 相似度矩阵打分,分配批次级权重,偏好更一致的教师;另一方面设计 关系蒸馏损失,对齐师生相似度矩阵,捕获 logit 匹配遗漏的结构。 在 IEMOCAP 和 CREMA-D 数据集、四种学生架构上,AMRD 在多数设置下优于单教师蒸馏基线,消融实验证实两个组件带来互补增益。
论文精读
TL;DR AMRD 通过自适应多教师关系蒸馏,用 SVM 动态选择可靠教师并引入相似度矩阵蒸馏,解决多教师知识迁移中的噪声与结构丢失问题,显著提升轻量语音情感识别模型性能。
问题
问题背景
语音情感识别(SER)是智能人机交互、心理健康监测等实时应用的核心技术。随着 WavLM、data2vec 等自监督学习(SSL)模型大幅提升 SER 性能,其庞大的参数量(如 94M)阻碍了在边缘设备上的部署。知识蒸馏(KD)成为压缩模型的关键途径,但将多个互补的 SSL 教师有效融合到轻量学生仍是一个开放的挑战。
现有方法局限
多教师知识蒸馏(MTKD)通过聚合多教师软化输出来指导学生,但现有方案存在两点关键不足:
- 教师可靠性动态变化:不同教师在不同批次样本上的预测质量差异显著,固定的教师权重无法自适应,导致蒸馏信号中引入噪声,尤其在低质量教师主导的批次中会严重误导学生。
- 忽略样本间关系结构:传统 LTKD 仅对齐单个样本的 logit 分布,缺失了对 SER 至关重要的样本间相似性信息。情感标注天然带有主观噪声和说话人差异,样本间关系矩阵更能捕捉稳定的情绪聚类模式,但这类结构化知识在现有蒸馏中被完全丢弃。
技术难点与重要性
SER 面临标注成本高、主观性强以及说话人风格多变等固有难题,要求学生模型不仅要拟合标签,更需学习跨说话人、跨类别的鲁棒表示。多教师蒸馏中,如何动态评估每位教师的可信度并挖掘高阶关系知识,是平衡效率与泛化性的核心瓶颈。该问题的突破将直接影响情感 AI 在资源受限设备(如可穿戴终端、车载系统)上的实用化进程,让准确的情感推理不再依赖云端大模型。
行业类比
类似 MobileNet 通过多教师蒸馏获得轻量级图像分类模型,但 SER 的高维时序信号与标注模糊性使其更需要自适应权重量化和关系结构保留,这恰如推荐系统中协同过滤依赖物品间相似度矩阵,而非单纯的评分预测。
核心洞察
- - 自适应教师权重机制通过对每批次的教师 logit 相似度矩阵进行单类 SVM 分析,量化各教师知识的一致性,动态分配融合权重。这不同于以往依赖固定权重或静态平均的多教师 KD 方法,它使知识蒸馏能够感知每个 mini-batch 中教师的相对可靠性,从而更有效地利用互补信息,特别是在语音情感这种标注主观性强的任务中,避免低质量教师干扰学生训练。
- - 关系蒸馏损失函数显式地建模样本间的相似度结构,要求学生不仅匹配教师 logits,还要复现教师的样本关系图。这弥补了传统 logit 级 KD 忽略数据内部结构的重要缺陷,使得轻量学生模型能够学到更具判别力的情感表征,提升跨说话人和跨语料的泛化能力,并且与自适应权重相互配合,带来显著的性能增益。
方法
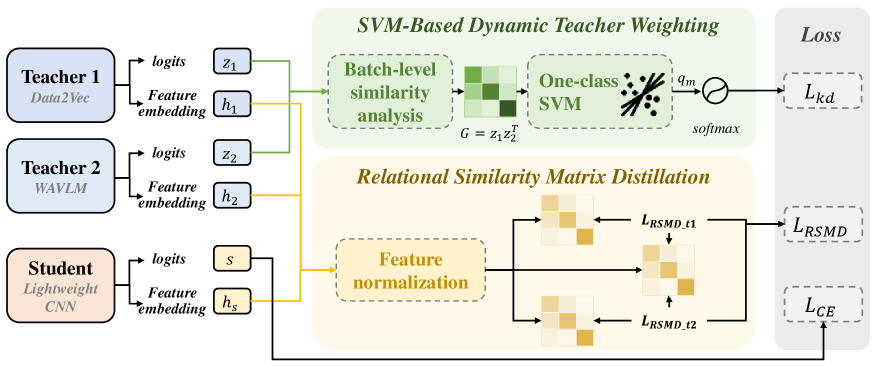
AMRD 方法以多个大型自监督语音模型为教师,压缩生成一个轻量学生模型,用于资源受限场景下的语音情感识别(SER)。整体流程为:
- 输入与教师前向:同一批语音样本同时送入多个教师(如 WavLM、data2vec),各教师输出每个样本的情感类别 logits,构成 logit 矩阵。
- 关键模块一:自适应教师权重:为每个教师单独构建 logit 相似度矩阵(样本间余弦相似度),然后对矩阵应用 One-Class SVM 获得一个“连贯性评分”。该评分反映教师当前批次输出内在结构的稳定性——评分越高,说明教师对样本间关系建模越一致。随后通过 softmax 归一化得到每个教师的批次级权重,动态抑制不可靠教师的贡献。
- 关键模块二:关系蒸馏损失:将教师加权融合后的相似度矩阵与学生自身的 logit 相似度矩阵对齐,采用均方误差或 KL 散度作为损失。这一损失显式捕捉样本间情感关系(如高兴与惊讶更相似等结构信息),弥补传统 logit 级蒸馏仅关注单样本点预测的不足。
- 训练目标融合:最终损失 = 加权 logit 蒸馏损失(学生拟合教师融合输出)+ 关系蒸馏损失,端到端训练学生网络。
该设计使得学生不仅能学习教师的类别判定,还能继承教师对样本间拓扑关系的理解,从而在资源受限条件下保持更鲁棒的 SER 性能。
与同类多教师蒸馏方法的差异:现有 MTKD 通常采用固定或简单平均的策略融合教师,且只在 logit 层面传递知识;AMRD 则引入批次级教师可靠性评估,并通过关系蒸馏首次将样本间结构知识引入 SER 蒸馏,实现了对教师动态选择和结构信息迁移的双重增强。
实验
实验设计
论文在 IEMOCAP 和 CREMA-D 两个公开情感识别数据集上进行验证,覆盖四种不同的轻量学生架构(架构细节未在摘要中给出)。
实验对比了 AMRD 与单教师蒸馏基线(single-teacher KD),同时通过消融实验分别验证自适应教师加权(SVM 动态权重)和关系蒸馏损失两个组件的贡献。
关键发现
- AMRD 在多数实验配置下显著优于单教师蒸馏,证明多教师融合与关系结构迁移的有效性。
- 消融实验表明,两个组件均带来增益,且两者结合具有互补性:仅用自适应加权或仅用关系蒸馏均不及完整方法。
- 该方法对不同学生架构具有较好的泛化能力,说明关系蒸馏和动态教师加权不依赖特定模型容量。
与基线对比的深度解读
传统多教师蒸馏通常采用固定权重或仅对齐 logits,忽略了不同教师在 batch 级的可靠性波动,以及样本间相似结构的监督信号。
AMRD 通过 one-class SVM 动态评估教师输出的一致性,抑制噪声教师的影响,从而突破静态平均的局限。同时,相似矩阵的对齐将蒸馏从点级提升到结构级,学生不仅学到了类别分布,还学到样本间的相对关系,这在情感识别这类主观性强、类内方差大的任务中尤为关键。
原作者认为:“relational distillation loss captures structure that logit matching misses”,直指传统蒸馏方法的核心缺陷。
相比单教师蒸馏,AMRD 的多教师机制提供了更丰富的监督源,而关系损失则弥补了 logit 蒸馏的信息瓶颈。
行业影响
落地场景
AMRD 提出的自适应多教师关系蒸馏方法,可在资源受限的边缘设备上实现高性能语音情感识别(SER),主要落地场景包括:
- 智能客服与呼叫中心:实时分析客户语音情绪,辅助坐席或自动触发安抚/升级策略。
- 车载语音助手:在低算力车机芯片上感知驾驶员情绪(愤怒、疲惫等),联动 ADAS 或交互设计。
- 心理健康应用:通过手机端语音日记或在线咨询,提供情绪趋势追踪与预警。
- 智能教育平台:检测学生语音中的困惑或挫败感,动态调整教学节奏。
商业价值
- 降本:通过多教师蒸馏将 WavLM 等大模型(~94M 参数)压缩为学生小模型,直接降低云端推理成本与端侧硬件要求,使 SER 功能可在百元级 MCU 或低端智能手机上运行。
- 体验提升:关系蒸馏保留了样本间的情感结构,比纯 logit 匹配更鲁棒,在 IEMOCAP 和 CREMA-D 上多数设置优于单教师基线,意味着更准确的情绪识别,从而提升用户满意度与信任。
- 增收:更轻量的模型允许在现有设备上批量部署,扩大了潜在市场规模,如为金融 APP 提供投资咨询时的情绪合规监控,或为视频会议工具增加实时情绪反馈等增值功能。
与现有产品/工作流的接口
AMRD 框架可无缝集成进现有 MLOps 流水线:
- 模型训练阶段:替代原有单教师 KD 模块,支持从多个预训练 SSL 模型(WavLM、data2vec 等)蒸馏,只需提供教师 logit 输出即可计算自适应权重与关系矩阵。
- 硬件适配:学生模型可为任意轻量架构(原文验证了 4 种),工程师可根据目标平台选择最合适的 backbone(如 MobileNet 系列或 Transformer 精简版),无需改动 AMRD 核心算法。
- 部署:蒸馏后的学生模型导出为 ONNX/TensorFlow Lite 格式,可直接嵌入移动端 SDK 或 IoT 推理引擎,与现有实时特征提取流水线(如 MFCC 或轻量 SSL 特征)对接。
具体落地 use case
- 远程医疗平台的情绪评估:在在线问诊中,平台实时分析患者语音情感,辅助医生判断抑郁/焦虑倾向,触发评估量表或人工干预。AMRD 的多教师可靠性加权能适应不同口音和背景噪声,关系蒸馏提升跨患者泛化,避免对特定教师过拟合。
- 电商直播的观众情感分析:对主播语音进行实时情绪识别,动态调整商品推荐或话术。轻量学生模型可直接在推流端运行,降低延迟和带宽成本,多教师知识互补则提升了在嘈杂直播环境下的准确性。
局限
- - **数据集规模与多样性有限**:实验仅在 **IEMOCAP** 和 **CREMA-D** 两个英文数据集上进行,它们均为受控录音室环境下的表演语音,情感类别有限且缺乏大规模真实噪声、口音、语种变化。论文未在 in‑the‑wild 数据集(如 **MELD**、**RAVDESS** 等)或跨语种场景测试,因此 **AMRD** 的泛化性与鲁棒性尚未得到充分验证,实际边缘部署时可能面临性能下降。
- - **多教师蒸馏的预处理成本较高**:方法要求为每个教师模型独立训练一个单类 **SVM** 用于批量权重估计,并且每个批次需计算教师与学生的相似矩阵,这会增加训练阶段的算力和存储开销。论文未分析 **SVM** 核函数、温度系数等超参数对不同师生组合的敏感性,也未讨论在多个大型教师模型共同存在时的存储与计算负担,限制了在资源敏感场景下的快速部署。
- - **对比基线较为简单**:主要对比对象为单教师蒸馏及**平均融合**多教师基线,未与最新的自适应多教师融合方法(如基于注意力、梯度对齐或不确定度估计的方法)进行全面比较,也未探索其他关系蒸馏变体(如**对比表示蒸馏**或**结构关系图**)的差异。因此,无法明确**AMRD** 相对于更先进 MTKD 框架的优势边界,且消融实验中两项创新互补增益的大小受具体设置影响较大。