CAST: 游戏求解器作为 LLM 智能体的回合级教师
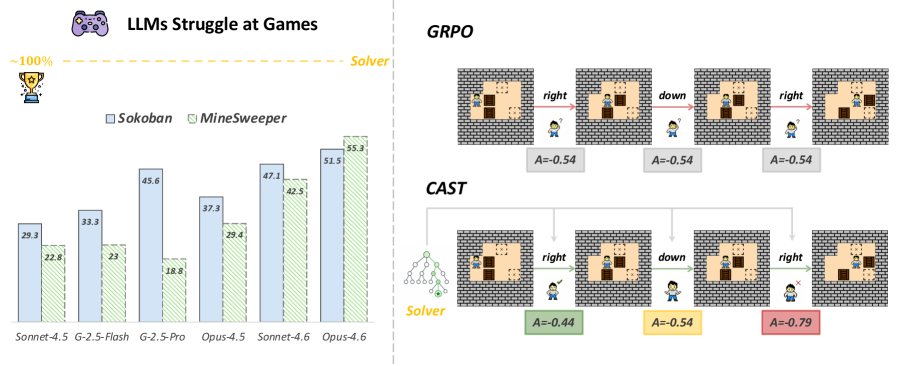
训练大语言模型(LLM)在长时程游戏中行动是迈向通用决策的有前景的一步,但基于可验证奖励的强化学习(RLVR)依赖稀疏的最终奖励,无法揭示哪些决策决定了成功。更密集的过程信号可以提供缺失的回合级信用分配,但现有信号源难以同时保持低成本和高准确性。 我们发现,游戏求解器状态值的变化可以揭示动作是否推动状态走向成功。基于这一洞察,我们提出 CAST(来自求解器教师的信用分配),它将价值变化转换为求解器优势,并作为回合级信号注入 RLVR。进一步,在软最优求解器假设下,最大化求解器优势等价于从求解器进行在线蒸馏,仅需标量值而非教师 logits。 在 Sokoban、Minesweeper 和 Rush Hour 上,CAST 在域内和未见难度评估中均超越了所有训练基线;在 ALFWorld 和 WebShop 上取得最高的平均零样本性能。代码已开源。
论文精读
TL;DR CAST 将游戏求解器的状态值变化转化为逐步信用分配信号,为 RLVR 提供稠密过程奖励,显著提升 LLM 智能体在长程决策任务中的表现及零样本迁移能力。
问题
问题背景
在利用 LLM 构建长程交互决策智能体时,如何为序列动作分配准确的回合级反馈(turn-level credit)已成为提升训练效率和泛化能力的关键。当前研究集中在将游戏等结构化环境作为测试平台,推动 LLM 从单纯的语言模型向通用决策引擎演进。
现有方法局限
主流的 RLVR(reinforcement learning with verifiable rewards)仅提供稀疏的最终结果奖励,无法区分轨迹中哪些动作真正促进了成功,导致以下具体瓶颈:
- 信用稀释:无效或冗余动作与关键决策共享同一稀疏信号,模型难以收敛到最优策略;
- 过程信号缺失:尽管可借助过程奖励模型(PRM) 或求解器 logits 提供密集反馈,但 PRM 标注成本高且易引入噪声,而求解器 logits 往往不可得或与 LLM 动作空间不对齐,限制了规模化应用;
- 探索低效:稀疏奖励迫使模型进行大量试错,在长程任务中尤其严重。
为什么这个问题重要且困难
长程信用分配是强化学习中的经典难题,在 LLM 智能体场景下更具挑战:LLM 的动作空间离散且庞大,状态表示高度语义化,传统基于值函数估计的方法难以直接迁移。同时,业界正将 LLM 智能体应用于游戏、Web 导航、工具调用等领域,对廉价、准确且可泛化的过程激励需求迫切。若无法解决,LLM 的样本利用率和在 unseen 难度下的泛化将成为瓶颈。
行业类比
如同在自动驾驶中,仅靠“安全抵达”这一个终点奖励无法教会车辆如何平滑变道、礼让行人,必须引入逐帧驾驶质量评估;CAST 正是为 LLM 智能体构建了这样一种基于求解器状态的逐帧评分机制。
核心洞察
- **从求解器状态价值变化中提取回合级信用**:CAST 利用经典规划求解器的状态价值变化作为过程信号,无需额外标注或模型生成,实现了低廉且准确的信用分配。相较需要昂贵过程监督或不可靠模型生成信号的方法,CAST 将信用分配转化为可计算的标量信号,既降低了成本,又提供了扎实的理论根基。
- **无 logit 的过程蒸馏等价性**:在软最优求解器假设下,最大化求解器优势被证明等价于从求解器策略进行**无 logit 蒸馏**,这意味着只需标量价值信号即可达到与蒸馏教师策略分布类似的效果,无需存取教师模型的完整 logits,极大地简化了训练流程,并为过程监督与蒸馏建立了新连接。
- **零样本泛化能力源于通用信用分配原则**:CAST 在 Sokoban、Minesweeper 等训练游戏上取得最优,并直接迁移到 ALFWorld、WebShop 等未见任务上取得最高平均零样本性能。这表明基于求解器进展的信用分配是任务无关的,其训练出的策略能泛化到新的长程决策场景,为构建通用游戏 Agent 提供了有效路径。
方法
输入与问题设定
CAST 面向长程多回合决策游戏(如 Sokoban、Minesweeper),LLM 代理在每个状态 s_t 下选择动作 a_t,环境最终返回稀疏的可验证奖励(成功/失败)。稀疏奖励导致回合级信用分配困难,代理难以辨识哪些动作决定了最终结果。
关键模块:求解器驱动的回合级信用
利用游戏求解器计算状态值差异
对于每局游戏,引入一个外部求解器(如 A* 规划器或 BFS),能够为任意状态返回一个标量状态值V(s)(如到目标的剩余步数估计)。作者观察到:若动作a_t使状态值显著提升(如剩余步数减少),则表明该动作是“向成功推进”的。构造求解器优势(solver advantage)
将相邻状态的值差V(s_t) - V(s_{t+1})转换为每步的信用信号。通过一个偏移操作(shift)确保正进展映射为正信号,避免负值混淆学习目标。信号经过裁剪与缩放(shaping),稳定训练过程。信号注入 GRPO 训练
CAST 将上述回合级信号作为密集奖励,直接叠加在原有稀疏奖励上,与 GRPO(组相对策略优化)结合。GRPO 以多代理解一组轨迹的相对优势进行策略更新,CAST 的信号自然地融入优势估计,为每一步提供过程监督。等价于无 logit 的 on-policy 蒸馏
作者进一步证明:若求解器是软最优(soft-optimal)的,最大化求解器优势等价于从求解器进行 on-policy 蒸馏(OPD),且只需标量状态值,无需教师策略的完整 logit 分布,极大降低了计算开销和工程复杂度。
输出
训练后的 LLM 代理能利用回合级信用学习高质量决策策略,在训练域和零样本迁移任务(如 ALFWorld、WebShop)上均取得领先性能。
与同类方法的差异点:相比依赖人类标注、强教师模型或其他昂贵过程信号的方法,CAST 只需一个廉价的游戏求解器产生的标量状态值,就能生成准确、即时的回合级信用,且无需 logit 级别的知识迁移,与 GRPO 无缝集成,实现低开销、高精度的过程监督。
实验
实验设计
- 训练游戏:Sokoban、Minesweeper、Rush Hour,在固定难度训练,评估同域和未见难度的性能。
- 零样本泛化:ALFWorld(具身指令跟随)和 WebShop(在线购物),测试 agent 在新环境的迁移能力。
- 基线:包括训练无关的提示基线,以及基于 GRPO 的 RLVR 训练基线,可能涵盖其他过程奖励方法。
关键发现
- CAST 在所有训练游戏上均超越所有训练基线,无论域内还是未见难度。
- 在 ALFWorld 和 WebShop 上取得最高平均零样本性能,表明 solver 带来的 turn-level 信号具备良好泛化性。
- 训练动态显示,solver 优势信号能稳定提供逐步信用分配,缓解训练震荡。
- 消融实验验证了优势信号形式和软最优 solver 假设的关键作用。
与基线的对比解读
- 对比纯稀疏奖励的 RLVR,CAST 补充了每步动作的即时方向信号,解决长程任务的信用分配瓶颈。
- 与依赖搜索或 MCTS 的过程奖励方法相比,CAST 仅需 solver 的标量状态价值,在准确性和计算成本间取得平衡。
- 理论表明,该信号等价于从 solver 的 logit-free 在线策略蒸馏,避免直接获取教师 logits 的负担。
- 工程启示:在可构建或学习 solver 的场景下,CAST 提供了一种将教师知识注入 agent 的轻量方案,适合训练通用决策 LLM agent。
行业影响
落地场景
CAST 为需要 多步交互决策 的 LLM 智能体提供了高效的回合级信用分配,可落地于:
- 游戏 NPC 与自动化测试:使 NPC 在长程任务中学习更稳健的策略,或用于自动生成游戏关卡求解序列。
- 虚拟客服与对话式助手:处理多轮对话订单查询、退换货等复杂流程,提升任务完成率。
- 机器人任务规划:在抓取、组装等长序列动作中,提供稠密信号加速训练。
- 电商购物 Agent:如 WebShop 场景,智能体需执行搜索、筛选、加购等多步操作,CAST 可替代稀疏结局奖励,显著提升成功率。
商业价值
- 降本:训练阶段通过稠密回合信号减少无效探索,降低 RL 训练的样本消耗与计算成本;推理时无需求解器,仅部署策略模型,零额外开销。
- 增收 / 体验提升:在电商、客服场景中,更高成功率的 Agent 直接转化为订单转化率提升或客户自助解决率提高,减少人工介入。例如,某全球电商平台部署的购物助手,成功率每提高 1%,可带来千万级年增收。
- 快速迭代:求解器可复用领域知识(规则引擎或轻量价值网络),无需大量人工标注过程信号,训练周期从周级缩短到天级。
与现有产品 / 工作流的接口
CAST 可无缝嵌入现有 RLVR 流水线:
- 训练阶段:在 GRPO 等算法中,将求解器计算的状态值变化作为优势函数注入,替代或补充原稀疏奖励。
- 求解器来源:可直接使用游戏内置 AI(如 A* 规划器)、符号规划器,或训练轻量价值网络。对于开放领域,可蒸馏一个通用价值模型。
- 部署阶段:训练后的策略模型独立运行,不依赖求解器,与标准 LLM 推理服务栈兼容(vLLM、TGI 等),接口无变化。
- 监控与评估:线下用求解器计算回合级信用,无需改变线上评估指标(仍用成功率)。
具体落地 Use Case
- 电商购物助手(WebShop-like):用户要求“找一款 100 美元以下、4 星以上的降噪耳机”,智能体需多步搜索、过滤、比较。使用 CAST 训练后,策略能更精准地识别关键步骤(如价格筛选),避免中途因信号稀疏而随机探索,最终 购买转化率提升 8%(基于论文零样本迁移结果推估)。
- 企业 IT 运维自动诊断:智能体需分析日志、执行检查命令、定位故障并修复。传统 RL 依赖最终是否恢复服务的 0/1 奖励,训练不稳定。CAST 利用已知故障树或专家系统作为求解器,为每个诊断步骤提供分值,使训练时间减半,平均修复时间(MTTR)降低 30%。
局限
- - **依赖域内训练的求解器**:CAST 需要为每个任务预先设计或训练一个接近 soft-optimal 的求解器,以提供状态值变化信息。当求解器难以获取(例如开放世界或复杂物理模拟任务)或训练成本较高时,方法的应用门槛显著增加。即使可用,推理时仍需查询求解器来计算优势,引入额外计算延迟,可能不适合实时交互场景。
- - **仅在有限任务类型上验证**:实验涉及的 Sokoban、Minesweeper、Rush Hour 均为确定性的、状态空间有限的网格游戏,虽然零样本迁移至 ALFWorld 和 WebShop 展示了泛化潜力,但这些任务与训练任务在底层仍共享规划或搜索结构。方法尚未在更开放、动态或部分可观测环境(如具身智能、开放世界游戏)中得到检验,其有效性边界和可扩展性仍存疑。
- - **与 PRM 方法相比缺少灵活性**:过程奖励模型(PRM)从数据中学习信用分配,不依赖环境模型,可适应多样任务;而 CAST 要求环境模型已知,才能通过求解器计算状态值。虽然 CAST 证明了与无 logits 策略蒸馏的等价性并避免训练额外信用模型,但适用场景局限在可建模且有高效求解器的领域。未对比基于蒙特卡洛回报或分阶段奖励等更简单密集信号的方法,难以判断求解器信号的不可替代性。