CLBench-V: 评估从基础到知识获取的多模态上下文学习
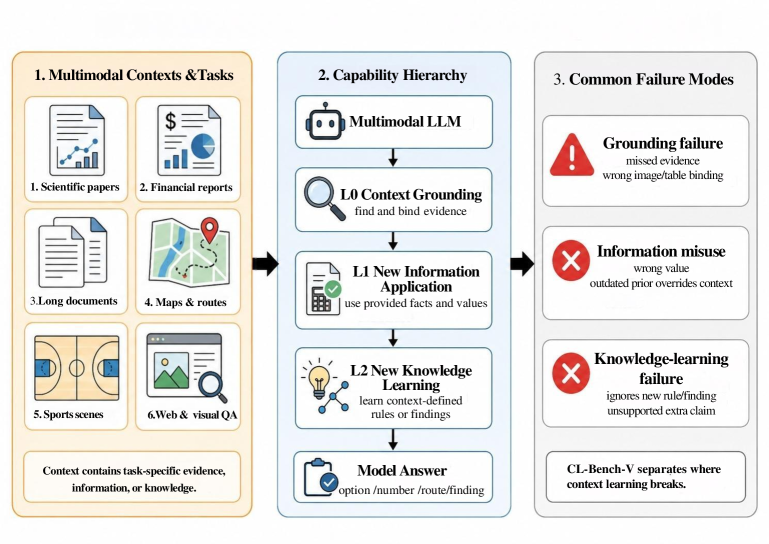
现实任务常需模型从任务特定上下文中学习,而非仅依赖预训练知识。以往研究将此能力称为上下文学习,但评估多局限于文本。实际中,上下文往往是多模态的:科学发现通过图表传达,金融指标散布在转换报告中,空间决策依赖地图、场景或网页。 为此,我们提出 CLBench-V,一个多模态上下文学习基准。它围绕三个维度组织任务:上下文基础、新信息应用 和 新知识学习,以定位上下文使用失效的环节。CLBench-V 整合了转换后的公开基准和新构建的数据集,覆盖科学、金融、长文档理解、空间推理和基于网页的视觉问答。为降低领域特定任务构建成本,我们采用自动化流程构建和过滤新数据集。 在 3,443 个实例和六个近期多模态模型上,最佳总分为 0.2847,表明多模态上下文学习远未饱和。InternVL3.5-30B-A3B 在上下文基础和新知识学习上表现最佳,而 Qwen3.5-Plus 在新信息应用上最优。我们进一步分析了判断可靠性、上下文长度、图像数量和典型失败案例。代码见 https://github.com/IamLihua/CLBench-V。
论文精读
TL;DR CLBench-V 是首个多模态上下文学习基准,覆盖定位、信息应用与新知识学习三层能力,揭示当前多模态模型仅获 0.28 分,远未饱和。
问题
问题背景
多模态大模型正在从单一图像理解迈向复杂的**上下文学习(context learning)**能力评估,其核心是模型能否从任务提供的多模态上下文中提取信息并加以应用,而非仅依赖预训练知识。这一能力对金融分析、科研辅助、空间决策等实际场景至关重要。
现有方法局限
当前主流的多模态长上下文评测(如 MMLongBench-Doc、Video-MME)大多聚焦于长文档或视频的浅层信息抽取,或仅关注文本模态,存在两个明显局限:
- 缺乏层次化诊断:无法定位模型上下文使用失败发生在证据接地、新信息应用还是新知识学习阶段,导致改进方向模糊。
- 模态单一:忽略真实任务中图表、表格、网页截图等视觉元素与文本交织的复杂性,难以评估模型在多模态证据链上的推理鲁棒性。
为什么这个问题难且重要
多模态上下文学习要求模型完成从视觉元素定位到跨线索综合归纳的完整认知链。技术挑战在于:
- 模型极易产生证据错绑(将视觉区域与错误文本关联)、图表数值误用或过程归纳不完整等细粒度错误;
- 现有最强模型在 CLBench-V 的 3,443 个样本上总分仅 0.2847,远未达到可用水平;
- 业界正迫切需要能够处理长多模态上下文的 Agent,如阅读图文混排研究报告并回答专业问题的助手,该基准直接度量了这一核心短板。
行业类比
这好比构建一个能阅读完整产品说明书(含示意图与分步文字)并准确回答装配问题的多模态助手,任一环节的接地失败都会导致错误答案,对可靠自动化决策构成根本阻碍。
核心洞察
- CLBench-V 将多模态上下文学习拆解为三种层级能力(基础定位、新信息应用、新知识学习),从而可精确诊断模型失败的具体环节。现有评估大多只关注纯文本上下文或笼统的多模态问答,而 CLBench-V 通过这种层级化设计揭示了模型在多模态上下文中不同阶段的能力缺陷,为后续定向优化提供了可操作的信号。例如,有的模型擅长从上下文中提取事实但无法推理应用,有的反之,这种细粒度差异在单维评测中会被掩盖。
- 六个多模态模型在 CLBench-V 上的最优总分仅 0.2847,且 InternVL3.5-30B-A3B 在基础定位与新知识学习上领先,而 Qwen3.5-Plus 在新信息应用上更强,显示出能力互补。这表明当前多模态模型远未掌握从上下文学习这种人类可以灵活运用的能力,且不存在通用的“全能型”模型。不同任务层级对模型的要求差异巨大,实际部署时需根据需求组合或路由不同模型,也启示研究应关注如何统一提升这三个维度的能力,而不是仅追求单一指标。
方法
输入与任务设计
CLBench-V 为多模态上下文学习构建了一套层级化评估体系。模型的输入是一个视觉-语言上下文,例如包含图表、表格、扫描文档或网页截图的多个图像,以及相应的文本指令和问题。任务要求模型不依赖预训练参数中已固化的知识,而是从给定上下文中实时学习并回答问题。
关键模块:三级能力分层与自动化数据构建
基准的核心是将上下文学习拆解为三个能力层级,以精确定位模型失败点:
- L0:上下文基础 (Context Grounding) — 检验模型能否从多模态上下文中准确定位和关联信息,例如在多个图像间正确绑定视觉证据。
- L1:新信息应用 (New Information Application) — 评估模型能否利用上下文中提供的新规则或格式来执行任务,如根据一份金融报告中的自定义ROE公式进行计算。
- L2:新知识学习 (New Knowledge Learning) — 考察模型能否从上下文中归纳出此前未知的领域知识,并用于推理,例如从论文图表中抽取出新的科学发现。
数据构建流水线 结合了两种来源:
- 公共基准转换:将现有科学、金融、空间推理等数据集改造为上下文学习任务,要求模型仅依据当次提供的“上下文集”作答,而非依赖内化知识。
- 自动化新数据生成与过滤:针对金融报告ROE分析、论文结论推断等领域,使用自动化流程生成任务实例,再通过规则和模型过滤保证质量,大幅降低人工标注成本。整个过程生成了2,443 个实例(部分为转换数据,部分为新造),覆盖长文档理解、网页VQA等场景。
评估协议与输出
评估采用LLM-as-Judge机制:模型生成答案后,由一个专门设计的大模型评委(如GPT-4类)依据标准答案判断对错,并输出归一化得分(0~1)。为提升可靠性,作者还分析了评委一致性和提取答案的鲁棒性。最终输出为L0/L1/L2各层级得分与整体加权分数,直观展示模型短板。
与同类方法的差异:现有上下文学习基准几乎仅覆盖纯文本,CLBench-V 首次引入了系统性的多模态上下文学习评价框架,并通过三级分层设计实现了可诊断的细粒度能力分析,而非只提供一个单一的性能数字。
实验
实验设计
CLBench-V 整合了多个转换自公共基准的长文档与网页 VQA 数据(如 MMLongBench-Doc 和 MMLongBench-Web),并基于自动化流程构建了金融 ROE 分析、论文结论推断、空间推理等全新领域数据集,总计 3,443 个实例。任务按三个能力层级组织:L0 上下文定位(从多模态材料中准确提取证据)、L1 新信息应用(将给定非结构化信息与任务规则结合)及 L2 新知识学习(从上下文中归纳临时知识并推理)。评估选取六款近期多模态模型(如 InternVL3.5-30B-A3B、Qwen3.5-Plus 等),统一提示模板,并使用 LLM Judge 量化回答质量。
关键发现
所有模型的总体最佳得分仅为 0.2847,说明多模态上下文学习远未解决。模型表现差异明显:InternVL3.5-30B-A3B 在上下文定位和新知识学习上最优,而 Qwen3.5-Plus 在新信息应用上领先。上下文复杂度(长度、图像数量)上升时性能显著下降,典型失败包括视觉证据错绑、图表数值绑定错误、以及无法完整归纳上下文定义的多步推理流程。
与基线对比解读
由于该基准是全新构建,直接对比意义有限。但 0.2847 的最佳分与人类近乎完美解决同类任务的能力形成强烈反差,揭示当前模型在跨模态对齐、长程注意力与可复用知识抽象方面严重不足。分层诊断框架能够精准定位能力断点——例如,多数模型在定位阶段即已出错,导致后续应用与学习无从谈起。这为未来多模态架构设计提供了明确的改进方向。
行业影响
落地场景
CLBench-V 评估的是多模态上下文学习 (Multimodal Context Learning),直接对标三类工业产品:
- 智能文档处理 (IDP):金融报告、科学论文、合同等含图表、表格、图像的复杂文档,模型需从上下文提取关键信息并推理,而非仅依赖预训练知识。
- 多模态知识助手:面向科研、医学、法律等专业领域的问答系统,要求模型从用户提供的多模态材料(实验图、影像、判例文档)中学习并应用新知识。
- 空间与视觉推理系统:自动驾驶、物流机器人、AR 导航等场景,需结合地图、场景图像等多模态上下文进行即时决策。
商业价值
- 降低人工审核成本:金融分析、合规审查等领域,模型若能精准定位上下文证据(Context Grounding),可自动生成审计底稿,减少人工复核。
- 提升专业服务溢价:法律、科研辅助产品通过更强的新知识学习能力 (L2),可即时消化用户上传的新研究论文、专利文档,提供高附加值分析,支撑订阅制或按次付费的商业模式。
- 改善决策延迟:在实时场景(如自动驾驶瞬时判断)中,快速上下文接地能力直接关系系统安全与用户体验,减少因预训练知识过时而导致的错误决策。
与现有产品/工作流的接口
- 模型选型与监控:将 CLBench-V 的三级能力分层(L0 接地、L1 应用、L2 学习)作为模型评估标准,嵌入 ML pipeline 的持续集成环节,基于分数波动自动触发模型更新。
- 数据飞轮:利用基准中自动化构建与过滤的思路,将用户反馈的多模态上下文任务转化为训练数据,结合失败案例(Failure Taxonomy)针对性地微调模型。
- 多模型路由:根据任务类型动态调度:InternVL3.5-30B-A3B 适合需要强接地和新知识学习的任务,而 Qwen3.5-Plus 更适合新信息应用场景,在 API 网关层实现成本与效果平衡。
典型用例
- 金融报告 ROE 分析自动化:某全球投行将季度财报(PDF 含图表)输入模型,模型需从利润表和资产负债表的多个表格中定位 ROE 相关数据,并对比行业基准。该任务恰好对应 CLBench-V 的 L1 和 L2:先接地数值,再结合报告内新披露的业务重组信息调整分析框架。
- 电商多模态客服:用户上传商品截图、成分表照片与使用场景视频,询问过敏风险。模型需从多模态上下文学习该商品的独特成分交互规则(新知识),并结合图像中的文字进行接地推理,输出个性化建议,而非仅匹配预训练通用知识库。
局限
- **LLM 评判可靠性**:论文采用 LLM 作为自动化评判器,但分析表明评判结果与人工评判仍存在不一致,尤其在涉及复杂推理和细粒度证据匹配的任务中,评判偏差可能影响最终排名的置信度。实际部署时,若直接依赖此类自动化评估,可能误导模型优选的结论,需要更可靠的评判协议或混合人工审核。
- **上下文长度与多图像挑战的覆盖局限**:尽管基准纳入了多文档和多图像场景,但实验中最大上下文长度和图像数仍有限,未能充分测试极长上下文(如超长报告、长视频关键帧)下模型的退化行为。这限制了基准对当前前沿长上下文多模态模型极限能力的真正检验,后续需扩展至万级 token 和百级图像以反映真实业务需求。
- **自动构建数据的领域偏差与噪声**:为降低成本,部分数据集采用自动化流水线构建,可能引入模板化的语言、简化的场景分布或标注错误,与真实世界开放式多模态上下文存在分布偏移。这会影响基准的生态效度,使得高分的模型在实际复杂应用(如多页财报交叉分析)中未必表现鲁棒。