面向小规模语言模型智能体的鲁棒强化学习
使用强化学习对齐小语言模型(SLM)(参数范围 70M--500M)常被认为不稳定,但其失败机制尚未系统研究。本文在最先进(SOTA)研究中,使用近端策略优化(PPO)训练了 15 种 (model, corpus) 配置,涵盖 Pythia-70M、160M、410M 和 SmolLM2-135M、360M 模型,在 TinyStories、CNN/DailyMail、Wikitext-103 语料上实验。 发现了三个可复现的失败模式:标准 PEFT/TRL 流水线中的静默 LoRA 参数冻结、使用 bfloat16 时重要性比率的数值溢出、以及奖励模型误差导致的灾难性策略崩溃。通过合并-重初始化适配器技术、PPO 更新时使用 float32 精度、以及包含奖励白化、重要性比率保护、权重回滚的三层安全机制解决了这些问题。 提出容量裕度假说:SLM 尺度上的 PPO 性能取决于流畅的监督模型(PPL<20)和区分性奖励信号,而非参数量。所提系统在所有实验中稳定收敛,并在拥有流畅先验和信息奖励信号的配置中,相比 SFT 基线提升了偏好胜率,且用更少训练数据超越了指令微调基线。所有检查点、偏好数据集和训练脚本均已公开。
论文精读
TL;DR 系统揭示 70–500M 小模型 RL 对齐的三种失败模式,通过适配器重初始化、浮点精度控制及三层安全机制实现稳定收敛,并提出容量余量假说指导实践。
问题
问题背景
在大语言模型(LLM)对齐中,强化学习(RL)已成为主流方法,特别是PPO 这类策略优化算法在 RLHF 流程中广泛使用。然而,对于参数量在 70M-500M 的小型语言模型(SLM),RL 训练经常出现剧烈波动甚至崩溃,但其深层原因并未被系统梳理。
现有方法局限
过去将标准 RLHF 流程直接套用在 SLM 上,主要依赖 PEFT/LoRA 和 bfloat16 混合精度,并采用固定奖励模型,但这些组件在小模型场景下暴露出三个可复现的失败模式:
- 梯度流受阻: LoRA 适配器参数在标准 TRL 管道中会无声冻结,导致策略无法更新;
- 数值不稳定: bfloat16 下重要性比率计算易发生溢出,使梯度爆炸;
- 灾难性策略崩溃: 奖励模型的误差直接传导给策略,驱动生成偏离分布甚至无意义的文本。 上述问题在小模型上尤为严重,因为模型容量有限,误差无法被大参数量“稀释”,且现有 PPO 实现未针对低容量场景做防护。
为什么这个问题难/重要
小模型的表征能力弱,对奖励噪声和分布偏移更敏感,而 RL 本身的高方差特性会放大这些扰动,导致训练轨迹极易发散。另一方面,业界对轻量级、低延迟模型的需求持续增长,这些模型在边缘设备、实时交互等场景无可替代,但若无法稳定对齐,其实际部署风险极大。因此,找到 不依赖大规模参数 的稳健 RL 训练方案,是推动小型语言模型可靠应用的关键瓶颈。
行业类比
这类似于在资源受限的嵌入式系统上部署强化学习智能体:模型量化带来的精度损失与策略优化固有的不稳定性叠加,需要专门的数值保护与训练机制才能收敛。
核心洞察
- - **容量-余量假设** 重新定义了 SLM 对齐的前提条件:PPO 性能并不取决于参数规模本身,而是依赖于一个具备流畅生成能力的监督先验(PPL < 20)和一个信息量充足的判别式奖励信号。这一观点与依赖更大模型以求稳定的流行叙事形成鲜明对比,直接引导工程资源投向预训练质量与奖励建模的优化,而非盲目追求模型尺寸。
- - **失败模式的可复现分解** 将小模型 RL 从黑盒调试转变为可诊断的系统工程:论文首次明确识别出三种具体故障——标准 PEFT/TRL 流程中 LoRA 参数的静默冻结、bfloat16 下重要性比率的数值溢出、以及由奖励模型错误引发的灾难性策略崩溃。针对每种故障给出了低成本、可插拔的修复手段(合并重初始化适配器、PPO 更新时切换至 float32、奖励白化与权重回滚等三层安全机制),为从业者构建了可操作的稳定性检查清单。
方法
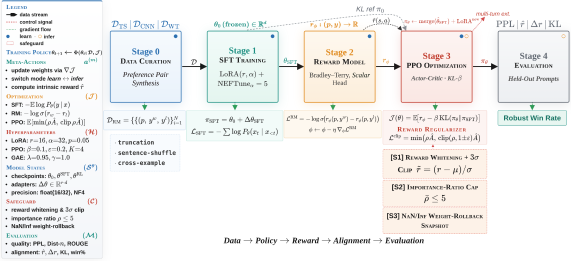
该方法针对 70M–500M 参数的小语言模型(SLMs),提出一套 PPO 稳定训练流程,包含三个核心阶段。
输入:预训练 SLM(如 Pythia-70M/160M/410M、SmolLM2-135M/360M)及文本语料(TinyStories、CNN/DailyMail、Wikitext-103)。
关键模块
- 监督微调(SFT):用领域数据对 SLM 进行标准语言建模训练,获得流畅的先验模型(要求困惑度 PPL < 20),为后续 RL 提供生成基础。
- 奖励模型训练:基于偏好对数据训练一个判别式奖励模型,输出标量奖励信号,用于指导 PPO 优化方向。
- PPO 稳定化微调:针对 SLM 场景中三种可复现的失败模式,设计了相应修复技术:
- LoRA 参数冻结:在
PEFT/TRL管线中,梯度无法有效流入适配器。通过合并-重初始化适配器(merge-and-reinitialize adapter)技术,在每次更新前将 LoRA 权重合并回基础模型并重新初始化,保证梯度流动。 - bfloat16 数值溢出:重要性比率在低精度下易出现无穷大。强制在 PPO 更新时使用 float32 精度计算比率,消除溢出风险。
- 策略崩塌:奖励模型误差可能导致策略分布急剧退化。采用三层安全机制:(1)奖励白化(reward whitening)归一化奖励分布;(2)重要性比率裁剪(importance-ratio guarding)限制单步更新幅度;(3)权重回滚(weight rollback)在 KL 散度超阈值时恢复历史模型。
- LoRA 参数冻结:在
输出:在具有流畅先验和有效奖励信号的配置下,稳定收敛的 SLM 策略,其生成文本的偏好胜率显著高于 SFT 基线。
差异点:与主流 RLHF 直接套用到大模型不同,该方法深入诊断了小模型在 PEFT 联合 PPO 时的独特工程故障,通过轻量级重置与精度控制实现稳定对齐,而非仅依赖扩大模型或数据规模。
实验
实验设计
研究在 15 种 (模型, 语料) 配置 上系统评估 PPO 对齐小语言模型 (SLM) 的稳定性。模型覆盖 Pythia-70M / 160M / 410M 和 SmolLM2-135M / 360M,语料包括 TinyStories、CNN/DailyMail 和 Wikitext-103。流程分为三个阶段:监督微调 (SFT) 获取基础策略,训练独立的 奖励模型,最后进行 PPO 微调。为克服小模型特有故障,引入三项稳定技术:merge-and-reinitialize adapter 防止 LoRA 梯度阻塞,float32 精度 避免重要性比率溢出,以及由 奖励白化、重要性比率裁剪、权重回滚 组成的三层安全机制。
关键发现
实验复现了三种可复现的 失败模式:
- 静默 LoRA 参数冻结:标准 PEFT/TRL 管线中梯度流中断
- 数值溢出:bfloat16 下重要性比率计算易出现无穷大
- 灾难性策略崩溃:奖励模型误差直接导致策略分布坍塌
应用所提稳定技术后,所有实验均稳定收敛。进一步提出 容量余量假设 (capacity-headroom hypothesis):在 SLM 尺度下,PPO 性能主要取决于 流畅的监督先验模型 (PPL<20) 和 有判别力的奖励信号,而非参数规模本身,这颠覆了单纯追求模型大小的惯常做法。
与基线对比
在同时具备 低困惑度先验 (PPL<20) 和 高信息量奖励 的配置中,本方法相比 SFT 基线 获得了 偏好胜率提升 (论文未列具体数值),表明 RL 对齐能有效优化生成策略。此外,与 指令微调基线 相比,仅需 显著更少训练数据 即可达到更优表现,这对数据稀缺的场景具有工程价值。整体表明,小模型 RL 对齐的瓶颈不在模型容量,而在训练稳定性和信号质量,为后续小模型部署提供了可复现的稳健方案。
行业影响
落地场景
该研究系统性地解决了 70M–500M 参数 SLM 在 PPO 微调中的稳定性问题,使低成本、低延迟的 RLHF 对齐在资源受限环境中成为可能。适合部署于:
- 端侧智能助理:手机、IoT 设备上的个性化对话代理,利用 SLM 进行偏好对齐而无需云端推理。
- 内容审核与过滤:电商评论、社交媒体内容自动标注,用小型奖励模型快速筛选低质或有害内容。
- 教育辅导系统:为学生提供交互式解题引导,SLM 可实时适应个体反馈。
商业价值
传统 RLHF 依赖大模型和大量人类反馈,成本高昂。该方案通过 merge-and-reinitialize adapter、float32 精度、三层安全机制 使 SLM 也能稳定利用偏好数据,直接降低计算和标注成本:
- 降本:单次训练只需少数消费级 GPU,使小团队也能迭代 RLHF 流程。
- 体验提升:在流畅先验(PPL < 20)和有效奖励信号下,SLM 对齐后可比肩指令微调大模型,但推理延迟更低,适合实时交互。
- 数据效率:所需偏好数据量显著少于指令微调,标注预算可聚焦于高价值案例。
与现有工作流的集成
该工作流与主流工具链高度兼容:
- Hugging Face TRL/ PEFT 生态:修复了
bfloat16下 LoRA 梯度冻结和重要性比溢出问题,可直接作为现有 PPO 管道的补丁。 - 轻量 CI/CD:将 RLHF 阶段拆分为 SFT→RM→PPO,并附带回滚与数值守卫,适合加入 MLOps 流水线做定期模型刷新。
- 奖励模型热插拔:奖励白化与重要性比裁剪使 RM 切换更鲁棒,企业可根据业务目标快速调整奖励定义。
具体用例
- 电商搜索个性化排序:用小型 RM 学习用户点击/购买偏好,PPO 对齐 SLM 重排序器,实现低延迟个性化,且训练成本仅为大模型的数十分之一。
- 在线教育自适应出题:SLM 根据学生答题结果生成后续题目,RLHF 使其保持难度适中、语言流畅,避免策略崩溃导致无意义输出。
局限
- - **容量裕度假说**的成功条件较严格:要求监督微调基线十分流畅(PPL<20)且奖励信号具有足够判别性,若任何一环薄弱,PPO 性能即会退化。论文未提供在低质量 SFT 或弱奖励模型下的补救策略,而实际场景中构建高区分度的偏好对成本高昂,这在工程落地中构成显著瓶颈。
- - 实验范围集中于 **70-500M 参数**的 SLM(仅 Pythia 与 SmolLM2 系列),并在 TinyStories、CNN/DailyMail、Wikitext-103 三个语料上验证,缺少对更小规模(<50M)、更大规模(>1B)或非自回归架构的测试,且未涉及代码、多语言等任务,泛化能力有待进一步检验。
- - 所提稳定化技术(**合并重初始化适配器、float32 更新、奖励白化、比值防护、权重回滚**)引入额外超参数(如白化窗口、回滚阈值),论文未提供自动调参方案或通用设置指南,实际部署时可能需要大量手工调试,增加了工程复杂度和不稳定性。