OPERA: Offline Policy-guided Expert Routing and Adaptation for Universal Biomedical Image Analysis
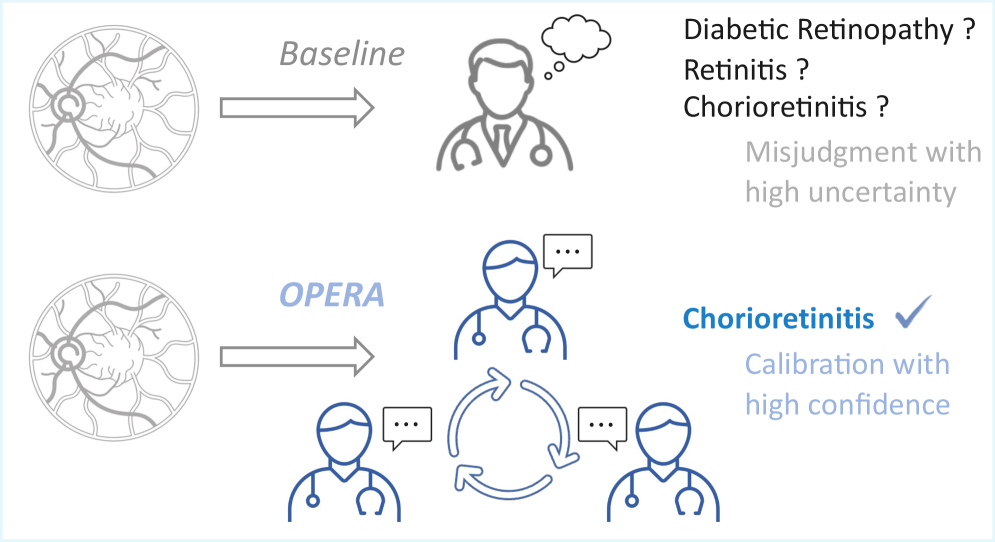
生物医学图像分析涵盖多种模态和任务,然而实际部署受限于扫描仪、协议和患者群体的严重分布偏移。高性能模型因此需要反复进行领域特定的微调,这一过程成本高昂,且在标签稀缺或隐私约束限制数据共享时变得不切实际。 我们提出 OPERA(离线策略引导的专家路由与自适应),一个多智能体集成框架,通过将专家权重分配视为离线策略学习问题来解决部署瓶颈:路由策略 从一个小型验证集中学习,无需对任何专家智能体进行梯度更新,然后结合测试时自适应 来处理分布偏移。OPERA通过互补机制协调异构专家:专家画像模块 离线学习选择策略,实现知识分配的合理性;每个智能体通过温度调整 进行置信度校准,确保更可靠的概率输出;分布感知自适应 在批次级别利用未标记测试数据的统计信息动态调整类别权重;实例级路由 通过模型间一致性和预测熵将每个样本分配给最合适的专家。 我们在9个数据集上评估OPERA,涵盖眼底摄影、胸部X光、CT、MRI和多模态诊断基准,与30多个基线在分类、分割和多模态任务中进行比较。OPERA持续提升性能和校准质量,证明离线策略引导的专家智能体协调是一种无需重新训练即可部署生物医学AI的实用路径。代码已在 https://github.com/HUANGLIZI/OPERA 上开源。
论文精读
TL;DR OPERA 将专家集成权重分配转化为离线策略学习,在不更新模型参数的情况下,实现跨模态、跨任务的生物医学图像分析,显著降低部署成本。
问题
问题背景
生物医学影像分析正走向多模态、多任务统一模型的研发趋势,但在真实临床部署中,数据分布偏移(来自不同扫描仪、成像协议和患者群体)严重阻碍了模型的泛化能力。
现有方法局限
当前应对分布偏移的主流方案是反复进行领域特异性微调,但这一范式存在几个硬伤:
- 标签依赖:每次微调都需要目标域标注,而医学标注成本极高且常受隐私法规限制,数据难以跨中心共享。
- 灾难性遗忘:微调后模型在源域性能急剧下降,无法保持通用能力。
- 多专家独立部署:为不同领域训练多个专用模型虽然简单,却面临资源浪费和推理时模型选择困难的问题,且缺乏跨领域知识共享。 静态集成方法(如固定权重平均)在面对未知分布偏移时表现脆弱,而基于梯度的在线自适应又难以在标注稀缺的医学场景中实现稳定收敛。
为什么这个问题难/重要
医学影像的分布偏移是复合型、非平稳的——成像参数、病灶形态、人口统计差异交织在一起,使得单一模型难以穷举所有变化。业界迫切需要在不引入额外标注、不修改已训练专家模型的前提下,实现对新领域的灵活适配。离线策略学习与测试时自适应的结合恰好切中这一痛点:它既规避了在线梯度更新的隐私与计算成本,又通过实例级路由充分利用多专家互补性。在医疗 AI 从实验室迈向临床落地的关键阶段,这种“即插即用”的泛化能力直接决定技术下沉的成败。
行业类比
该问题与自动驾驶的多传感器融合与域适应高度相似:不同车型、路况、天气构成分布偏移,车辆部署后无法重新标定所有传感器,必须依赖离线标定策略+在线自适应来保障安全。OPERA 的多代理路由思想同样可为这类工业场景提供无需重训练、仅靠策略调度实现跨域稳健推理的解决思路。
核心洞察
- 将专家分配建模为离线策略学习,避免了对专家模型本身的任何梯度更新,从根本上解决了生物医学部署中反复域微调的成本和隐私瓶颈。相较于需联合训练或在线更新的集成方法,OPERA 仅凭少量无标注验证集学习路由策略,大幅降低了计算开销与数据需求,为跨机构模型协作提供了可行路径。
- 在测试时同时引入分布感知的类权重动态调整与基于模型间一致性的实例级路由,使得集成能对未知分布偏移做出即时响应,而无需源域数据或重训练。这种将测试时自适应从单模型扩展至多专家协调的设计,显著提升了模型在 CT、MRI 等多模态场景下的校准质量与分割精度,超越了现有事后校准或固定融合策略。
方法
输入与整体框架
OPERA 接收多源生物医学图像(如眼底彩照、X 光、CT、MRI)及一组预训练的异构专家模型池。这些专家可能采用不同架构(CNN / Transformer)或在不同领域/任务上单独微调。OPERA 的目标是无需对任何专家做梯度更新,仅通过少量有标注验证集学习离线路由策略,并在推理时搭配测试时自适应实现样本级模型编排。
关键模块
专家画像模块 (EPM)
从小规模验证集中,为每个专家学习离线选择策略。该模块将样本特征与专家历史表现关联,输出用于后续路由的专家权重向量,整个学习过程冻结所有专家参数。每专家置信度校准 (PECC)
各专家的输出概率经过温度缩放,使得预测置信度更贴近真实准确率,改善集成时概率融合的可靠性。温度参数在验证集上通过负对数似然优化。分布感知自适应 (DAA)
推理时利用未标注测试数据的批次统计,动态调整每个专家输出的类别先验权重。例如,若某批次中某类别频率异常降低,则提升对应类别的权重以纠正分布偏移,无需标签即可缓解领域漂移。实例级专家路由 (IER)
对每个输入样本,综合模型间一致性(不同专家预测的吻合度)和预测熵(各专家自身不确定性),动态计算各专家的贡献权重,最终通过加权投票或加权平均融合得到结果。若某专家输出高熵且与其他专家分歧大,其权重会被压低。
输出与调度
OPERA 输出融合后的分类/分割结果,以及每样本的专家贡献权重。整个流程可概括为:验证集离线学策略 → 测试时批次级分布校正 → 单样本级动态路由。
与同类方法的差异
传统集成或领域自适应方法常需重新训练或持续在线更新,而 OPERA 将路由抽象为离线策略学习,并结合仅依赖统计量的测试时自适应,彻底避免了重新反向传播,大幅降低部署成本,同时保持对分布漂移的鲁棒性。
实验
实验设计
OPERA 在 9 个生物医学影像数据集 上评估,覆盖 眼底摄影、胸部 X 光、CT、MRI 和多模态诊断 等场景,具体包括 QaTa-COV19、MosMedData+、LA-MRI、Pancreas-CT 等。实验涉及 分类、分割、多模态 LLM 诊断 三大任务,与 30+ 基线方法 对比,并包含充分的消融研究。核心组件 专家画像模块 (EPM)、每专家置信度校准 (PECC)、分布感知适应 (DAA) 与 实例级路由 (IER) 均通过控制变量实验验证贡献。训练仅需一个小型验证集离线学习路由策略,无需对任何专家代理做梯度更新,测试时依赖无标签数据的批次统计进行动态权重调整。
关键发现
- 性能与校准一致性提升:OPERA 在所有数据集和任务上均超越基线,同时显著改善了概率输出的校准质量。
- 分布偏移鲁棒性:测试时适应机制有效缓解了跨扫描仪、协议和人群的分布偏移,避免 expert 频繁重训练。
- 模块协同增益:消融实验表明,各模块独立均能带来提升,联合使用可获得最佳效果。实例级路由通过模型间一致性和预测熵实现精准专家分配。
- 离线策略高效:仅凭离线学习的路由策略,无需在线梯度更新,即可在部署时实现接近甚至超越需重训练方法的性能。
与基线对比解读
与需要 领域特定微调 (domain-specific fine-tuning) 的强基线相比,OPERA 的核心价值在于 摆脱了对重训练的依赖。在标签稀缺或隐私受限的场景下,传统方法每一次新分布都需重复训练,成本极高;OPERA 将专家权重分配转化为离线策略学习问题,利用已有异构专家池和少量验证样本即可完成部署适配。与单纯的 model ensemble 不同,OPERA 通过 温度校准 和 批次级类别权重动态调整 使各 expert 输出更可靠,避免了简单平均带来的不确定性。该框架为生物医学 AI 的实际部署提供了一条 经济、灵活且隐私友好的路径。
行业影响
落地场景
OPERA 框架直接适用于需要多模态、多源生物医学图像分析的医疗 AI 软件产品。典型场景包括:
- 医学影像云诊断平台:接入来自不同医院、不同扫描仪(如 GE、Siemens、Philips)的 X 光、CT、MRI 数据,平台需提供一致的诊断建议。OPERA 可避免针对每家医院的设备重复微调模型。
- 计算机辅助检测与诊断 (CADe/CADx) 系统:用于放射科、病理科的工作站软件,集成专家模型池,通过离线路由策略实时分配最佳专家,提升对不同病例亚型的敏感性。
- 多模态医学大模型应用:如结合影像、文本报告的诊断系统,OPERA 的路由与适应机制可协调多个专家模型处理不同模态输入。
商业价值
- 降本:显著削减领域特定微调的标注采购与算力开销。论文中仅需少量验证集学习路由策略,无需为每个新部署点重新训练大型模型,使模型维护成本从线性增长降低为常数级。
- 增收/体验提升:通过测试时分布适应 (DAA) 与置信度校准 (PECC),提升了模型的校准质量和鲁棒性,减少高风险的误诊与漏诊,增强用户信任,有利于产品的市场准入与合规审批。
- 加速迭代:离线策略学习(EPM)允许快速集成新的专家模型(如新训练的模型或第三方 API),无需改动现有流水线,缩短产品更新周期。
与现有产品/工作流的接口
OPERA 可作为推理网关层部署,位于客户端请求与后端模型池之间:
- 模型流水线集成:在现有的 MLOps 框架(如 KubeFlow、MLflow)中,OPERA 的 Expert Profiling Module 和 Instance-level Expert Routing 可作为独立的微服务,接收请求并动态路由到已注册的专家模型。
- 即插即用适配:专家模型可以是任何已训练的 PyTorch/TensorFlow 模型,无需修改内部结构。OPERA 仅需每个专家输出的 logits 或熵值即可工作,与模型内部细节解耦。
- 与数据工程链路对接:Distribution-Aware Adaptation 模块可利用未标注的测试数据统计实时调整类权重,可与现有的数据漂移检测系统(如 WhyLabs、Evidently AI)联动,触发自动化路由策略更新。
具体落地用例
用例 1:跨机构传染病 AI 筛查网络
某全球健康组织在多个低资源地区的移动诊所部署便携式 X 光设备,用于肺结核筛查。各诊所设备型号、拍摄协议差异巨大,且无法上传原始影像(隐私限制)。基于 OPERA,中心节点可以维护一个由多个在历史数据上预训练的专家模型池,每个模型擅长特定设备条件。当新诊所的 X 光片以匿名化特征形式传入时,路由策略根据输入适应性自动选择最佳专家,并结合批级分布适应处理群体偏差,无需中心端获取标注数据重新训练。这大幅降低了中心端的维护负担,并使筛查灵敏度保持稳定。
用例 2:医学影像 AI 市场(Model Zoo)的推理服务
一个 SaaS 平台为第三方提供可调用的医学影像 AI 模型(如眼底血管分割、肺结节检测)。平台开发者无法预知用户的数据分布,而用户往往只有少量 unlabeled 样例。利用 OPERA,平台可将多个预训练模型组成专家池,向用户提供“自动适配”推理 API。用户只需上传一小批未标注的样本,OPERA 离线学习出针对该用户的最优路由策略,并在每次推理时动态校准。平台无需为每个客户重新训练模型,实现边际成本几乎为零的定制化服务,显著提升商业可扩展性。
局限
- **离线路由政策依赖标注验证集**:OPERA 的专家路由政策在离线阶段需要一个小型验证集来学习权重分配,这在完全无标签的真实部署场景中构成限制。尽管论文声称验证集规模可很小,但假设至少存在一定量标注数据,无法处理严格的 zero-shot 分布外场景。相比之下,一些无监督域自适应或测试时训练方法完全不需标注,OPERA 在标注稀缺极端的条件下可能失效。
- **推理阶段计算与内存开销较高**:框架维护多个异构专家模型,并在测试时进行动态路由、置信度校准和批次级分布适配,导致单样本推理延迟和显存占用显著高于单模型方案。论文虽提供了理论复杂度分析,但未充分对比实际推理吞吐量或 GPU 内存消耗,对于实时性要求高的临床部署,这可能成为瓶颈。
- **专家池构建依赖预先训练,泛化性受限于专家覆盖**:实验中的专家模型来自不同预训练领域,但论文未给出自动选择或增量扩展专家池的准则。当遇到专家覆盖范围外的全新数据分布时,性能可能会下降,且缺少对开放世界持续适应策略的探讨。