SheetSage2: Coherent Lead-Sheet Transcription with Synthetic Supervision
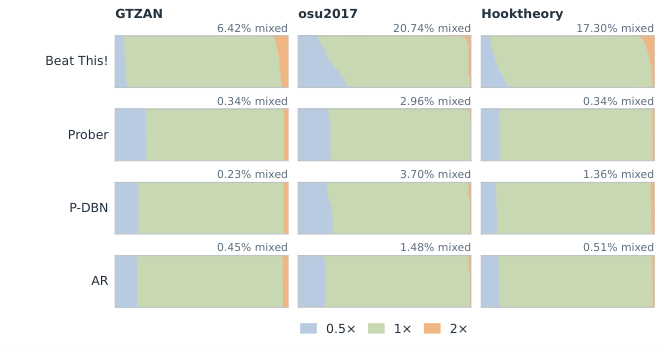
Transcribing music into a human-readable score requires a coherent understanding of rhythm, harmony, melody, and form. Two obstacles limit this goal: annotated recordings are scarce, and accurate local predictions can still produce inconsistent musical sequences. We present SheetSage2, a unified music transcription framework that combines synthetic data, task-specific structured decoding, and autoregressive distillation. Automatically annotated MIDI, rendered into audio, provides scalable supervision across music understanding tasks. Task-specific structured decoders integrate complementary musical cues and their temporal dependencies to produce musically coherent scores. Autoregressive distillation further retains transcription accuracy without task-specific dynamic programming at inference. Across eight benchmark collections, a single SheetSage2-AR model exceeds the listed prior systems on 12 of 15 benchmark--metric pairs in our evaluation, substantially improving over SheetSage1 and surpassing task-specific models on several benchmarks. Model weights and inference code are publicly available.
论文精读
TL;DR SheetSage2 结合合成数据、结构化解码与自回归蒸馏,实现连贯的 Lead-Sheet 转录,在 15 个基准-指标对中 12 个超越先前系统。
问题
问题背景
自动音乐转录(AMT)旨在从原始音频生成人类可读的乐谱,涉及 节奏、和声、旋律、曲式 等多个耦合任务。近年来随着深度学习在音频表示上的进步,该领域逐步从单一音高检测转向完整的 lead-sheet 转录。
现有方法局限
- 标注稀缺:人工对齐的音频-乐谱对极少,传统监督模型难以覆盖多样的音乐风格与录音条件。
- 局部预测与全局不一致:许多模型逐帧或逐片段预测音乐事件,虽然局部准确率尚可,但缺乏对 节拍稳定性、八度连续性、和弦进行逻辑 的建模,容易产生闪烁的节奏或跳变的旋律。
- 结构化解码成本高:为了引入全局约束,早期方法依赖任务特定的动态规划或概率图模型(如 HMM、DBN),这些解码器设计复杂、推理慢,且难以统一扩展到多任务场景。
为什么这个问题难/重要
- 音乐序列具有 层次化时序依赖:一个小节的节拍推断会影响后续和弦边界,旋律音高又受调性与和弦约束,局部错误会沿时间轴累积并放大。
- 合成数据虽能缓解标注稀缺,但 MIDI 渲染音频与真实录音之间存在 音色、混音、演奏偏差 等 domain gap,直接训练容易过拟合合成特征。
- 业界关注:音乐流媒体、生成式音乐、版权分析、音乐教育等场景都依赖可靠的自动转录,当前模型尚未达到实用级一致性。
行业类比
这类问题与 自动语音识别(ASR) 中的声学-语言模型协同类似:声学模型输出局部音素后,需要语言模型消除不连贯序列;音乐转录同样需要一个“音乐语言模型”来保证全局乐理合理,同时避免推理端的高昂动态规划开销。
核心洞察
- SheetSage2 通过合成数据与伪标签 bootstrapping 解决了音乐转录中标注稀缺的核心瓶颈。它从自动标注的 MIDI 渲染音频,再以迭代方式生成更可靠的伪标签,使模型能够在大规模多任务数据上训练。与以往依赖小型人工标注集的系统相比,这一方法显著提升了数据规模和多样性,为音频理解任务提供了可扩展的数据工程范式,适合需要低成本扩充训练集的场景。
- 任务特定结构化解码将音乐先验(节拍、和声、旋律的时序依赖)形式化为动态规划,从而在解码阶段强制输出音乐的全局一致性;随后通过自回归蒸馏将这种结构化知识压缩到纯自回归模型中,推断时无需动态规划即可保持精度。该设计解决了结构化推断在计算上的开销问题,展示了在序列生成任务中利用教师-学生框架兼顾准确率与效率的可行路径,对实时应用尤其具有工程参考价值。
方法
输入 → 关键模块 → 输出
输入:原始音频波形。输出:完整的 lead sheet 乐谱,包含节拍/下拍、拍号、调性、和弦、旋律音高及歌曲结构。
关键模块
合成监督与伪标签引导
利用自动标注的 MIDI 渲染为音频,提供大规模配对数据;同时用已有模型对未标注音频生成伪标签,缓解人工标注稀缺问题。SheetSage2-Prober 多任务前端
一个共享编码器的模型同时预测节奏、节拍、调性、和弦、旋律音高等局部特征,输出各任务的概率分布。任务特定结构化解码
- 节奏/节拍:使用动态规划结合节拍网格先验,强制节拍序列的时间一致性。
- 旋律:引入马尔可夫模型捕捉音高八度连续性,减少局部预测的八度跳变。
解码器利用跨任务线索(如和弦约束旋律音高)提升整体连贯性。
自回归蒸馏
将结构化解码产生的连贯序列作为教师信号,训练单一的 SheetSage2-AR 模型。该模型以自回归方式逐 token 生成乐谱事件,推理时无需任务特定动态规划,直接输出最终 score。
输出
人类可读的 lead sheet 表示,所有音乐元素通过统一的 token 序列编码。
与 SheetSage1 或独立任务模型相比,SheetSage2 依靠合成数据扩展监督,并通过蒸馏将结构化解码的全局一致性迁移到 AR 模型,实现推理高效且多任务联合转录。
实验
实验设计
SheetSage2 在 8 个公开 benchmark 集合上评估,包括 GTZAN、GiantSteps、HarmonixSet、RWC-Pop 等。训练管线利用合成 MIDI 渲染音频作为监督信号,采用 任务特定结构化解码 和 自回归蒸馏 两阶段。模型变体 SheetSage2-Prober 负责多任务概率估计,SheetSage2-AR 通过蒸馏保留精度并去除推理时动态规划。
关键发现
- 单一 SheetSage2-AR 模型在 15 个 benchmark-metric 对中 12 个超过 prior systems,显著优于 SheetSage1。
- 在部分 benchmark 上超越 task-specific 模型,证明合成数据与蒸馏策略有效。
- 结构化解码对节奏一致性与八度一致性带来明显提升(消融验证)。
与基线对比解读
此前 transcription 系统通常依赖 task-specific 解码或单独模型,部署成本高。SheetSage2 通过蒸馏将结构化解码的知识压缩进自回归模型,在多数指标上达到甚至超过专用系统。这为实际工程提供了单模型端到端方案,降低推理复杂度与资源占用,同时保持乐谱连贯性。
行业影响
落地场景
SheetSage2 将任意音频自动转写为 lead sheet(旋律、和弦、节拍、调性、结构),可直接用于音乐流媒体平台的曲库标注、音乐制作软件(DAW)的智能扒谱、在线音乐教育的自动生成练习谱,以及短视频/直播平台的版权检测与音乐内容理解。例如,内容平台可批量解析用户上传音频,提取旋律与和弦指纹,辅助版权匹配与推荐系统。
商业价值
- 降本:替代人工扒谱/标注,单曲处理成本从分钟级人时降至毫秒级 GPU 推理,适合大规模曲库运营。
- 增收:为音乐制作工具提供高级功能订阅点,如自动伴奏生成、编曲辅助;教育产品可按曲谱自动生成难度分级课程。
- 体验提升:实时转录让音乐练习者获得即时反馈,创作者快速获取和弦进行与旋律骨架,缩短创作迭代。
与现有工作流集成
以 DAW 插件或云端 API 形式嵌入现有音频处理管线。输入音频文件 → SheetSage2-AR 输出统一事件流(token)→ 解码为 MusicXML / MIDI → 导入宿主软件或数据库。与 MIR 工具链(如 librosa、Essentia)相比,它直接输出结构化乐谱而非局部特征,省去后处理拼接;可与现有音频指纹系统协同,先粗匹配后精细转录。
具体应用示例:音乐流媒体平台可对每日新上传的数万首歌曲运行 SheetSage2,自动生成和弦标签索引,增强“听歌识曲”与“相似歌曲”推荐;教育类 App 可让学生上传练习录音,实时返回节奏与音准错误定位。
局限
- **合成数据域差距**:虽然使用伪标签 bootstrapping 缓解了标注稀缺,但 MIDI 渲染音频无法完全模拟真实演奏的音色动态、麦克风响应和混响等复杂声学特性。即使有伪标签辅助,模型在真实世界录音上的表现仍可能下降,尤其在非标准乐器或低质量音频场景中。论文未报告在完全未见的真实录音分布上的系统评估,泛化边界不清晰。
- **统一模型与任务特化权衡**:SheetSage2-AR 用单一自回归模型覆盖多任务,简化了流程,但在 15 个基准-指标对中仍有 3 个未超越先验系统,暗示某些子任务(如旋律细节或和弦色彩)可能受益于更专门的架构或解码策略。与高度优化的单任务模型相比,统一模型可能在峰值性能上有所妥协。
- **结构化解码的信息损失**:为推理效率采用自回归蒸馏,替代了任务特定的动态规划,虽然保留了大部分准确度,但可能牺牲了动态规划提供的一些全局一致性保障(如节奏层级约束、和声进行逻辑)。论文未深入分析蒸馏前后在长序列一致性上的量化差异,这在实际乐谱生成中可能累积错误。