SearchJev:面向搜索智能体的快速且经过校准的 System-1 模型
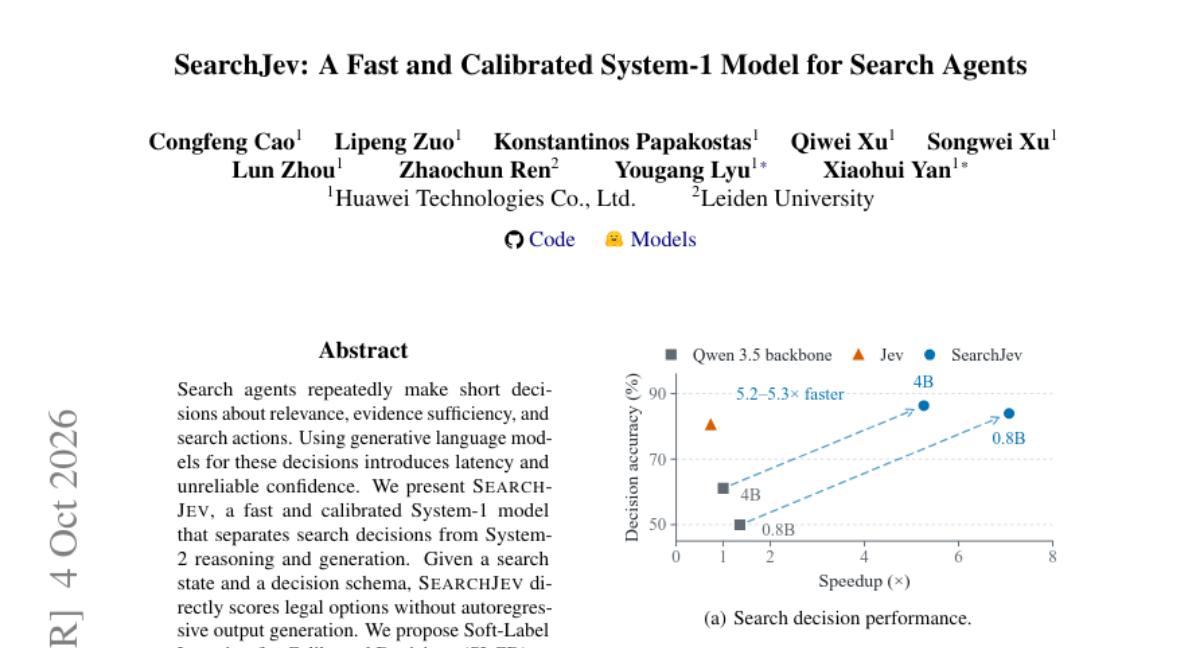
搜索智能体需要反复做出关于相关性、证据充分性与搜索动作的短决策。用生成式语言模型做这些决策会带来高延迟与不可靠的置信度。我们提出 SearchJev,一个快速且经过校准的 System-1 模型,将搜索决策与 System-2 推理和生成分离。给定搜索状态与决策 schema,SearchJev 直接为合法选项打分,无需自回归式输出生成。 我们提出 Soft-Label Learning for Calibrated Decisions (SLCD),从不确定的监督信号中学习决策概率并校准其置信度。在双系统搜索智能体中,SearchJev 负责短决策,把不确定的判断交给 System 2,后者保留规划、查询生成与答案撰写。我们还提出 SearchDecision-Bench,统一六类搜索决策的基准,用于训练与评测。 实验结果: - 在 SearchDecision-Bench 上,SearchJev 的决策质量优于同规模 Qwen3.5 自回归模型,决策速度提升 5.2-5.3 倍,平均期望校准误差降低 41-74%。 - 在 BrowseComp-Plus 上,双系统智能体的主动搜索时间加速 3.7-4.7 倍,答案准确率从 45% 提升至最高 54%。
论文精读
TL;DR SearchJev 用非自回归打分替代 LLM 生成做搜索决策,速度提升 5 倍且置信度更准;双系统协同下搜索时间快 3.7-4.7 倍,准确率从 45% 提升到 54%。
问题
问题背景
搜索智能体在开放域多跳问答、RAG 等任务中需要反复执行短期决策——判断文档相关性、证据充分性、下一步搜索动作。这些决策要求低延迟与可靠置信度,是决定整体搜索效率的关键路径。
现有方法局限
当前主流做法直接调用生成式语言模型(如 Qwen/GPT 系列)逐 token 输出决策结果或 JSON。主要问题:
- 推理延迟高:自回归解码每一步决策都要生成多个 token,即使只需输出一个标签或分值,也无法利用并行计算,导致搜索智能体的 active search 时间成倍增加。
- 置信度不可靠:从生成 token 概率或采样一致性得到的置信度往往未校准,实际正确率与输出概率偏差大,代理无法安全地进行选择性委派。
- 职责混淆:生成式模型把 System-1 的快速判断与 System-2 的深度推理、查询改写、答案生成耦合在一起,难以按需分配计算资源。
为什么这个问题难/重要
搜索决策的学习面临不确定监督:许多决策标签来自弱标注、检索结果排序或人工判断,本身存在噪声与模糊性,传统硬标签训练难以获得校准概率。同时,工业级搜索需要毫秒级响应,校准的置信度是系统1与系统2协同的门控依据:只有系统1判断的不确定性高时才应激活昂贵的系统2推理,否则会浪费算力或错过关键信息。业界对 AI 搜索、多步 RAG、自主代理的关注持续升温,速度和校准度的双重瓶颈是落地的核心障碍。
行业类比
这类似推荐系统中的粗排或召回阶段:用轻量、快速且校准的模型先做筛选,将不确定样本升级到精排或大模型重排序,以在效率与效果之间取得平衡。
核心洞察
- SearchJev 将搜索决策建模为封闭集评分而非生成任务,通过 schema-conditioned 输入与 token-logit 直接读出的方式,使 System-1 决策独立于 System-2 推理。这突破了以往用生成式 LM 处理所有搜索步骤的范式,因为短决策(如文档相关性判断)不需要生成能力,反而会引入 token 级延迟和难以校准的置信度。工程上,这意味着可以在搜索循环中高频调用轻量、低延迟的决策模型,将宝贵的大模型算力留给规划、查询生成和答案合成等 System-2 步骤,从而在端到端代理中实现 3.7-4.7 倍活跃搜索时间加速且精度反升。
- Soft-Label Learning for Calibrated Decisions (SLCD) 针对搜索决策中的监督噪声和置信度失准问题,利用软标签学习决策概率并通过输出类型温度校准,显著降低期望校准误差(ECE)。与标准交叉熵训练相比,它不追求硬标签上的最大似然,而是让模型在不确定时输出更保守的概率分布,为后续的置信度门控委托(delegation)提供可靠依据。这在选择性预测和双系统架构中至关重要:只有系统1知道自己“不知道”,才能把难题交给系统2,避免因过度自信导致错误早停或错误动作。校准能力而非单纯的准确率提升,是搜索代理稳定性的关键工程指标。
方法
输入与输出
输入为搜索状态(当前查询、已收集证据、候选动作或文档)和决策 schema(定义当前步骤的合法选项与输出类型)。输出为对每个合法选项的决策概率打分,以及是否需委托 System-2 的信号。
关键模块
Schema-conditioned direct decision
SearchJev 不执行自回归 token 生成,而是将搜索状态与 schema 拼成一次前向输入,通过 token-logit decision readout 直接读取各个合法选项对应的 logit,归一化后得到每个选项的决策分数。这种 direct decision inference 避免了逐 token 生成的开销,使单次决策速度提升 5.2–5.3 倍。SLCD(Soft-Label Learning for Calibrated Decisions)
训练不使用硬标签,而是从不确定监督(例如弱标注、规则或 LLM 蒸馏产生的软标签分布)学习。核心包括:- soft-label supervision 保留标签不确定性,防止过度自信;
- decision probability learning 让模型直接优化选项概率分布;
- output-type temperature calibration 根据输出类型(如二分类、多选、排序)分别校准温度,降低 expected calibration error 41–74%。
Dual-system delegation
每个决策输出置信度。confidence-gated delegation 设置阈值:高置信度时直接执行搜索动作并更新状态;低置信度时委托给 System-2(负责规划、查询生成、答案合成)。这样高频短决策由 System-1 快速处理,少数困难判断交由 LLM,在 BrowseComp-Plus 上实现 3.7–4.7 倍主动搜索加速,同时准确率从 45% 提升至最高 54%。
差异点
与直接让 LLM 生成完整决策(如输出 yes/no 或新查询)不同,SearchJev 通过 schema-conditioned 分类头 一次性对所有选项打分,并把置信度校准作为训练目标,而非事后校准,更适合搜索代理中大量短决策场景。
实验
实验设计
在 SearchDecision-Bench 上统一评测六类搜索决策,对比同尺寸 Qwen3.5 自回归模型。评估指标包括决策质量、决策速度和平均期望校准误差(ECE)。端到端评测使用 BrowseComp-Plus,搭载 SearchJev 作为 System-1、保留 System-2 负责规划、查询生成与答案合成。
关键发现
SearchJev 在 SearchDecision-Bench 上决策质量优于基线,速度提升 5.2–5.3 倍,ECE 降低 41–74%。端到端双系统代理在 BrowseComp-Plus 上主动搜索时间加速 3.7–4.7 倍,答案准确率从 45% 提升至最高 54%。
与基线对比
相比自回归生成式决策,SearchJev 通过 token logit 直接读出决策,避免逐步生成,显著降低延迟。软标签学习(SLCD)从不确定监督中学习决策概率,大幅改善校准。置信度门控委托机制将低置信判断交给 System-2,在速度与准确率之间取得平衡,验证了系统分离的设计假设。
行业影响
落地场景
SearchJev 适用于任何需要高频、低延迟搜索决策的 AI 产品,例如:
- 企业知识库检索:在 RAG 流程中快速判断文档块相关性,替代或辅助 LLM 重排序,降低首 token 延迟。
- 电商商品搜索:对候选商品做轻量级相关性打分,决定是否展示或进行深度匹配。
- 内容平台推荐:在信息流或搜索中快速过滤低质量候选,将复杂判断留给大模型。
商业价值
- 降本:决策无需自回归生成,单次推理成本从 LLM 的 token 级计费降为一次前向传播,且 5 倍以上速度提升意味着相同硬件可支撑更高 QPS。
- 体验提升:校准后的置信度可直接用于置信门控,减少错误决策对用户结果的影响,在 BrowseComp-Plus 上准确率从 45% 提升至 54%,同时搜索耗时缩短 3.7–4.7 倍。
- 可靠性:Soft-Label Learning 从不确定监督中学习概率分布,平均期望校准误差降低 41–74%,使代理在不确定时能正确委托 System-2,避免盲目行动。
与现有产品/工作流的接口
SearchJev 可作为一个决策模块嵌入现有 agent 或 RAG 框架:
- 在 LangChain / LlamaIndex 等编排层中,将其注册为自定义 retriever 或 reranker,输入搜索状态与决策 schema,输出选项分数。
- 对于已有大模型搜索代理,可通过双系统架构替换短决策路径:System-1 调用 SearchJev,System-2 保留查询生成与答案合成。
- 模型本身可部署为轻量级服务(如 ONNX/TensorRT),与现有向量数据库、搜索 API 无缝衔接。
具体 use case:
- 电商搜索:用户输入“适合露营的轻量帐篷”,SearchJev 快速判断商品标题、属性与查询的相关性,过滤掉 90% 不相关商品,仅对 top 候选交给大模型生成推荐理由,整体响应时间从 2 秒降至 0.5 秒,且准确率不降。
- 企业法务检索:律师查询“数据跨境合规案例”,SearchJev 对合同库、判例库做证据充分性判断,若置信度低于阈值则触发大模型进行深度分析,节省 70% 的 LLM 调用量。
局限
- **SearchDecision-Bench** 虽然统一了六类搜索决策,但其数据构造依赖既有数据集并经过后处理标注,可能存在标注噪声与分布偏差,且未在真实在线搜索流量中验证。因此基准上的性能增益可能高估部署后的实际效果,尤其是低资源决策类型或跨领域泛化时。此外,评估指标聚焦于决策质量、速度与校准误差,对端到端搜索成功率的贡献仅在 **BrowseComp-Plus** 上间接体现,缺乏对用户级满意度或长期搜索会话影响的系统分析。
- **SearchJev** 的核心假设是搜索决策可以分解为独立的选项打分,但复杂的搜索策略往往依赖长程上下文与多步骤状态依赖,直接 token-logit 打分可能丢失中间推理信息。虽然双系统代理通过置信度门控将不确定判断委托给 System 2,但委托阈值与校准策略需要领域适配,论文未讨论不同搜索场景下阈值漂移问题,这可能限制其跨任务即插即用的能力。
- 与通用 LLM + 提示词的方案相比,**SearchJev** 虽然显著降低延迟并提升校准,但它不是通用决策模型,每新增一类搜索决策都需要构建 schema 并重新训练或适配,工程维护成本较高。同时其性能继承自基座模型 **Qwen3.5**,若未来基座升级,需要重新进行软标签学习与输出温度校准,迁移成本不可忽视。