DeCoPrune:通过去噪一致性实现自回归视频扩散的高效 KV-Cache 剪枝
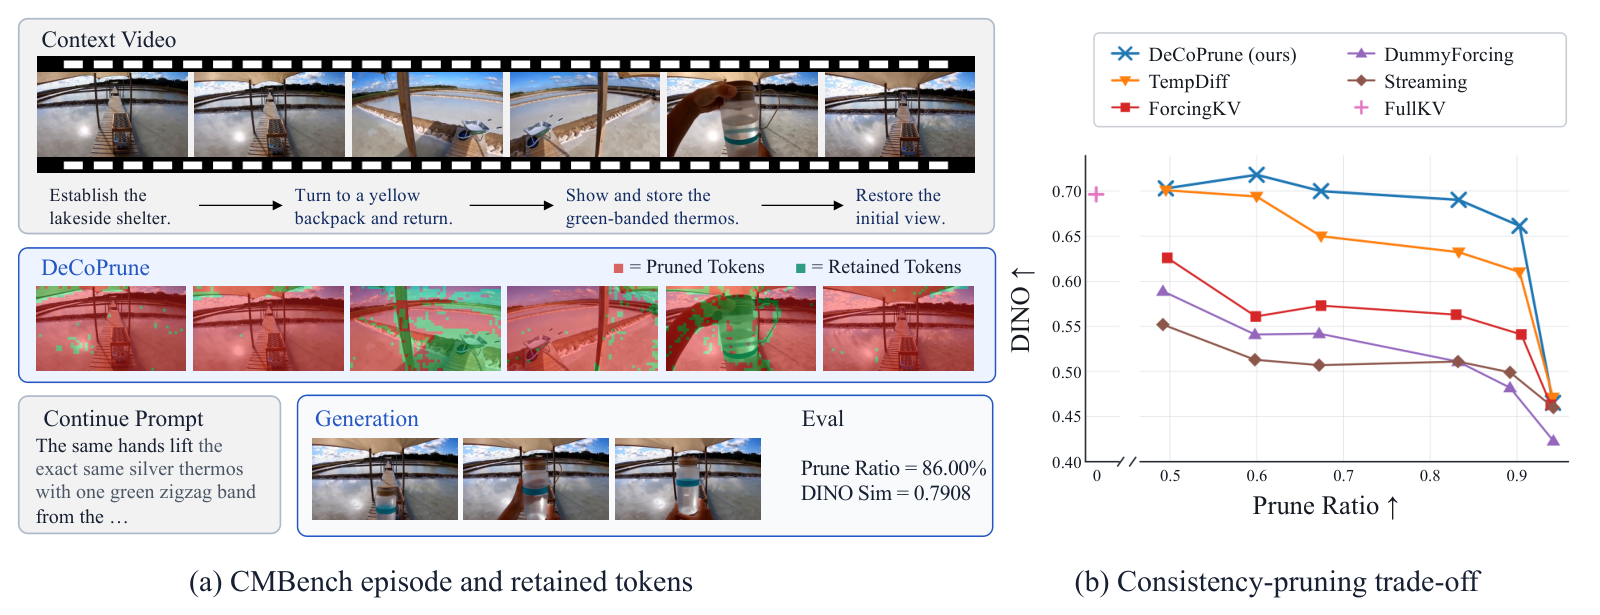
自回归视频扩散支持流式生成与交互式控制,但其 KV cache 会随生成历史持续增长。现有压缩策略要么用固定窗口丢弃历史,要么依赖局部注意力与相似度信号挑选 token,都无法直接衡量当前 chunk 是否带来保留上下文之外的信息。 DeCoPrune 是一种免训练方法,把 cache 压缩视为去噪一致性 问题。作者发现,去噪难度可作为 token 长期保留价值的代理:step-to-final 差异越大的 token,越可能携带难以从保留上下文预测的视觉证据。该方法以中间干净预测与最终去噪值之间的差异度量去噪难度,保留高差异 token,剪除低差异 token。 为评估信息保留,作者提出 CMBench,含 58 条约一分钟的生成或真实世界上下文片段,以及 116 项 Reappear/Revisit 续写任务,需要回忆此前观察到的特定物体或场景。在 LingBot World v2 上,DeCoPrune 剪除超 85% 历史 KV token,仍逼近 FullKV 的远程召回能力,续写生成加速逾 4 倍,在可比预算下明显优于所评估的压缩基线。 这些结果表明,去噪一致性可作为模型内在信号,在降低自回归推理成本的同时保留长程信息。项目主页:https://decoprune.github.io
论文精读
TL;DR DeCoPrune 利用去噪一致性——token 中间干净预测与最终值的差异——作为缓存 token 重要性指标,训练无关地剪除 85% 历史 KV,自回归视频扩散仍保持近 FullKV 长程回忆并加速 4 倍。
问题
自回归视频扩散模型如 LingBot World v2 支持流式生成与交互控制,但 KV cache 随生成历史线性膨胀,导致显存与延迟持续上升。
现有方法局限:固定窗口策略直接丢弃早期 token,切断长期依赖;基于局部注意力或 token 相似度的选择方法,仅从局部关联或相似度得分出发,没有直接度量一个 token 是否携带超出已保留上下文的额外信息。这类启发式信号在需要回忆先前出现过但当前不活跃的对象时常常失效,可能保留大量可预测的冗余 token,同时丢弃关键视觉证据。
为什么难/重要:难点在于如何定义 token 的长期信息价值,且保持训练无关。视频 token 同时具有空间冗余和时间冗余,去噪轨迹中蕴含的“可预测性”差异未被充分利用。该问题直接影响长视频生成、交互式叙事与世界模型等应用,因为 KV cache 若不压缩则显存爆炸,压缩过度则损害长期记忆,业界对高效长上下文视频推理有迫切需求。
行业类比:类似于 LLM 推理中的 KV cache 压缩,但视频 token 需要更精细的语义级筛选,而非粗粒度滑窗或 attention 分数排序。
核心洞察
- DeCoPrune 将 KV 缓存剪枝的核心信号从静态 token 重要性转向动态去噪一致性。传统方法用固定窗口或局部注意力/相似度,只度量 token 间关联,无法判断当前 chunk 是否提供超出已保留上下文的新信息。DeCoPrune 计算 token 中间 clean prediction 与最终 denoised value 的差异,差异大代表去噪难度高,说明其视觉证据难以从历史预测,值得长期保留。该信号直接来自模型自身去噪过程,训练无关,天然对齐自回归扩散的生成动态。
- CMBench 通过 Reappear/Revisit 任务把长视频生成评测从短期生成质量转向长期上下文记忆。现有指标如 FVD 或 CLIP 相似度关注帧间一致性或短期语义,无法检验模型在一分钟上下文后回忆特定对象/场景的能力。CMBench 包含 58 个约一分钟真实或生成上下文与 116 个延续任务,迫使压缩模型在剪枝 85% 以上 KV token 后仍能准确找回先前出现的事物,揭示压缩方法在信息保留上的真实瓶颈,为后续 KV 缓存剪枝和长视频生成研究提供了应用级评估协议。
方法
输入
自回归视频扩散模型当前生成 chunk 的 tokens 及其对应 KV cache,同时持有历史保留 cache。
关键模块
- 去噪一致性评分:对每个当前 chunk token,记录其去噪过程中某中间时间步的干净预测与最终去噪值的差异,将该差异作为 token 的 去噪难度 代理。经验表明,高差异 token 携带的视觉信息更难从已保留的上下文预测,长期保留价值更高。
- Token 选择与剪枝:按差异分数排序,保留高差异 token 进入长期 cache,剪枝低差异 token。该方法完全训练无关,无需额外参数。
- Cache 更新与位置编码处理:实现细节包括 前缀剪枝 (Prefix Pruning) 减少冗余历史,RoPE 重索引 (RoPE re-indexing) 补偿剪枝后的位置编码错位,以及 头特化变体 (Head-Specialized Variant) 为不同注意力头定制剪枝策略。
输出
压缩后的 KV cache 用于后续 continuation 生成,实验中剪枝超过 85% 历史 KV token 且加速 4 倍以上,同时保持接近 FullKV 的长期回忆能力。
与同类方法的差异
与基于固定窗口或局部注意力/相似性信号的压缩方法不同,DeCoPrune 利用去噪一致性作为模型内在信号,直接衡量当前 chunk 对保留上下文的边际信息贡献,而非间接启发式。
实验
实验设计
我们在 CMBench 基准上评测 DeCoPrune,该基准包含 58 个约一分钟的生成或真实世界上下文片段,以及 116 个 Reappear / Revisit 续写任务,要求模型回忆先前出现的物体或场景。骨干模型为 LingBot World v2,对比方法包括 FullKV 与多种固定窗口、局部注意力、相似度信号等压缩基线,在相同缓存预算下比较长程召回与生成速度。
关键发现
- 剪枝比例:DeCoPrune 移除超过 85% 的历史 KV token,显著降低缓存规模。
- 加速效果:续写生成加速超过 4×,提升推理效率。
- 召回性能:长程召回接近 FullKV,证明去噪一致性信号能有效保留关键视觉证据。
基线对比解读
现有压缩策略或依赖固定窗口丢弃历史,或基于局部注意力与 token 相似度选择,未直接度量当前 chunk 是否贡献超出已保留上下文的信息。DeCoPrune 将缓存压缩建模为去噪一致性问题,利用中间干净预测与最终去噪值的差异衡量 token 的不可预测性,保留高差异 token。这一设计在同等预算下大幅超越基线,表明去噪难度可作为模型内在的长期记忆价值信号,为长视频扩散模型的推理优化提供了训练自由、可插拔的新思路。
行业影响
落地场景
DeCoPrune 可嵌入任何依赖自回归视频扩散模型的流式生成或长视频续写产品,例如:
- AI 短剧/虚拟主播:持续生成几分钟剧情,角色与场景需在后续片段中一致再现;
- 交互式产品演示:电商场景中用户通过对话实时调整商品展示视频,模型需记住已出现的产品细节;
- 游戏/元宇宙 NPC:实时生成的视频内容需在长时间会话中保持环境与物品记忆。
商业价值
核心收益来自推理成本下降与交互体验提升两条线:
- 降本:剪枝 85% 的历史 KV token 并加速 4 倍以上,直接减少 GPU 内存占用与每 token 生成延迟,使得长视频续写任务在同等硬件上可支持更多并发请求;
- 体验:相比固定窗口或局部注意力等基线,DeCoPrune 在长程回忆任务上接近 FullKV 表现,避免生成内容出现前后不一致(如角色物品消失、场景突变),这对付费用户留存和内容质量至关重要。
与现有工作流的接口
DeCoPrune 是训练无关的缓存剪枝模块,可作为推理时的轻量插件集成到现有自回归视频扩散管线(如 LingBot World v2)中:
- 在每次生成 chunk 后,计算 token 的去噪难度(中间预测与最终去噪值的差异);
- 根据阈值保留高难度 token 到长期 KV cache,低难度 token 直接丢弃;
- 配合 RoPE 重索引 处理位置编码,无需修改模型权重或训练流程。
该方案与模型架构解耦,可快速适配不同自回归视频扩散模型;配套的 CMBench 基准(58 个一分钟上下文、116 个回忆/重访任务)为工程团队提供了标准化的长程记忆评测工具,降低选型与调参成本。
局限
- - **泛化性局限**:论文仅在 **LingBot World v2** 单个模型上验证,缺乏在其他自回归视频扩散模型(如其他流式生成架构)上的实验。不同模型的去噪过程和 token 重要性分布可能存在差异,`denoising consistency` 信号的有效性不一定能直接迁移,需要更多模型验证其通用性。
- - **超参数敏感性**:方法依赖 **probe timestep** 和 **consistency threshold** 等超参数,论文虽做了消融但未提供自动选择机制。实际部署时,这些参数可能需要针对不同任务或模型手动调节,增加了调参成本,也限制了即插即用的易用性。
- - **基准覆盖范围**:**CMBench** 目前包含 58 个上下文片段和 116 个继续任务,规模相对较小,且主要聚焦物体重新出现和场景重访两类长期记忆。对更复杂的语义关联、多步推理或长期一致性的评估可能不足,需要更大规模和更多样化的基准来进一步检验。