大型语言模型中的注意力机制演进:机制、权衡与新兴趋势
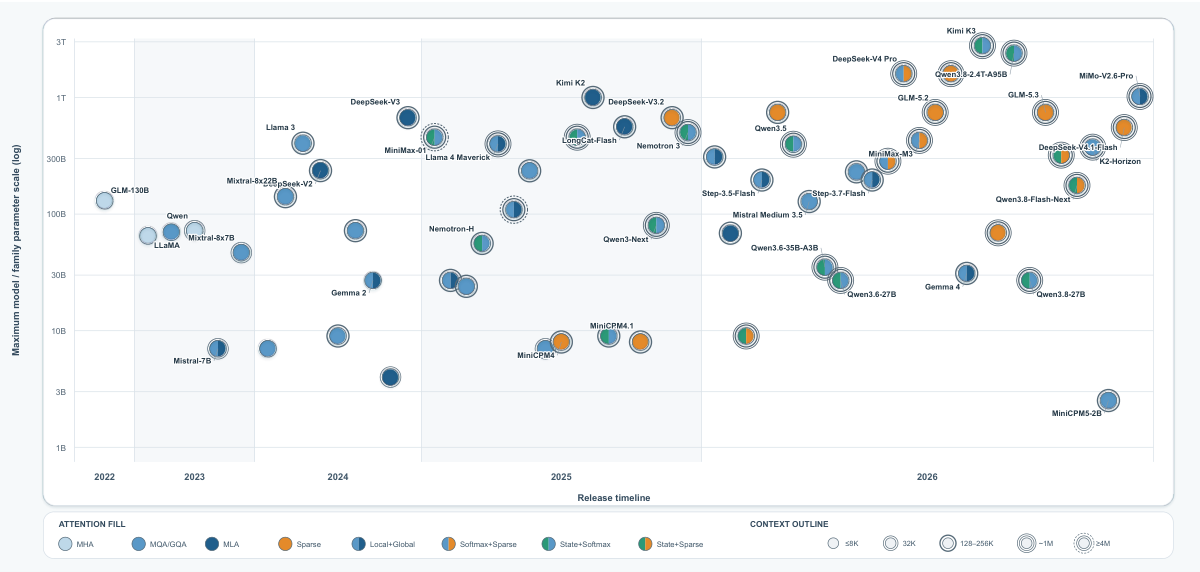
Self-attention 为 LLM 提供细粒度、query-dependent 的上下文访问,但 dense token 交互带来 quadratic prefill 开销,且 key--value cache 随上下文长度增长。相关研究因此覆盖 explicit-memory 压缩、稀疏访问、recurrent state 构造、结构化状态动力学与异构机制组合。 本综述以 model-internal contextual memory 为统一视角,提出五维分析框架: Memory Representation、Memory Update、Access、Readout 与 Integration,分别刻画表示什么、如何变化、哪些可被 query 检索、如何读取,以及读出如何形成输出,从而在不强加单一计算模型的前提下比较相互重叠的研究路线。 基于来自 14 个主要模型谱系与 11 个高性能 open-weight 端点的 59 条 release-level 记录,我们重建了机制层面的发展与架构采纳情况: 1. explicit-memory 与 recurrent-state 方法保留各自接口,但在记忆功能上日益重叠; 2. 异构架构越来越多地跨网络深度协作 —— layer-wise 组合在不同表示阶段分配互补的记忆处理,cross-layer reuse 向前传递被选中的记忆与路由产物,使 深度 成为上下文记忆构建与管理的维度; 3. 由此提出 stateful 多维记忆路由假说:持久记忆按 temporal scope、网络深度、substrate type 与表示粒度组织,并由协同的 Sparse Write 与 Sparse Read 决定维持什么、以及哪些内容参与每次 query。 总体而言,高效序列架构设计的核心正从孤立的 Attention operator 转向上下文记忆的组织、生命周期与选择性使用。
论文精读
TL;DR 系统梳理 LLM 注意力机制从 dense self-attention 到稀疏、线性、状态空间与混合架构的演进,提出五维记忆视角与状态化多维记忆路由假设,为高效序列架构设计提供统一分析框架。
问题
问题背景
大语言模型依赖自注意力实现细粒度、查询相关的上下文访问,但密集 token 交互带来 二次预填充成本 与随上下文线性增长的 KV cache 内存,成为长上下文部署的主要瓶颈。研究重心正从“优化注意力算子”转向“设计模型内部上下文记忆”。
现有方法局限
已有工作分别尝试:
- 显式记忆压缩(如 recurrent KV-slot memory)会牺牲 token 级高精度信息;
- 稀疏注意力(固定/动态 token grouping、block aggregation)依赖手工 pattern 或事后发现,召回率不稳定;
- 线性注意力/SSM 的状态更新适合长程摘要,但难以完成精确 token 级查取(precise recall);
- 异构混合架构 缺乏统一设计原则,layer-wise/head-wise/branch-wise/token-wise 组合搜索成本高,跨层记忆复用缺少生命周期管理标准。
为什么难/重要
核心挑战在于表达力、计算、内存与查询特异性不可同时满足:维持 O(1) 状态更新就难以保留任意 token 的恒等映射;按查询路由又必然引入额外路由开销。业界高度关注,因为长上下文推理、多轮 Agent、代码库理解等场景要求模型在百万 token 上下文中保持低延迟和可控显存。论文提出的 stateful multidimensional memory-routing hypothesis 将问题从孤立 Attention 算子提升为持久记忆的组织、生命周期与选择性使用问题,决定下一代高效序列架构走向。
一句行业类比
类似推荐系统中的“召回—精排”机制:模型需要先低成本维护海量上下文索引,再按当前 query 精确读取相关 token,而不必每次全量重算。
核心洞察
- 注意力机制本质上应被视为模型内部上下文记忆的构建、更新与访问问题,而非孤立的计算算子。该论文引入五维分析框架(Memory Representation / Memory Update / Access / Readout / Integration),将显式内存、稀疏注意力、线性注意力、状态空间模型和混合架构统一到同一抽象下。相比传统综述按计算复杂度或模型类别分开讨论,这一视角揭示了不同方法在记忆生命周期中的重叠与互补,为统一优化提供了概念基础。
- 网络深度正在成为上下文记忆组织与路由的新维度:异构架构通过层间组合指派互补记忆处理,并通过跨层复用传递选定的记忆与路由工件。论文进一步提出有状态多维记忆路由假设,主张按时间范围、深度、基板类型和表示粒度组织持久记忆,由 Sparse Write / Sparse Read 决定维护与查询贡献。这突破了单层注意力模式或 KV cache 压缩的局部优化思路,指向系统级联合设计写入与读取策略的新方向。
方法
本论文采用系统综述方法,输入为 2017 至 2024 年注意力机制相关论文、模型发布记录与技术报告,共收集 59 条 release-level 记录,覆盖 14 个主要模型谱系与 11 个高性能开放权重端点。
关键模块按以下流程组织:
- 统一记忆视角:定义五个分析维度——
Memory Representation、Memory Update、Access、Readout、Integration,将不同注意力变体映射到同一框架。 - 机制分类与重建:按 Softmax Attention、Sparse Attention、Linear Attention、State Space Models、Hybrid Architecture 五大族分类,对每类子方法(如共享头、序列压缩、动态稀疏路由、状态编辑、层/头/分支混合)进行机制级拆解。
- 演进数据分析:利用 release-level 记录追踪架构采用路径,结合已发表实验与诊断结果,比较各方法在预填充成本、KV 缓存增长、长程建模能力等方面的权衡。
输出包括:(a) 五维分类表与家族映射;(b) 技术差异与适用场景对比;(c) 提出有状态多维记忆路由假说:持久记忆按时间范围、网络深度、基底类型、表征粒度组织,由协调的稀疏写入与稀疏读取决定维护与查询贡献。由此总结设计重心从孤立 Attention 算子转向上下文记忆的全生命周期管理。
与以往聚焦单一机制或仅做定性分类的综述不同,本文通过可操作的记忆维度与发布级数据,将跨机制比较落到可工程化的设计权衡上。
实验
实验设计
该综述采用系统文献分析,覆盖 14 个主要模型家族和 11 个高性能开源权重端点的 59 条发布级记录。通过引入五维分析框架(Memory Representation、Memory Update、Access、Readout、Integration)对注意力机制演进进行统一解构,比较不同研究路线的机制层面发展。
关键发现
- 显式记忆与循环状态方法保持不同接口,但越来越多地控制重叠记忆功能。
- 异构架构在网络深度上协调:层间组合在不同表示阶段分配互补记忆处理,跨层复用传递选定记忆和路由产物。
- 提出有状态多维记忆路由假说:持久记忆在时间范围、网络深度、底层类型和表示粒度上组织,Sparse Write 和 Sparse Read 共同决定维护内容与查询贡献。
对比与解读
与传统将 Attention 视为孤立算子的视角不同,文章指出高效序列架构设计正转向对上下文记忆的组织、生命周期和选择性使用的整体管理。该视角对实际工程启示:优化重点应从单一算子的计算效率,转向记忆更新与访问策略的协同设计,例如压缩、稀疏路由和状态编辑的组合。未来的序列模型可能通过多维路由机制自适应调节记忆读写,以平衡精度与效率。
行业影响
落地场景
长上下文文档理解 与 实时对话系统 可直接受益:客服机器人、法律/金融合同解析、医疗病历摘要、代码库问答等需处理 100K+ token 的场景。电商平台 的个性化推荐与评论分析,可基于稀疏注意力在长用户行为序列上降低延迟;内容平台 的审核/摘要服务可在视频转录文本上使用线性注意力与状态空间模型,提升处理吞吐。
商业价值
主要在 降本 与 体验提升:压缩 KV cache 降低 GPU 显存占用,使单卡可服务更长上下文;稀疏/线性注意力减少 prefill FLOPs,提升吞吐量。例如采用 分组查询注意力 或跨层 KV 共享,推理成本可降低 30-70%(视任务而异),同时保持生成质量。对实时交互产品,更低的 first-token latency 直接改善留存。
与现有产品/工作流接口
可在主流推理栈中渐进式集成:将现有 Transformer 的 self-attention 替换为混合注意力层,保留 Hugging Face / PyTorch 接口,通过自定义 CUDA kernel 或 Triton 实现新算子。异构架构(如 attention + SSM hybrid)可通过层分配策略逐步引入,避免一次性重训。模型服务层(vLLM/TensorRT-LLM)需对新 attention 的 cache 布局做适配,但接口兼容可降低迁移成本。
局限
- 作为一篇综述,本文未提出新的模型或算法,其核心贡献在于提出五维分析框架和“状态性多维记忆路由假说”,这些概念性框架缺乏实验验证或量化指标,难以直接指导工程实现。对于希望获得具体算子优化建议的从业者,本文更多提供分类和趋势启发,而非可落地的技术方案。
- 文献覆盖范围有一定局限:仅基于 14 个主流模型家族和 11 个高性能开放权重模型,可能遗漏了较小众但创新的工作,尤其是未公开发布细节的工业模型。同时,分析建立在论文公开信息上,实际部署中的工程细节(如算子融合、显存优化)难以反映,削弱了对真实系统设计的参考价值。
- 与现有高效注意力综述相比,本文提出的五维框架虽力求全面,但维度定义较为抽象,可能无法清晰地映射到具体算子的设计选择。例如,不同类别(如线性注意力与状态空间模型)在“Memory Update”维度上的区分度不够明确,实际模型往往跨越多个类别,导致分类体系的可操作性受限,读者在应用该框架时可能面临归类困难。