合成预预训练在规模化下依然有效,但并非作为语法先验
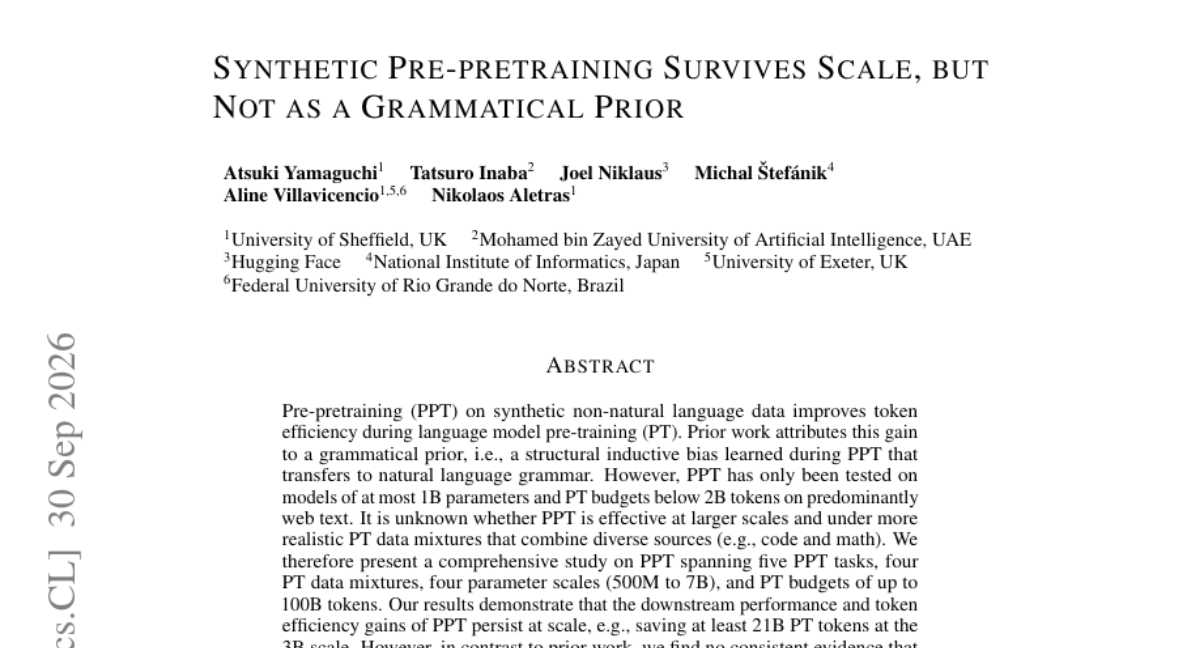
Pre-pretraining (PPT) 是在合成非自然语言数据上进行的预预训练,可提升语言模型预训练 (PT) 的 token 效率。先前工作把这一收益归因于语法先验 (grammatical prior),即在 PPT 阶段学到、可迁移至自然语言语法的结构归纳偏置。但 PPT 此前仅在最多 1B 参数、PT 预算不足 2B token、且以网页文本为主的设定下得到验证。 本文开展了一项系统性研究,覆盖 5 个 PPT 任务、4 种 PT 数据混合、4 个参数规模(500M 至 7B),以及最高 100B token 的 PT 预算。 结果显示:下游性能 与 token 效率收益在规模化后依然成立,例如在 3B 规模下至少节省 21B 个 PT token。但与先前工作相反,我们未发现一致证据表明这些收益来自语法先验——在不同模型规模下,下游性能与语法可接受度并不一致地对齐。收益实际上来自能够提升长程检索 (long-range retrieval) 的 PPT 任务。 此外,收益对 PT 数据混合的构成方式较为稳健,只有当网页文本完全缺失时才会减弱。总体而言,PPT 是 PT 的低成本补充,未来 PPT 任务设计应面向长程检索,而非自然语言语法。
论文精读
TL;DR 大规模验证表明,合成预预训练(PPT)在 7B 模型上仍可节省至少 21B token,但其收益并非源于语法先验,而是长程检索能力。
问题
问题背景
预训练效率一直是语言模型领域的核心关切。随着模型参数和预训练 token 预算不断攀升,社区开始探索合成预训练 (Synthetic Pre-pretraining, PPT):在正式预训练前,用非自然语言的合成数据训练模型,以期提高后续自然语言预训练的 token 效率。
现有方法局限
先前 PPT 研究主要存在两个局限:
- 验证规模不足:仅在 ≤1B 参数模型、≤2B token 预训练预算、且以 web text 为主的单一数据分布下测试,无法说明在更大规模或更真实的数据混合物(如同时包含 code、math 等来源)下是否依然有效。
- 机制归因存疑:之前将 token 效率提升归因于 grammatical prior(语法先验),但该结论缺乏在大规模设置下的实证支持,更未比较不同 PPT 任务类型对下游能力的差异化影响。
为什么这个问题难且重要
大模型预训练成本极高,任何能节省 token 的方法都极具工程价值。然而,若不清楚收益的真正来源,后续 PPT 任务设计可能错误优化:例如万一实际提升来自 long-range retrieval 而非语法归纳,那么继续设计面向语法的合成任务将事倍功半。本文通过跨 500M–7B 参数、最高 100B token 预算、五种 PPT 任务和四种数据混合物的系统实验,揭示了收益可扩展(如 3B 规模节省至少 21B token),但机制并非语法先验。
行业类比
这类似于在视觉预训练中使用 Jigsaw puzzle 等合成自监督任务:仅验证下游指标提升不够,必须明确何种可迁移表征 被学到,否则难以泛化到目标分布之外的实际场景。
核心洞察
- 合成预预训练(PPT)在大规模下依然带来 token 效率增益,但其作用机制并非此前假设的语法先验,而是长程检索能力。不同于先前工作仅在 ≤1B 参数和 <2B tokens 预训练预算上观察并归因于语法先验,本文在 500M 至 7B 参数、最多 100B tokens 设置下发现,下游性能与语法可接受性并不一致,却与改进长程检索的 PPT 任务相关。这一机制转变对 PPT 任务设计具有直接指导意义:应聚焦长程依赖而非模拟自然语言语法。
- PPT 性能增益对预训练数据混合组成具有鲁棒性,但当 web text 完全缺失时增益消失。既有研究多用纯 web text,本文系统测试了包含代码、数学等不同数据混合,发现 PPT 增益在多种混合下仍保留。但去除 web text 后收益消失,表明 PPT 的效益可能依赖自然语言数据的特定统计结构,而非跨领域通用。这界定了 PPT 作为低成本预训练附加手段的适用条件,工程上应优先在包含 web text 的流程中采用。
方法
输入
研究输入包含五类 pre-pretraining (PPT) 任务与四类 pre-training (PT) 数据混合。PPT 任务划分为:形式语言 k-Shuffle Dyck、结构化合成任务 MP-Struct Core、Set、NCA,以及域内文本控制任务。PT 数据混合覆盖网页文本、代码、数学等不同配比,部分混合不含网页文本以测试稳健性。
关键模块
整体流程为两阶段:PPT → PT。
- PPT 阶段:在合成非自然语言数据上训练模型,获得初始化权重。该阶段数据量远小于后续 PT,目的是提供有效的归纳偏置与权重初始化。
- PT 阶段:在混合多域数据上继续预训练,预算最高 100B tokens,模型规模覆盖 500M 至 7B 参数。
- 评估模块:下游通用能力(如推理、知识)与语言能力(BLiMP 语法可接受度、verbatim retrieval 长程检索)双线评估。
输出与分析
输出为不同规模下的下游性能、token 效率增益(例如 3B 规模可节省至少 21B PT tokens),以及各 PPT 任务对收益的贡献。通过对比语法可接受度与下游性能的相关性,以及变化 PT 数据混合成分,检验“语法先验”假设是否成立。
与同类方法的差异
以往工作仅在小模型(≤1B)与低预算(<2B tokens)上验证 PPT,且将收益归因于语法先验;本研究首次在更大规模与更真实 PT 数据混合下系统评估,并证明收益更可能来自长程检索能力而非语法先验。
实验
实验设计
论文系统评估 synthetic pre-pretraining (PPT) 的有效性,覆盖五种 PPT 任务(K-Shuffle Dyck、MP-Struct Core、Set、NCA 等合成非自然语言数据)、四种 PT 数据混合、四个参数规模(500M 至 7B)、PT 预算最高 100B tokens。PT 数据混合包括 web text、code、math 等不同组合。评估分为通用能力与语言能力(BLiMP),对比基线是无 PPT 的标准预训练。
关键发现
- PPT 带来的下游性能与 token 效率提升在大规模下持续存在,例如 3B 规模可节省至少 21B PT tokens。
- 与先前归因不同,没有一致证据表明这些收益来自 grammatical prior:下游性能与语法可接受性在不同模型规模下不一致对齐。
- 下游收益主要来自能改进 long-range retrieval 的 PPT 任务,而非自然语言语法。
- PPT 性能增益对 PT 数据混合构成具有鲁棒性,仅当缺少 web text 时减弱。
与基线对比的深度解读
相对无 PPT 基线,PPT 在相同 PT token 预算下取得更好下游性能,或达到同等性能所需 PT tokens 更少,验证其作为低成本训练前附加步骤的实用价值。但机制与先前假设(grammatical prior)不符,提示未来 PPT 任务设计应聚焦 long-range retrieval。对混合数据的鲁棒性说明 PPT 不依赖特定数据分布,但 web text 的存在是关键,可能因为检索能力需要自然语言上下文。
行业影响
落地场景
Synthetic Pre-pretraining (PPT) 在 500M–7B 参数规模、最多 100B 预训练 token 下仍能稳定节省至少 21B 预训练 token(3B 规模),且无需改变下游任务微调流程。该技术可直接用于 电商搜索 / 推荐系统 的语义编码器、内容平台 的通用文本表征模型,以及 企业服务 中的文档检索与问答系统。例如,电商平台在训练商品描述嵌入模型时,先用合成数据做 PPT,可显著减少从零预训练所需的真实语料量,缩短迭代周期。
商业价值
核心价值在于 降低算力成本与数据采集成本。在 3B 模型上节省 21B token,相当于减少约 30% 的预训练数据需求,直接转化为 GPU 时费用下降。同时,PPT 任务本身计算开销极低(相比主预训练),因此净收益明显。此外,论文指出 PPT 收益主要来自 长距离检索能力 而非语法先验,这一发现帮助企业更精准地设计合成任务:不必投入资源构造复杂语法数据,只需生成强调长程依赖的序列,即可获得可迁移的提升。
与现有产品 / 工作流的接口
PPT 可作为预训练前的可选阶段,集成到现有 train-from-scratch 或 continue-pretraining 流程中。工程上只需:
- 准备合成数据生成器(如
k-Shuffle Dyck、MP-Struct等任务,代码已在 GitHub 开源); - 先在合成数据上训练少量 step(通常几百到几千 step);
- 再加载主预训练数据混合(如 web + code + math)继续训练。
无需修改模型架构或 tokenizer,对现有训练框架(如 Hugging Face Trainer、Megatron-LM)完全兼容。最终模型可无缝接入下游微调、蒸馏或 RAG 流程,企业可将其作为低风险、高性价比的预训练加速方案。
论文关键结论:PPT 的收益并非来自语法先验,而是长距离检索能力的提升 —— 因此未来合成任务设计应聚焦长程依赖,而非自然语言语法模拟。
局限
- - **规模上限仍有限**: 本研究最大验证到 **7B 参数** 与 **100B token** 预训练预算, 未涉及数十 B 至百 B 参数或万亿 token 的下一代模型规模。在该量级下, 预训练数据中海量自然语言信号可能完全覆盖合成预训练带来的初始化增益, 使 PPT 的**token 效率优势消失或反转**。因此, 结论是否适用于当前主流大模型(如 70B 及以上)仍存疑。
- - **归因缺乏因果验证**: 论文通过关联分析将下游收益归因于 **长距离检索能力** 的提升, 但未进行消融实验或因果干预(如仅训练检索子系统而不做完整 PPT)来证明该能力是收益的**必要且充分条件**。可能存在其他混淆因素(如优化轨迹变化、权重范数减小等)未被控制, 导致机制解释仍停留在相关性层面。
- - **任务与数据覆盖偏窄**: 所选五种 **合成 PPT 任务** 均偏向形式语言与结构化生成, 且 PT 混合中 **网络文本始终占主导**; 对于以代码、数学或多语言为主的预训练场景, PPT 的作用可能截然不同。此外, 未探索合成任务与真实代码/数学数据的交互效应, 限制了结论对非英语或非文本中心模型的推广性。