Magic-W0: 面向物理智能的结构化世界-动作基础模型
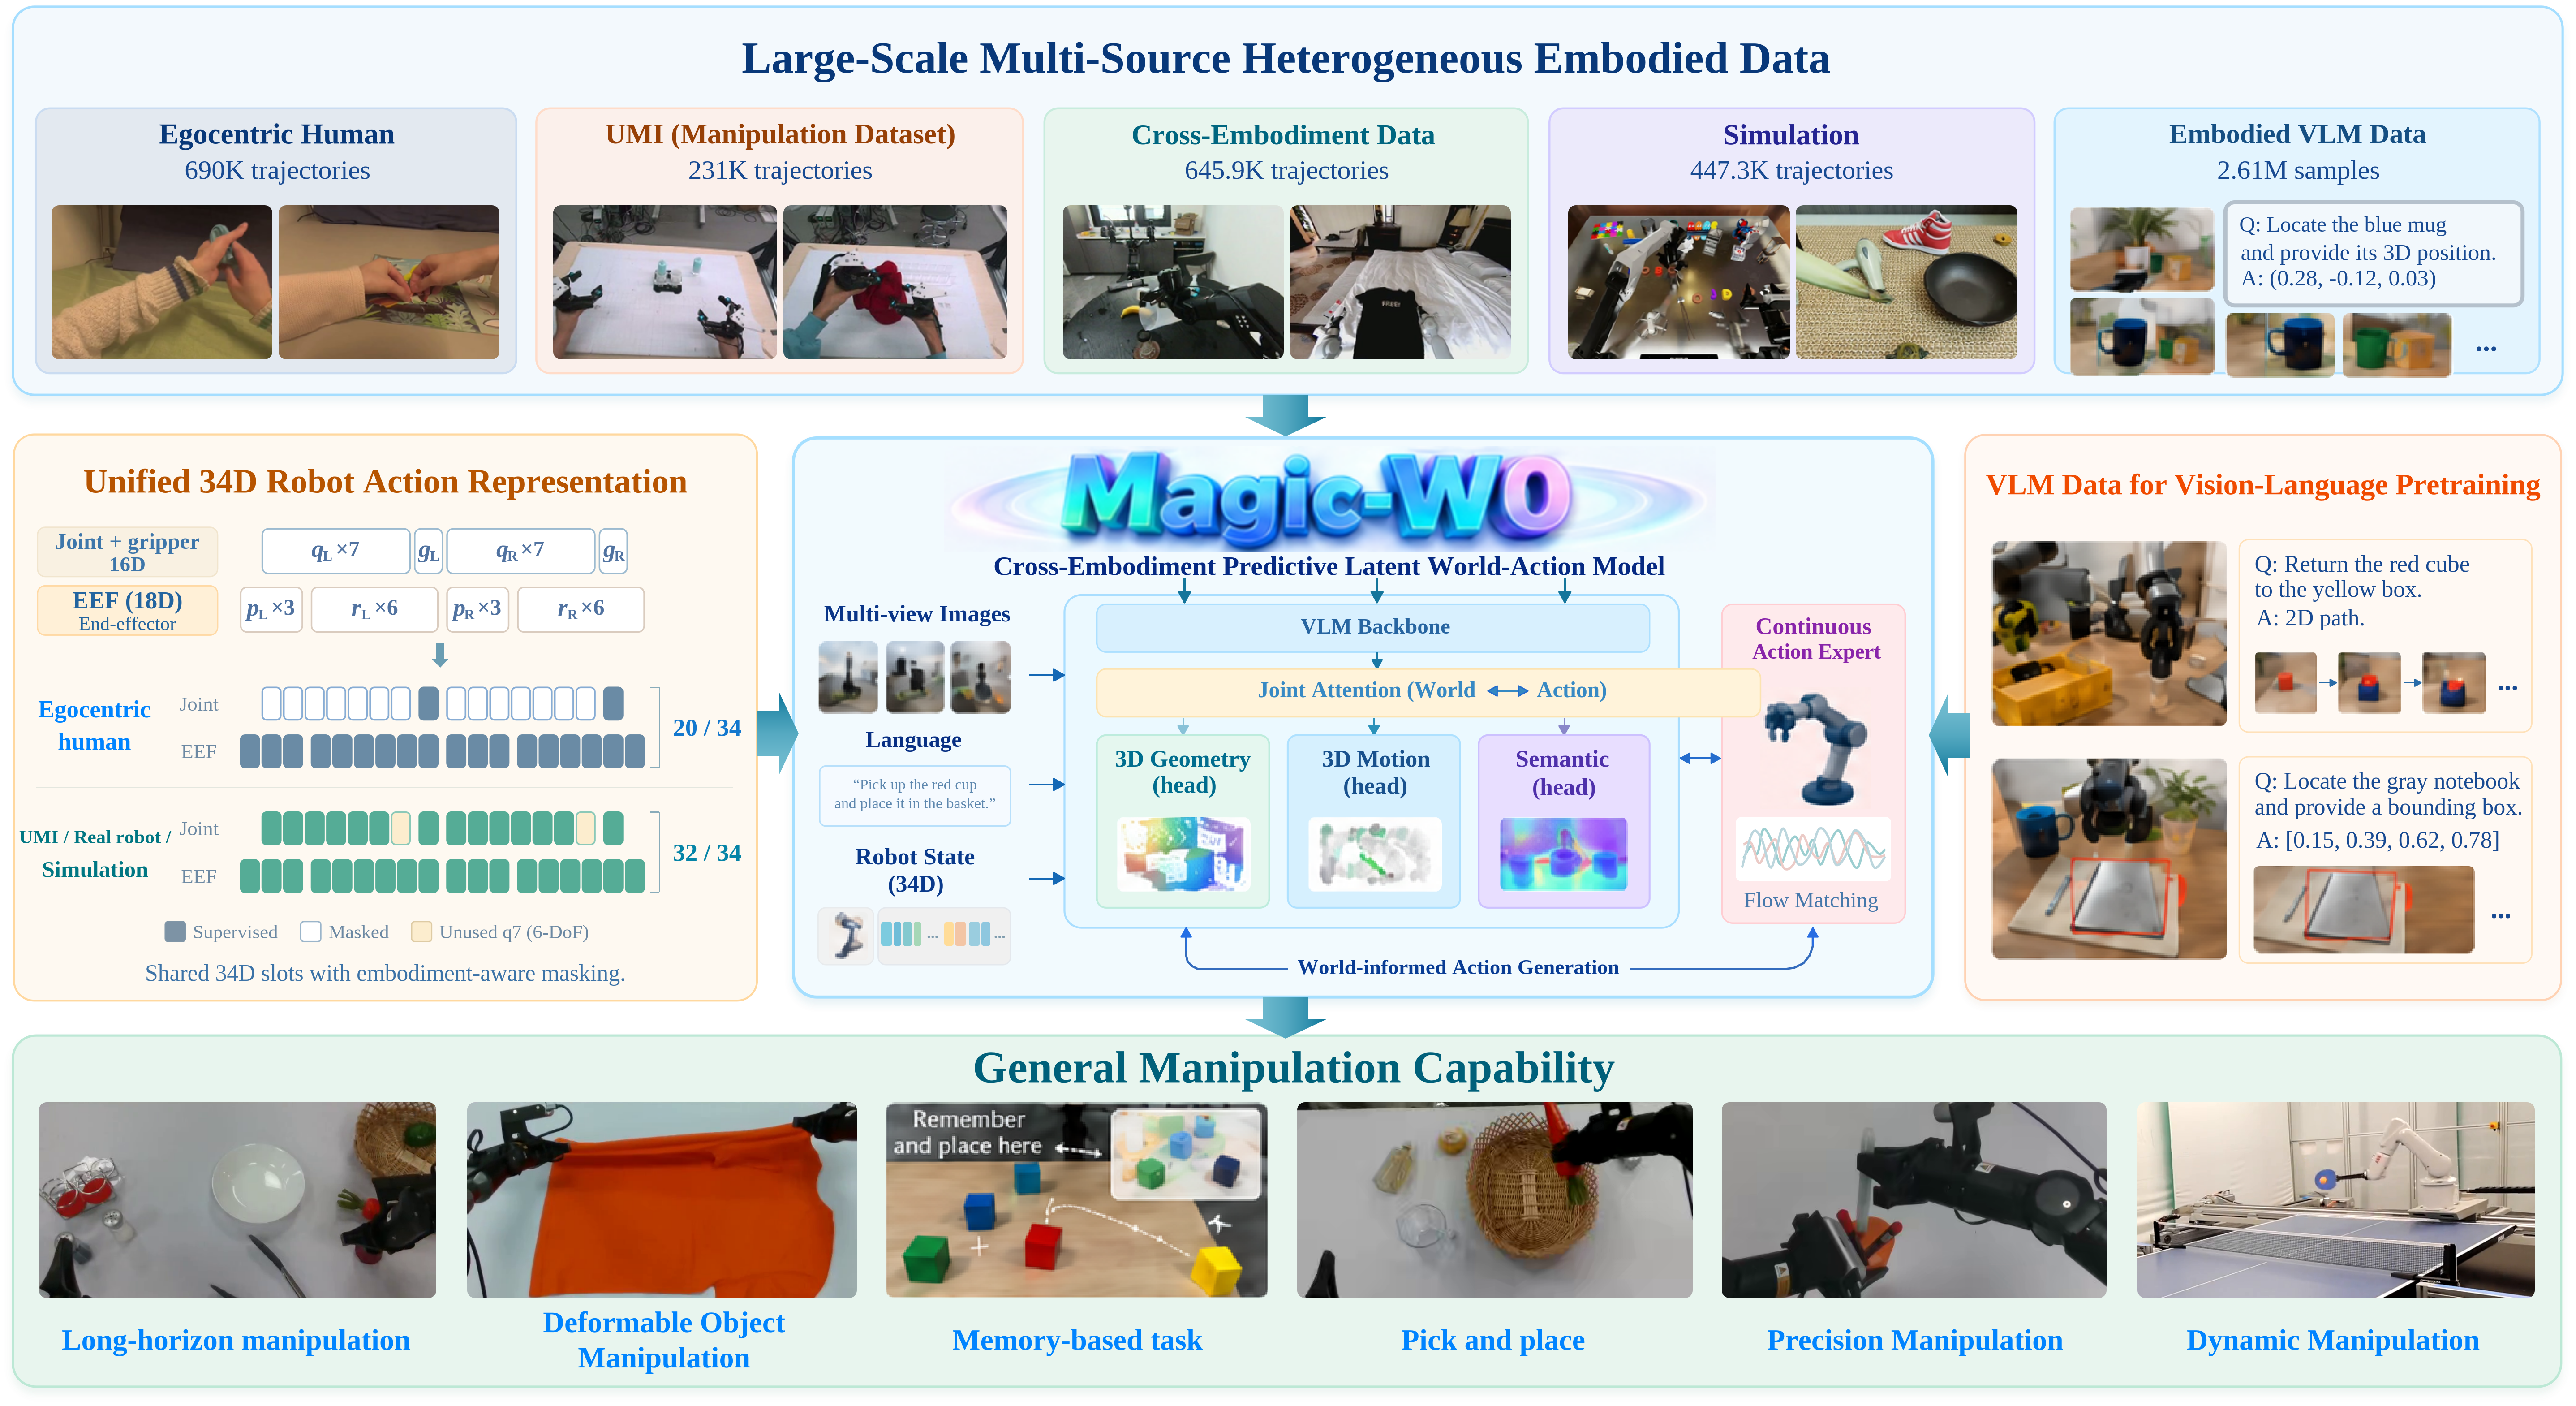
世界-动作模型 (WAMs) 通过动作条件化的环境动力学增强机器人策略,但现有方法大多依赖未来观测重建或通用潜空间预测,缺乏与动作生成紧密耦合的、结构化且面向控制的世界表征。 我们提出 Magic-W0,一个面向物理智能的世界-动作基础模型,联合建模结构化物理状态演化与连续动作。该模型将交互表示为三部分的 Structured World Transition: - Current State:结合视觉-语言上下文与当前 3D Geometry - Transition:以 3D Motion 表征动作引发的三维变化 - Future State:以 Future Semantics 描述任务相关结果 为实现预测与控制的耦合,我们设计了层级对齐的世界-动作交互架构:不断演化的动作假设为世界转移预测提供条件,而预测出的世界表征又持续指导动作生成。Magic-W0 在大规模自我中心人类操作、UMI、真机与仿真数据上预训练,并利用预训练视觉模型对几何、3D 运动与未来语义进行潜空间监督。推理阶段的干预实验表明,结构化世界表征会随候选动作的变化系统性地响应,且动作相关信息经由共享的 3D 表征传播至未来语义预测。在 RoboDojo-Sim 上,Magic-W0 取得 27.10 的平均 Score,在对比的 WAMs 中最高;在多个真机任务上,仅用有限下游数据微调后也展现出较强的下游性能,支持泛化与快速适应。
论文精读
TL;DR Magic-W0 提出结构化世界转换(当前状态—3D运动—未来语义)并层对齐联合建模世界预测与动作生成,在 RoboDojo-Sim 以 27.10 分领先,微调后快速适应真实机器人任务。
问题
问题背景
物理智能领域当前的核心关注在于让机器人策略不仅输出动作,还能理解动作引起的环境动态变化。world-action models (WAMs) 通过显式建模动作条件的环境转移,被视为提升泛化能力与物理推理的关键方向。
现有方法局限
现有 WAMs 主要依靠未来观测图像重建或通用潜在状态预测,但两者均缺乏结构化、面向控制的世界表示:
- 图像重建维度高、冗余大,且像素级目标不直接服务于控制任务,容易引入噪声;
- 通用潜在预测缺乏可解释性,无法显式描述3D 几何、运动语义与任务相关结果,导致世界模型难以有效约束动作生成。 此外,世界预测与动作生成通常解耦训练,动作信息无法持续反馈到状态转移预测中,在需要精细物理交互的任务(如接触、变形、遮挡)中泛化能力明显不足。
为什么这个问题难/重要
要在连续动作空间中联合建模结构化状态转移,需要统一表示对齐视觉、语言、3D 几何与动作序列。同时,预训练语料来自人类操作、UMI、真实机器人与仿真等多源数据,存在坐标系差异与标签缺失,构建跨源监督信号本身极具工程复杂度。业界对通用机器人基础模型的需求迫切,能否让世界模型真正进入控制闭环,直接决定模型在下游任务中的数据效率与快速适配能力。
行业类比
类似自动驾驶从纯端到端黑盒模型演进到引入显式BEV 占用栅格表示以提升可解释性与规划可靠性,机器人世界模型也需要结构化中间表示来桥接感知与控制。
核心洞察
- 结构化世界转移将环境演化分解为 Current State(视觉语言 + 当前 3D 几何)、Transition(3D 运动)和 Future State(未来语义),使世界模型从“预测像素 / 通用隐状态”转向可解释、可操控的物理状态空间。与重建未来观察的 WAM 不同,Magic-W0 显式分离几何与语义,让动作引起的 3D 变化成为独立监督目标,避免低层像素冗余,直接服务于控制。
- 层对齐的世界-动作双向交互架构让“动作假设”和“世界转移预测”逐层互相条件,而非单向注入动作后预测下一帧。这样世界预测可以持续修正候选动作,动作生成也能利用预测的未来语义与 3D 变化,形成闭环。干预实验显示改变候选动作会系统性改变结构世界表示,且动作信息通过共享 3D 表示传播到未来语义,证实跨流依赖在实际中成立。
- 利用预训练视觉模型的潜在监督(geometry、3D motion、future semantics)在混合人类操作、UMI、真实机器人与仿真数据上预训练,使模型无需稠密真值即可学到通用物理动态。这降低了对机器人演示数量的依赖,配合少样本下游微调即可适应真实任务,说明 WAM 的规模化路径不一定依赖自回归像素生成,可以用特定结构先验提升数据效率。
方法
Magic-W0 将机器人交互建模为 Structured World Transition:Current State(视觉-语言上下文 + 当前 3D 几何)→ Transition(3D 运动,即动作引起的三维变化)→ Future State(未来语义,任务相关结果)。输入为多模态观测,输出为连续动作序列与未来语义预测。
关键模块
layer-aligned world-action interaction architecture 实现预测与控制的层对齐双向交互:
- 动作假设按层逐步条件化世界转移预测;
- 预测的世界表示(几何、运动、语义)反向持续影响动作生成;
- 共享的 3D 表示使动作信息能传播到未来语义预测。
训练与推理
预训练使用大规模自监督数据源(egocentric human manipulation、UMI、real-robot、simulation),利用预训练视觉模型提取几何、3D 运动、未来语义的潜在监督信号;损失函数联合优化动作预测与世界表示。推理时支持干预分析:改变候选动作会导致结构化世界表示系统响应,证实因果耦合。
与同类 WAMs 相比,现有方法依赖未来观测重建或通用潜在状态预测,Magic-W0 采用显式、控制导向的 3D 几何/运动/语义表示,并通过层对齐双向架构将预测与控制紧密耦合,而非单向或松耦合。
实验
实验设计上,论文在 RoboDojo-Sim 和 LIBERO 两个仿真基准上评估性能,并在多个真实机器人任务上用有限下游数据做监督微调验证快速适应能力。此外,通过推理时干预分析动作敏感性和跨流依赖性:改变候选动作,观察结构化世界表示是否系统响应,以及动作信息如何通过共享 3D 表示传播到未来语义预测。
关键发现:Magic-W0 在 RoboDojo-Sim 上取得平均 Score 27.10,为所有对比 WAM 中最高;真实机器人任务在少量数据微调后表现强,说明模型具备良好的泛化和快速适配能力。干预实验表明,结构化世界表示(当前状态-转移-未来状态)对动作假设的变化有可靠响应,动作相关信息会流入未来语义预测,证明世界建模与动作生成并非解耦。
与基线对比:现有 WAM 主要依赖未来观测重建或通用隐状态预测,缺乏面向控制的显式物理状态结构。Magic-W0 通过层对齐联合注意力实现动作假设与世界转移预测的双向交互,且以预训练视觉模型的潜在监督(几何、3D 运动、未来语义)提供结构化目标,这种控制导向的表示耦合是性能领先的关键。
行业影响
落地场景
Magic-W0 作为结构化世界-动作基础模型,核心价值在于为机器人操作提供物理状态演化预测与控制动作生成的联合建模。典型落地场景包括:
- 仓储与电商分拣:在货品抓取、装箱等任务中,利用预训练世界表示快速适配新 SKU 和布局变化。
- 工业装配与柔性制造:对操作过程中的 3D 几何变化与未来语义进行显式建模,提升动作的物理合理性。
- 自动驾驶与移动机器人:将自车操控与交通参与者未来状态预测耦合,增强规划对动态环境的响应能力。
商业价值
- 降本:通过在大规模人类操作、UMI、真实机器人及仿真数据上预训练,Magic-W0 支持少量下游微调即可适应新任务,显著减少真实机器人数据采集与标注成本。
- 增效:在 RoboDojo-Sim 上取得 27.10 平均分,为对比 WAM 中最高;真实机器人任务微调后表现良好,可缩短从仿真到部署的迭代周期。
- 体验与安全提升:结构化世界表示(Current State / Transition / Future State)提供可解释性,便于在安全敏感场景中进行风险预判和动作筛选。
与现有产品/工作流接口
Magic-W0 可作为一个预训练世界-动作骨干嵌入现有机器人学习栈:
- 在 ROS / ROS 2 环境中封装为推理节点,接收视觉与本体感知输入,输出连续动作及中间世界表示。
- 与仿真器(RoboDojo、LIBERO)对接,用于策略预训练和 sim-to-real 迁移;通过 latent supervision 对齐预训练视觉模型的 3D 几何与未来语义,无需额外标注。
- 与现有 VLA 策略模型(如 RT 系列、Octo 等)协同,利用其世界表示作为辅助监督或规划先验,增强长时任务稳定性。
具体落地 use case:
- 电商仓储分拣:部署于物流机器人的视觉抓取系统,使用 Magic-W0 进行预训练,再以少量真实拣选数据微调,可快速适应新商品品类和货架结构,降低上线成本。
- 辅助驾驶预测-控制耦合:在自动驾驶模块中,用 Magic-W0 同时预测未来占用栅格和自车控制指令,减少预测与控制不一致导致的犹豫或激进变道,提升决策平顺性。
局限
- **依赖外部视觉模型** 作为 latent supervision 来源,3D geometry、3D motion、future semantics 均提取自预训练视觉模型。这些表示并非针对控制优化,可能继承上游模型在机器人视角、动态遮挡、低纹理场景下的偏差;一旦上游模型失效,世界转移预测质量会直接受损。此外,大规模混合预训练数据涉及 egocentric human manipulation、UMI、真实机器人与仿真,跨来源的坐标变换、有效性过滤及信号修复流程复杂,标定误差或噪声可能残留并影响训练稳定性。
- **实验对比范围有限**:仿真主要报告 RoboDojo-Sim 平均 Score 27.10(最高),但 LIBERO 未给出具体对比分数;真实机器人仅少数任务且依赖下游微调。缺乏与代表性 VLA 策略(如 OpenVLA、RT-2)或纯 action expert 的横向对比,难以区分增益来自结构化 world modeling 还是模型容量与数据规模。RoboDojo Score 的绝对实用性也不明确,无法判断是否达到可部署水平。
- **计算与部署开销未充分评估**:引入 3D geometry、3D motion、future semantics 多路表征监督,配合 layer-aligned joint attention 双向交互,会显著增加训练和推理的计算量与显存。尽管通过 gradient isolation 和辅助目标缓解部分压力,但论文未报告真实机器人推理延迟、显存占用或边缘设备可行性,可能限制其在资源受限平台上的实时部署。