EpiCon: 通过协同演化多模态记忆实现智能体集体学习
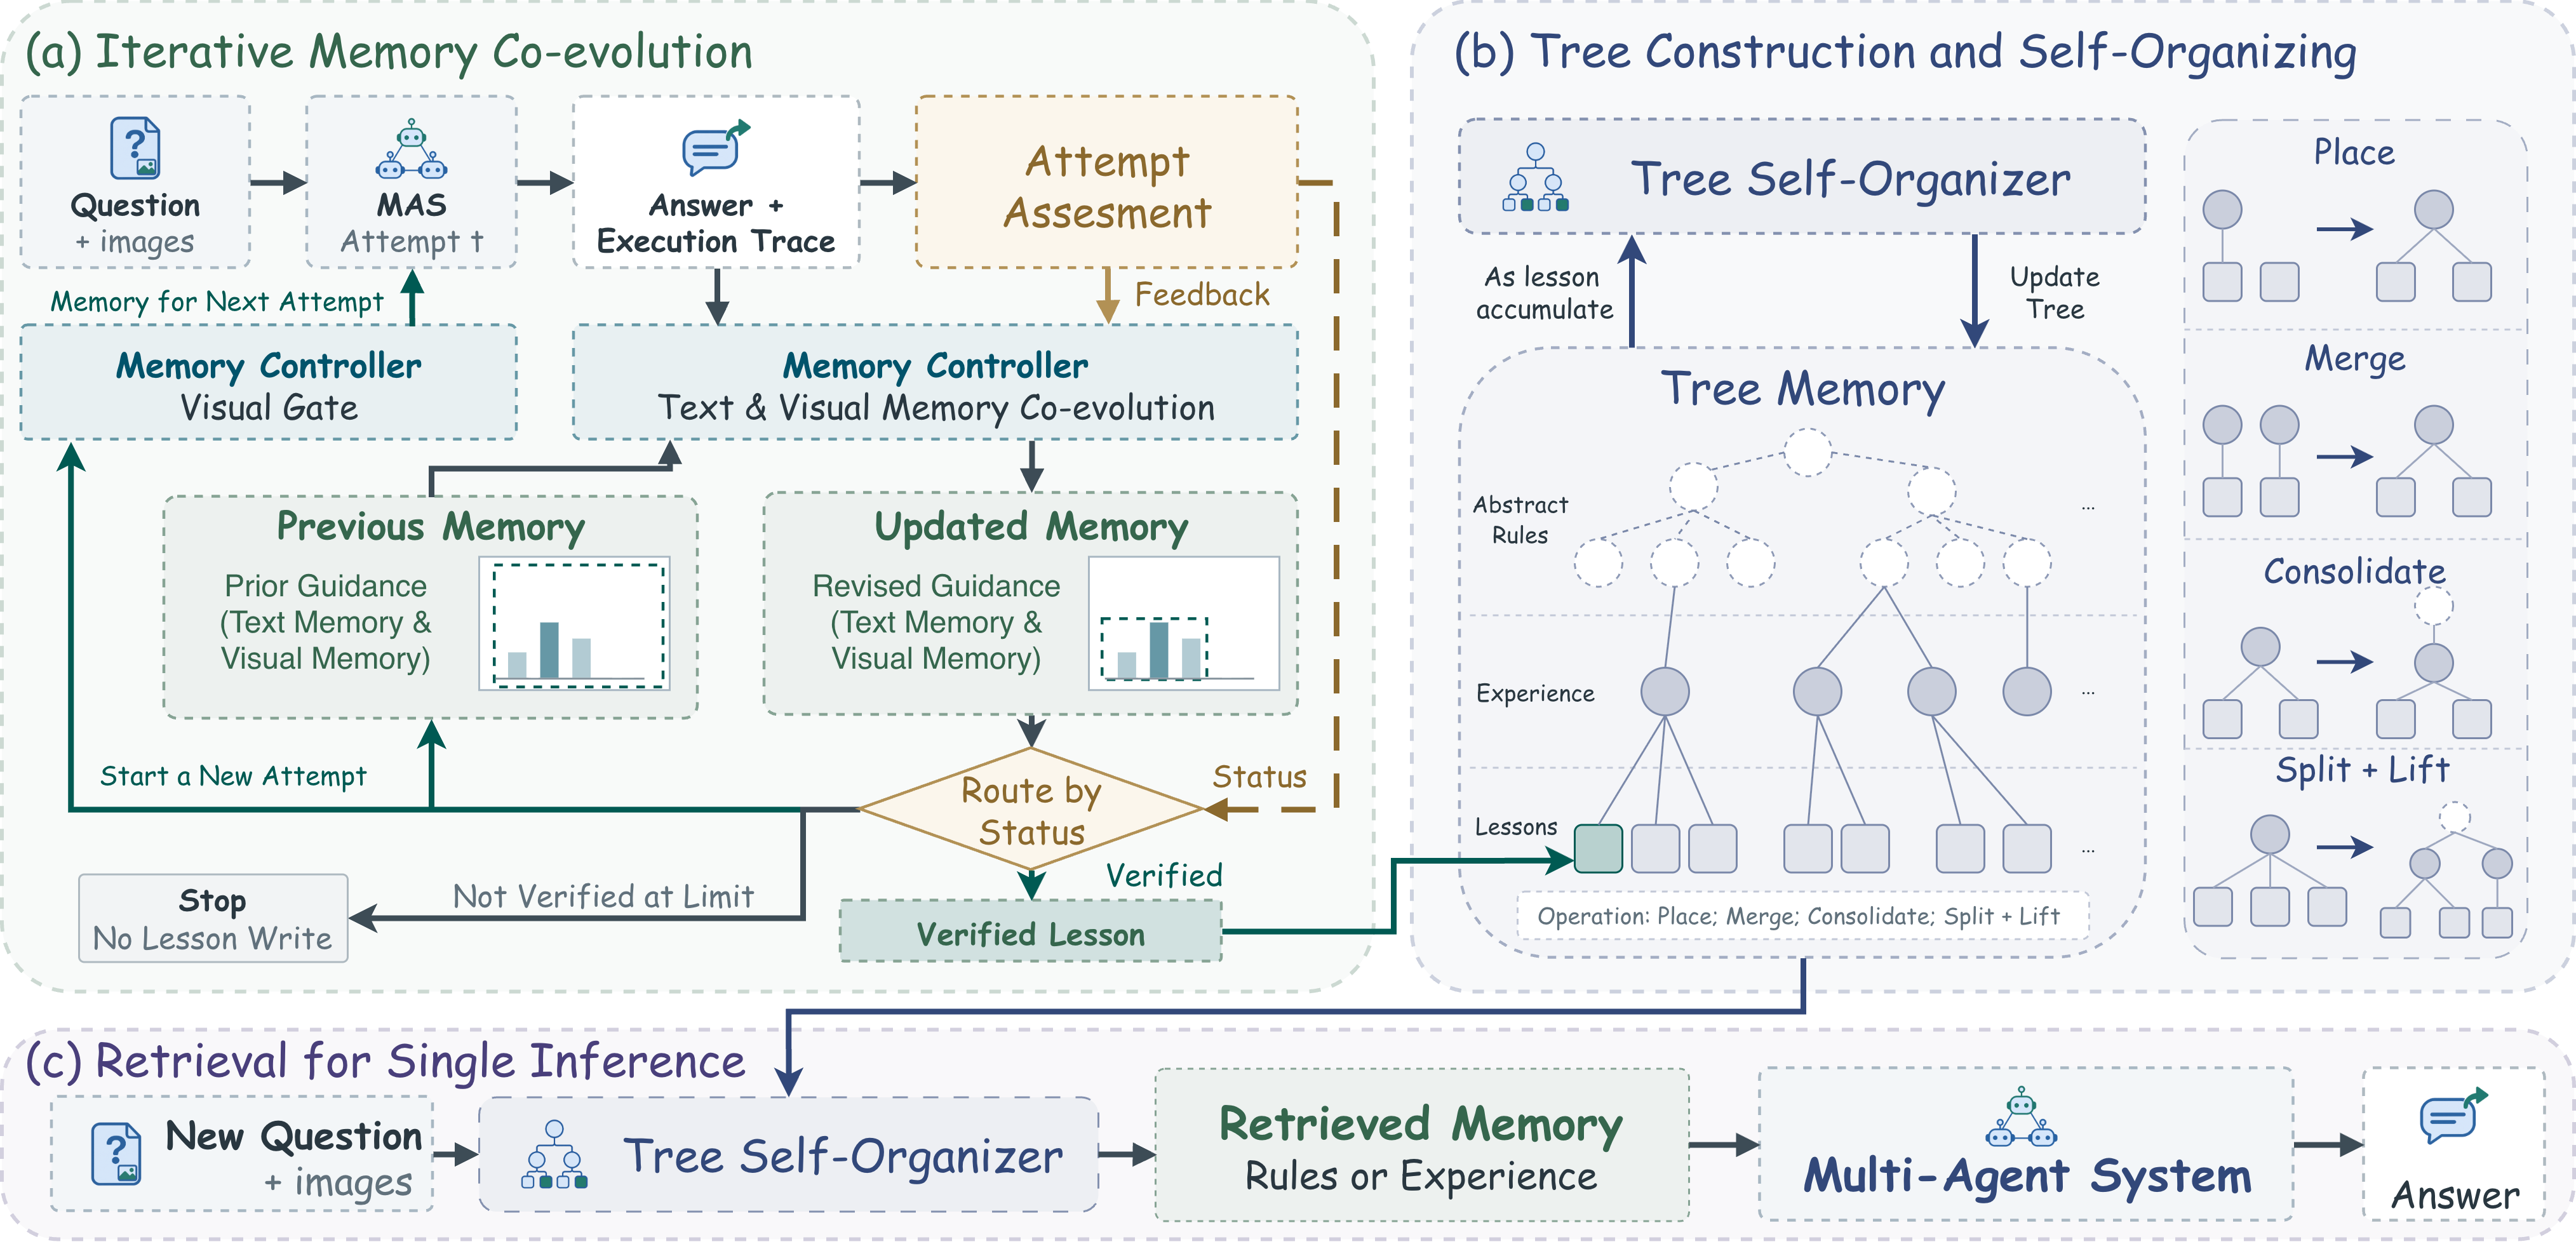
智能体能够从过往执行中学习,但让不同智能体复用并基于彼此的经验继续构建,仍然颇具挑战。 EpiCon 是一个面向智能体集体学习的共享多模态记忆框架,且无需更新宿主模型参数。它通过两个独立训练的 2B 模型,把问题级记忆演化连接到持久经验库:其中 记忆控制器(memory controller)在多次尝试中联合精修文本引导与视觉证据,并有选择地纳入视觉记忆;而 树式自组织器(tree self-organizer)则分层整合经验教训,为新问题检索经验与规则。 在覆盖四个多模态任务领域的 11 个 benchmark 上,作者使用两种 harness 与多个 backbone 进行评估:一个冻结的经验库即便只做单次求解尝试,也能提升其他系统;第二种 harness 将原系统在 11 个 benchmark 上的 macro-average 提升 2.6 分。在四种宿主配置下,EpiCon 相比 No Memory 将 macro-average 分数提升 1.7 至 4.9 分,并将记忆操作时间相对 backbone 规模的记忆模型减少 67% 至 74%。
论文精读
TL;DR EpiCon 通过两个独立训练的 2B 模型构建共享多模态记忆库,让不同 agent 无需更新参数即可复用和积累经验,在 11 个基准上平均提升 1.7-4.9 分,并将记忆操作耗时降低 67%-74%。
问题
问题背景
多模态智能体(multimodal agent)在执行视觉推理、GUI 操作、机器人交互等任务时,会积累大量执行经验。如何让不同智能体之间共享、复用并持续积累这些经验,成为提升整体效率的关键。
现有方法局限
现有 agent memory 方案大多局限于单智能体内部,通过参数微调或固定外部存储来记录经验,存在三类具体瓶颈:
- 跨智能体经验隔离:不同 agent 的记忆库彼此独立,无法直接复用他者经验,导致重复试错;即便使用统一记忆库,也多为扁平键值检索,缺乏对经验间层级关系(如通用规则 vs. 具体案例)的建模。
- 多模态记忆利用不足:多数方法仅存储文本轨迹或最终结果,视觉证据(如截图中的关键区域、操作前后的状态对比)往往被丢弃或只作为静态图片存档,无法在后续尝试中动态修正和筛选。
- 记忆更新代价高:参数更新式记忆会带来灾难性遗忘和昂贵的重训练;而固定规则库又难以适应新任务分布,缺乏从实例中抽象通用经验的能力。
为什么这个问题难 / 重要
多模态经验包含文本指导与视觉证据两个强耦合模态,二者需要在多次尝试中联合演化:何时保留某张截图?哪段文字描述应被压缩为规则?视觉噪声如何过滤?这些问题缺乏监督信号。同时,经验库需要持续增长,但检索延迟不能随库规模线性上升,且经验需在不同 host model(如不同 VLM 骨干)间通用。业界对免训练、可插拔的集体记忆模块关注度很高,因为它能直接降低多智能体系统的边际成本。
行业类比
类似场景:多个服务型机器人在不同家庭中执行日常任务,若每个机器人各自从头学习物品摆放与操作技巧,效率极低;共享一个“团队经验云”后,新机器人首次执行即可参考他人成功案例与失败教训,这正是 EpiCon 所构建的集体记忆形态。
核心洞察
- 外部小型记忆模块替代参数更新,实现 agent 集体学习且保持宿主模型冻结,大幅降低部署成本。EpiCon 用两个 2B 模型(memory controller 和 tree self-organizer)管理记忆,无需微调任何宿主骨干,在四个配置上宏平均提升 1.7-4.9 分,同时记忆操作时间减少 67%-74%。相比使用与骨干同尺寸的记忆模型或依赖模型自我反思,这种解耦设计允许快速插入现有系统,冻结的记忆库还能直接提升其他系统的性能,为多 agent 系统的经验复用提供了低成本的工程路径。
- 文本与视觉记忆的联合进化是 EpiCon 独特之处。传统 agent 记忆多集中在文本经验,EpiCon 同时精炼文本指导和视觉证据,并通过 question-level 演化与共享经验库的双层结构实现跨问题泛化。控制器选择性纳入视觉记忆,自组织器层次化整合 rules 与 experience,使单一尝试即可让冻结库改善新系统。这种多模态集体记忆不仅提升性能,还促进了不同 agent 之间的知识迁移,区别于单 agent 自我反思方法,展示了通用记忆插件的潜力。
方法
输入
新问题对应的多模态观察(文本指令、图像证据)以及从 共享经验库 中检索到的历史经验与规则。
关键模块
1. 问题级记忆演化(Memory Controller):一个独立训练的 2B 模型,负责在当前问题的多次求解尝试中,联合细化 文本指导 与 视觉证据,并选择性纳入视觉记忆。它不修改宿主模型参数,而是输出更高质量的上下文。
2. 共享经验巩固与重用(Tree Self-Organizer):另一个独立训练的 2B 模型,将问题级演化中产生的 lessons 按层级结构整合进持久 经验库,并为新问题检索可复用的经验与规则。树形组织让经验检索与压缩更高效。
输出
最终提供给宿主 agent 的是增强后的上下文:细化后的文本指导、筛选后的视觉记忆、检索到的历史经验与规则。宿主模型无需微调,冻结经验库即可被其他系统直接使用,单次尝试也能受益。
与同类方法的差异
相比使用 backbone 规模记忆模型或直接更新宿主参数,EpiCon 用两个小型 2B 策略模型完成记忆演化和层级组织,在四个宿主配置下平均提升 1.7–4.9 个百分点,同时将记忆操作时间降低 67%–74%。
实验
实验设计
- 在 11 个多模态 benchmark 上评估,覆盖 4 个任务领域,使用 2 个 agent harness 和多种 backbone。
- 对比 No Memory 基线、backbone-sized memory models 以及跨 harness 迁移设置。
- 核心机制:不更新宿主模型参数,通过两个独立训练的 2B 模型(memory controller + tree self-organizer)实现共享记忆。
关键发现
- 在 四个宿主配置 中,EpiCon 的 macro-average score 相比 No Memory 提升 +1.7~+4.9 points。
- 第二个 harness 使原系统的 macro-average score 提升 +2.6 points(11 benchmarks 平均)。
- memory-operation time 相比 backbone-sized memory models 减少 67%~74%。
- 冻结的记忆库即使只给一次求解尝试,也能改善其他系统,说明经验可迁移。
与基线对比
- 相比 No Memory,EpiCon 在所有宿主配置上均有稳定收益,表明共享多模态经验有效。
- 相比直接使用 backbone 大小的 memory 模型,EpiCon 用时显著下降,且不牺牲性能,说明轻量记忆策略在成本与效用间取得平衡。
- 冻结 bank 跨系统提升验证了 collective learning 的泛化性,为实际部署提供了低开销的增量学习路径。
行业影响
落地场景
EpiCon 适合需要积累多模态交互经验的 Agent 系统。典型场景:
- 电商售后客服:用户上传商品图片 + 文字描述缺陷,不同客服 Agent 共享历史案例和视觉证据,快速定位问题类型并给出处理方案。
- 内容平台审核:视频/图文审核 Agent 共享违规模式库,新内容到达时通过检索类似案例快速判定,减少误杀和漏放。
- 医疗影像辅助:不同医院或科室的辅助诊断 Agent 共享罕见病例的影像特征与报告模板,帮助低年资医生或基层场景提升诊断一致性。
商业价值
- 降本:EpiCon 的 memory 模型只有 2B 参数,相比使用 backbone 大小的 memory 模型,内存操作延迟降低 67%–74%,直接减少 GPU 推理成本和响应时间。
- 增收/体验提升:通过共享记忆,新 Agent 或新任务可在 单次尝试 下就受益于其他 Agent 的历史经验,减少冷启动成本。论文显示在不同 host 配置下 macro-average 提升 1.7–4.9 分,意味着更高准确率和更稳定的服务质量,降低客户流失。
- 快速复制能力:冻结的 experience bank 可以直接用于其他 Agent 系统,实现经验跨系统迁移,无需重新训练主模型。
与现有产品/工作流的接口
EpiCon 可以作为 插件式 memory 层 集成进现有 Agent 栈,无需修改 host model 权重。
- 对接 LangChain / AutoGen / LlamaIndex 等框架:将 EpiCon 封装为 memory backend,通过 API 提供
store/retrieve/consolidate接口。 - 独立部署:两个 2B 模型可以独立部署在 CPU 或低端 GPU 上,与主 Agent 解耦,适合微服务架构。
- 异步更新:experience bank 可在后台持续巩固和演化,前台 Agent 只做检索和写入,不影响实时响应。
关键差异:与单 Agent 的 reflection 或经验回放不同,EpiCon 实现了跨 Agent 的集体学习,且通过树结构自组织器压缩和检索经验,避免记忆无限膨胀。
局限
- **训练数据与部署成本**:EpiCon 依赖两个独立训练的 2B 策略模型(**记忆控制器** 与 **树自组织器**),其数据 curation 需要构建 replay-verified joint memory transformations 以及树组织与检索的演示数据,成本较高。虽然记忆操作时间比 **backbone 大小的记忆模型** 低 67% 至 74%,但相比无记忆系统仍引入额外推理延迟;两个 2B 模型的常驻内存与算力需求对资源受限场景有一定门槛。论文未给出训练数据规模、标注人力的详细量化,这影响复现与工程落地的成本评估。
- **任务覆盖与泛化边界**:评估覆盖十一个 benchmark、四个多模态任务域,但集中在视觉问答、视觉推理、GUI 操作等模态对齐型任务,缺少开放式对话、代码生成、具身交互等更广泛的 agent 场景验证。视觉记忆选择策略是否对特定图像类型过拟合,尚未通过跨域零样本实验证实。论文使用两个 harness 和多个 backbone,但未报告在更强 solver(如 **GPT-4V** / **Claude 3.5**)上的收益是否衰减,因此无法判断该方法在 SOTA 模型上的边际价值。
- **与参数更新路线的性能差距**:EpiCon 冻结宿主模型参数,仅通过外部记忆交互提升表现,虽避免灾难性遗忘,但难以让宿主模型真正内化经验,性能上限可能低于端到端微调或多任务联合训练的记忆增强方案。**记忆控制器** 与 **树自组织器** 独立训练,未与宿主 solver 联合优化,检索结果可能非全局最优。论文未直接对比 **Reflexion** / **Voyager** 等 memory-based 方法的改进幅度,也未与参数更新类方法进行控制实验,因此“不更新参数”的相对收益仍缺乏严格基准。