WISE-ATTA: 预算受限的主动测试时适应中何时请求标签
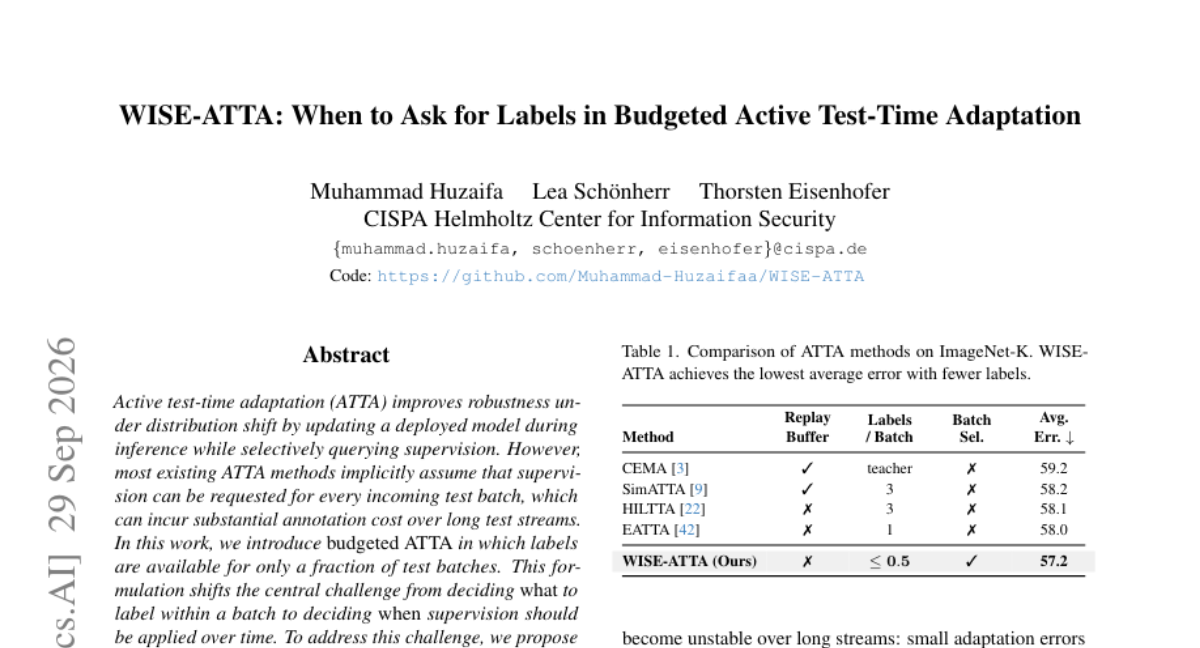
主动测试时适应(ATTA) 通过在推理过程中更新已部署模型,并有选择地查询监督信号,从而提升分布偏移下的鲁棒性。然而,现有 ATTA 方法大多隐含假设可以对每个到来的测试批次请求监督,这在长测试流上会带来巨大的标注成本。 本文引入 预算受限的 ATTA(budgeted ATTA) 设定:只有一小部分测试批次可获得标签。这一形式化将核心挑战从「批次内该标注什么」转变为「何时应当施加监督」。为此,我们提出预算感知方法 WISE-ATTA,它基于在线计算的轻量信号在测试流上分配监督,优先选择监督可能最有用的时段。当某批次被选中施加监督时,我们进一步采用基于漂移的样本选择准则,聚焦于呈现持续、未收敛适应动态的样本,从而用单个有标签样本实现有效更新。 我们在合成损坏 (ImageNet-C) 与自然分布偏移 (ImageNet-R/K/A) 上评估该方法。在各设定下,WISE-ATTA 相比近期 ATTA 方法取得相当或更优的性能,同时所需标签数大幅减少。总体而言,我们发现监督的时机 是主动测试时适应中一个关键却尚未被充分探索的方面。代码:https://github.com/Muhammad-Huzaifaa/WISE-ATTA
论文精读
TL;DR WISE-ATTA 将测试时适应置于预算约束下,核心从“每批标什么”转向“何时标注”,通过在线轻量信号分配监督时机,并结合漂移样本选择,在 ImageNet-C/R/K/A 上以更少标签实现竞争性能。
问题
问题背景
测试时适应(Test-Time Adaptation, TTA)在推理时更新模型以缓解分布漂移。为提升稳定性,主动测试时适应(ATTA) 引入少量监督信号,目前开始受到关注。
现有方法局限
现有 ATTA 方法通常假设每个 incoming test batch 都可请求 ground-truth 标签,仅关注在批次内“标注哪个样本”。这带来两个直接问题:
- 长测试流上标注成本线性累积,部署不可行。
- 忽略时间维度的选择:某些批次可能处于低漂移或模型已稳定的阶段,此时监督收益极低,不应该消耗预算。
因此,无预算约束的 ATTA 无法回答“何时值得标注”这一资源分配问题,只能依赖事后批量查询,难以满足实际系统对成本上限的要求。
为什么这个问题难/重要
把标签预算从“per-batch”放宽到“全流共享”后,核心挑战变为在线估计每个 batch 的监督边际效用:
- 需要轻量、可流式计算的 batch 级信号,以判断当前是否处于监督高价值窗口。
- 预算有限且不可预知未来漂移,必须在利用当前标注机会和保留预算给未来更难的 batch 之间做 trade-off。
- 当决定标注时,还需从 batch 中选出能最大限度修正模型偏差的样本。
该设定更贴近真实部署:模型需长期运行且标注成本敏感,业界对“低成本持续适应”的需求日益增长,但现有 ATTA 研究尚未系统解决时机问题。本文的 WISE-ATTA 为此提供了首个 budgeted 框架,并用 drift-based 样本选择在单标注样本下实现有效更新。
行业类比
类似强化学习中的动作探索预算分配:智能体需要决定在哪个时间步请求环境反馈,而非每步都获得 reward,这种“何时询问”的决策对成本敏感型在线学习同样关键。
核心洞察
- 预算约束下的监督时机比样本级选择更重要。WISE-ATTA 将主动测试时自适应从“批次内选哪些样本标注”重构为“时间流上选哪些批次申请监督”,通过轻量在线信号分配有限标签预算,优先标注对适应最有益的时期。相较于现有 ATTA 方法假定每个批次均可请求标签、导致长期标注成本不可控,该范式在保持甚至提升鲁棒性的同时大幅降低标注量,为实际部署提供了可扩展的标注策略。
- 基于样本“未收敛动态”的漂移选择标准是高效利用单个标注的关键。WISE-ATTA 在选中的批次内,不是选择不确定性最高或随机的样本,而是选择那些预测持续变化、适应尚未稳定的样本,这类样本携带更多可学习信号,使单个标注即可驱动有效更新。这区别于传统主动学习偏好高不确定性样本的做法,更适合持续漂移场景,因为高不确定性样本可能只是噪声或离群点,而未收敛样本则指示模型正在经历分布变化。
方法
WISE-ATTA 面向预算化主动测试时适应(budgeted ATTA)场景:测试流按批次到达,但标签预算仅覆盖部分批次。
输入 → 关键模块 → 输出
- 输入:预训练模型、连续测试批次、总的标签预算比例(如 10% 批次可标注)。
- 批次选择模块:在线维护轻量信号(如预测熵、模型不确定性、近期损失趋势等),为每个批次计算效用分数。使用滑动窗口内的分数比较和阈值(
slack δ、窗口长度W)决定当前批次是否请求监督。时机选择旨在优先标注分布漂移剧烈或适应收益高的时期。 - 样本选择模块:当批次被选中时,不标注整批,而是用漂移驱动准则挑选单个样本。该准则关注模型对该样本预测的未收敛程度(例如连续更新中损失下降慢、梯度范数异常),识别仍在适应动态中的样本。
- 监督更新:仅用被选中的单样本标签对模型做一步有监督梯度更新(可限定更新部分层,如分类头或归一化层)。
- 输出:持续适应后的模型,在测试流上逐批推理并偶发更新,总标注量严格受预算约束。
与同类方法的差异
相比现有 ATTA 方法默认每个批次都能获取监督,WISE-ATTA 显式引入预算约束,将核心决策从“批内选什么样本”变为“何时选批次”,并用漂移信号指导单样本选择,从而在极低标签开销下保持高稳健性。
实验
实验设计
评估在 ImageNet-C(合成损坏)、ImageNet-R、ImageNet-K (Sketch) 和 ImageNet-A(自然分布偏移)上进行。采用预算约束的 Active Test-Time Adaptation 设置:仅对部分测试批次提供标签。与多种近期 ATTA 方法对比,并开展消融:批次选择策略、漂移样本选择、不同标签比例、标签利用率时序、所选样本分析。
关键发现
- WISE-ATTA 通过在线轻量信号判断何时请求监督,优先选择对适应最有利的时间段,从而在大幅减少标签量的同时保持竞争力或提升精度。
- 当批次被选中时,漂移样本选择 聚焦于尚未收敛的适应动态,仅需单个标注样本即可完成有效更新。
- 实验表明,监督的时间分配比批内样本选择更为关键,这是现有 ATTA 方法忽略的维度。
与基线对比
传统 ATTA 方法默认每个测试批次均可获取标签,导致长测试流下标注成本不可持续。WISE-ATTA 将挑战从“批内标注什么”转变为“何时标注”,更贴合真实部署的预算限制。与近期 ATTA 方法相比,在相同标签预算下,WISE-ATTA 的精度与效率更优;即使标签预算极低,也能通过策略性分配维持稳定适应。
行业影响
落地场景
WISE-ATTA 适合持续在线推理且分布动态变化的服务,典型如:
- 内容审核:社交平台违规检测模型,新违规模式不断出现,需要适应,但标注预算有限。
- 电商推荐:用户行为与商品上新导致分布偏移,需选择性请求反馈标注。
- 自动驾驶感知:车端模型遭遇天气、光照变化,需边缘适应,标注成本高,预算式主动适应契合。
商业价值
核心是降低标注成本并保持鲁棒性。WISE-ATTA 在 ImageNet-C/R/K/A 上以更少标签达到竞争性能,直接转化为运营节省。对日处理百万级请求的平台,标注请求比例下降即可节省大量人工审核费用;同时模型稳定减少业务损失,提升用户体验。
与现有工作流接口
WISE-ATTA 作为在线标注调度层,位于模型推理后、标注管道前。它根据轻量在线信号(预测熵、漂移度量)输出是否请求标签及具体样本,与现有主动学习框架兼容。超参数(warmup、历史窗口、slack δ) 需按业务数据流调优,论文提供敏感性分析。对于已使用 TTA 的系统,可直接嵌入更新循环;未使用 TTA 的系统,可逐步引入预算感知适应。
具体 use case:一家全球电商平台在促销季部署商品分类模型,每日人工标注预算 500 条,WISE-ATTA 自动识别模型最不确定时段优先请求标注,而非均匀分配。内容平台安全模型遇到新型欺诈模板时,检测到输出分布变化立即请求少量标注快速适应,及时阻断风险。
局限
- 论文提出的批次选择策略依赖轻量启发式信号(如预测熵、模型置信度等),缺少理论保证这些信号在任意分布漂移下都能准确反映监督价值。当模型本身校准不良或遭遇突发性漂移时,这些信号可能给出误导性的批次选择,导致监督被浪费在低价值时期。实际部署中,不同任务和场景可能需要重新评估信号的有效性并调参。与理论驱动的预算分配方法相比,本文方法的性态边界不明确,难以提供最坏情况下的性能保障。
- 方法在选中批次内仅使用漂移准则挑选单个样本进行监督更新,虽然显著降低标注量,但单样本梯度可能带有较大噪声,尤其在多类别并发漂移或渐变漂移的流式场景中,模型收敛速度会受限制,甚至可能因样本代表性不足而引入偏差。此外,论文未考虑标注延迟对在线更新的影响;实际系统中标签往往无法即时获得,延迟会破坏“何时询问”与“何时更新”的时序对齐,从而降低整体适应效率。
- 与现有主动测试时适应(ATTA)工作相比,本文在预算约束下牺牲了一定性能上限。当标注预算充足时,逐批次查询标签的 ATTA 方法通常能获得更高精度,而本文的稀疏监督策略可能无法充分利用所有可用信息。此外,实验主要聚焦在 ImageNet 分类基准上,未验证分割、检测等密集预测任务或视频流等更复杂的时序分布漂移场景。在主动学习领域已有更成熟的批量选择准则,本文未与其进行充分对比,难以证明时序监督策略优于现有的不确定性采样或多样性采样方法。