打破均匀性陷阱:通过 SplitMoE 扩展视频扩散模型
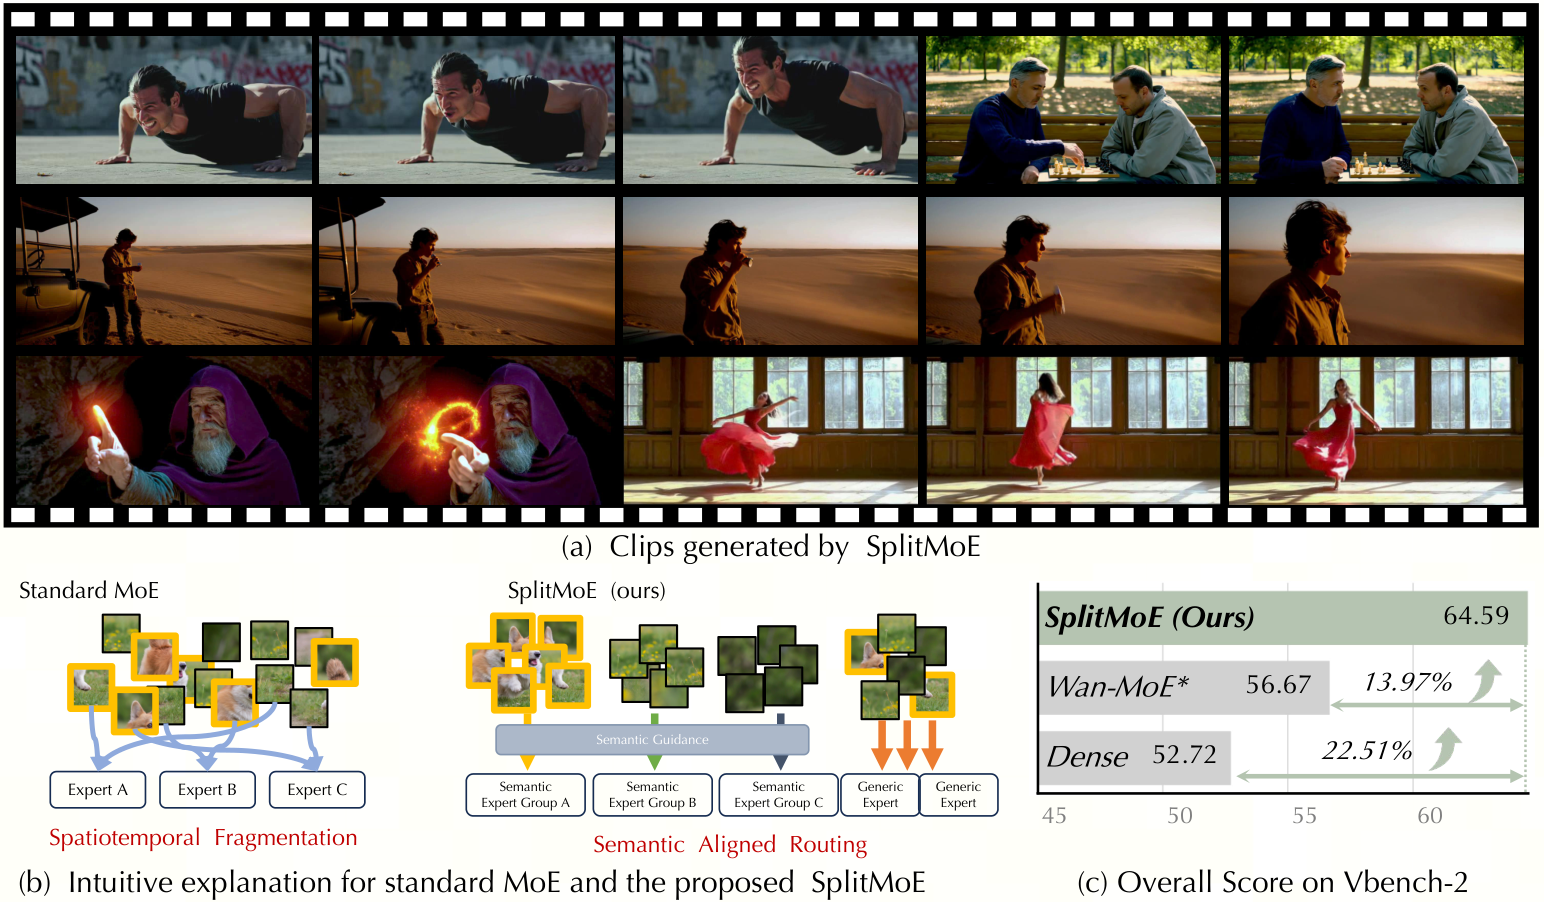
Mixture-of-Experts (MoE) 虽在大型语言模型中广泛流行,也被视为扩展视觉生成模型的有前景范式,但传统的 token-wise MoE 在同质专家池 中独立路由 token,并把专家使用正则化推向均匀,这与时空冗余、语义长尾的视频数据格格不入。作者指出,现有视觉 MoE 陷入了 uniformity trap(均匀性陷阱):语义组织不足的路由叠加均匀的专家使用正则,会把连贯的 patch 打散到彼此无关的专家中,造成路由碎片化 与 结构失真。 针对这一问题,作者提出 SplitMoE,一种分裂角色的稀疏架构。为容纳固有的语义不均衡,该方法将专家池显式划分为: - semantic experts:负责捕获高层语义抽象; - generic experts:保留残差视觉信息与灵活的生成能力。 借助 prototype-guided routing(原型引导路由)与 pull-push regularization(推拉正则),SplitMoE 使 token 按语义属性自然聚类,而非受任意均衡约束支配。 实验显示,在等量激活参数预算 下,SplitMoE 在收敛速度、路由一致性以及标准基准上的视频生成质量 均优于传统 load-balanced MoE。该工作还揭示了涌现出的由粗到细去噪逻辑,为社区提供了一条模态感知的扩展路径,对构建大规模视频世界模型 具有重要参考价值。
论文精读
TL;DR SplitMoE 打破视频扩散模型 MoE 的均匀性陷阱,将专家分裂为语义与通用两类,配合原型引导路由和 pull-push 正则,使 token 按语义聚类,同等激活参数下提升收敛速度、路由一致性与视频生成质量。
问题
问题背景
视频生成领域正从 Diffusion Transformers (DiTs) 走向更大参数规模,以捕捉复杂运动与长期一致性。Mixture-of-Experts (MoE) 作为从大语言模型迁移而来的稀疏扩展范式,被视为降低训练与推理成本的关键路径。
现有方法局限
当前视觉 MoE 普遍沿用 token-wise 路由 + 同质专家池 + uniform load-balancing regularization 的设计。该设计假设 token 分布均匀,并强制每个专家被等量使用。但视频数据具有强时空冗余和语义长尾分布,导致:
- 语义相关的 patch 被分散到不同专家,破坏空间连续性和物体结构;
- 均匀正则化强制调用不擅长该语义的专家,造成路由碎片化;
- 专家功能同质化,缺乏对高频语义与通用细节的差异化分工。
论文将这一现象称为 uniformity trap:语义组织不足的路由与均匀使用正则化相互叠加,加剧结构失真并拖慢收敛。
为什么这个问题难/重要
视频 token 的语义分布天然不均衡:背景、纹理等通用信息占多数,而人脸、运动主体等语义关键信息稀疏却重要。直接移除负载均衡会导致专家坍缩;坚持均匀则牺牲语义聚类,生成质量下降。因此需要在计算效率、负载均衡与语义结构化之间建立新平衡。业界对大规模视频世界模型的投入持续增长,如何在固定激活参数预算下同时提升生成质量与路由可解释性,成为实际部署的核心难题。
行业类比
类似推荐系统中为高频场景与长尾兴趣分别分配专家网络,或大语言模型中对通用知识与领域知识做专家分工:视频生成也需要让专家“各司其职”,而不是平均分配每一个 patch。
核心洞察
- SplitMoE 的 split-role 专家分工以语义结构约束替代均匀性约束,直击视觉 MoE 的 uniformity trap。现有视觉 MoE 采用同质专家池与负载均衡正则,强制专家使用趋于均匀,与视频 patch 的语义长尾分布相悖,导致连贯区域被切分、路由碎片化。SplitMoE 将专家分为语义专家和通用专家,分别处理高层语义抽象与残差视觉信息,使路由从“平衡负载”转向“语义聚类”,在相同激活参数下提升收敛速度与生成质量。该设计表明视觉生成 MoE 不应沿用 LLM 的均匀化先验,而应尊重模态内在的非均匀结构。
- 原型引导路由与 pull-push 正则构成可学习的语义组织机制,并揭示去噪过程中的 emergent coarse-to-fine 逻辑。SplitMoE 通过原型对齐和拉推正则让 token 按语义属性自然聚类,而非依赖手工规则或负载均衡;实验观察到路由时序呈现粗到细的去噪动态,说明专家分工随去噪阶段演变。这一发现将稀疏架构设计与生成过程联系起来,为视频世界模型提供了比单纯增加参数更有效的扩展路径:不是所有 token 都需要同一组专家,语义相关 token 应共享专家,而通用专家保留残差生成能力。
方法
SplitMoE 将视频 DiT 的 token 处理流程重构为“输入 → 专家角色拆分 + 原型路由 + 拉推正则 → 输出”。
- 输入:diffusion transformer 中经分块后的视频 token,具有时空冗余与长尾语义分布。
- 专家池拆分:不再采用同质专家池,而是显式分为
semantic experts(负责抽象语义特征)与generic experts(保留残差细节与灵活生成能力)。 - 原型引导路由:每个专家关联可学习原型,token 按与原型相似度分配;同时优化原型(配合 router alignment 与 prototype optimization 损失)以对齐 token 语义簇,而非任意平衡。
- 拉推正则:语义相关 token 被拉向语义专家原型,无关 token 被推离,减少路由碎片化与结构失真。
- 组感知负载均衡:在语义组内平衡负载,替代全局强制均匀。
输出:各专家处理后的特征融合,参与后续去噪;训练中呈现 emergent coarse-to-fine denoising logic。
与同类稀疏 MoE 的差异:用角色分工与语义原型替代统一专家池 + 均匀负载约束,使路由具备模态感知的语义结构性。
实验
实验设计
论文在标准视频生成基准上对比 SplitMoE 与传统负载均衡 MoE,保持相同激活参数预算,评估收敛速度、路由一致性与视频生成质量。具体数据集和指标数值未在摘要中披露。
关键发现
- 收敛速度:SplitMoE 在同等激活参数下比传统 load-balanced MoE 收敛更快。
- 路由一致性:通过 prototype-guided routing 与 pull-push 正则化,token 按语义属性自然聚类,避免 uniform expert usage 导致的路由碎片化。
- 生成质量:在视频生成质量上优于传统 MoE,且观察到 emergent coarse-to-fine denoising logic。
与基线对比的深度解读
传统 token-wise MoE 在 homogeneous expert pool 中独立路由每个 token,并强制专家使用率均匀化,这忽略了视频数据的时空冗余和语义长尾分布,使相干 patch 被分散到不同专家,导致结构失真。SplitMoE 将专家池显式分为 semantic experts 与 generic experts,前者捕获高层语义抽象,后者保留残差视觉信息与灵活生成能力,从而在相同计算预算下实现更优的专家分工。该设计为大规模视频世界模型提供了模态感知的扩展路径。
行业影响
落地场景
SplitMoE 可直接用于视频生成模型的规模化训练与推理,典型产品包括:
- 短视频创作工具:面向电商平台的商品动态展示生成,输入商品图与文案,输出多角度展示视频,SplitMoE 的语义专家可保证商品主体一致性,减少伪影。
- 内容平台 UGC 模板:风格化视频模板(如动漫风、电影感)生成,通过原型路由自动聚类语义区域(人物、背景),提升风格迁移稳定性。
- 企业服务:自动生成产品演示、培训视频,减少人工拍摄成本。
商业价值
- 降本:在相同激活参数预算下,SplitMoE 收敛更快、推理质量更高,意味着同等效果可减少训练步数,节约 GPU 时成本;同时稀疏激活降低单步推理计算量。
- 体验提升:解决路由碎片化与结构失真,生成视频的时空一致性更好,可直接降低后期人工修复成本。
- 增收:高质量视频生成能力可支撑 API 订阅、按次计费模式,扩大服务付费用户群。
现有工作流接口
SplitMoE 作为 DiT 架构的稀疏化插件,可无缝替换现有视频扩散 Transformer 中的 MLP 层:
- 在 Hugging Face Diffusers 或自研训练框架中,将
TransformerBlock的feed_forward替换为SplitMoELayer,保持残差与归一化结构不变。 - 对于已训练好的 dense 模型,可采用 MoE Upcycling 方式初始化专家权重,继续预训练或微调,降低迁移成本。
- 推理侧可基于 vLLM / TensorRT-LLM 等 MoE 推理引擎适配,利用分组负载均衡和原型路由的确定性,优化 batch 调度。
局限
- SplitMoE 将专家池强制划分为**语义专家**与**通用专家**,依赖**原型引导路由**,但这种二元结构在某些场景下可能不够灵活。当视频内容语义高度混合或与预设原型分布不匹配时,可能导致路由偏差。同时,语义专家与通用专家的比例、原型数量等关键超参数需人工设定,对数据集特性敏感,增加调参成本。论文未给出这些超参数的自动选择方法或详细敏感性分析,可能限制其在多样化视频生成任务上的即插即用能力。
- 实验主要基于标准视频生成基准,但论文未明确验证在更大规模模型(如数十亿参数)、更高分辨率或更长时序视频上的表现。虽然声称在等效激活参数预算下优于传统 MoE,但 SplitMoE 引入了额外原型存储和路由计算,总参数与内存开销可能更高,可能影响训练效率和部署成本。此外,论文主要关注收敛速度和生成质量,对推理延迟的讨论可能不足,而这对于实际视频生成系统至关重要。
- 与同类工作的对比主要集中在传统负载均衡 MoE 上,可能未充分比较其他稀疏或结构化路由策略(如专家选择路由、共享专家等)。论文揭示的粗到细去噪逻辑虽是观察结果,但未量化其与视频质量的具体因果关联。未来工作可进一步探索更灵活的动态专家划分及更高效的原型更新策略,以降低超参数敏感性和计算开销。