SoL-Refiner:高分辨率视频的光速级单步精炼
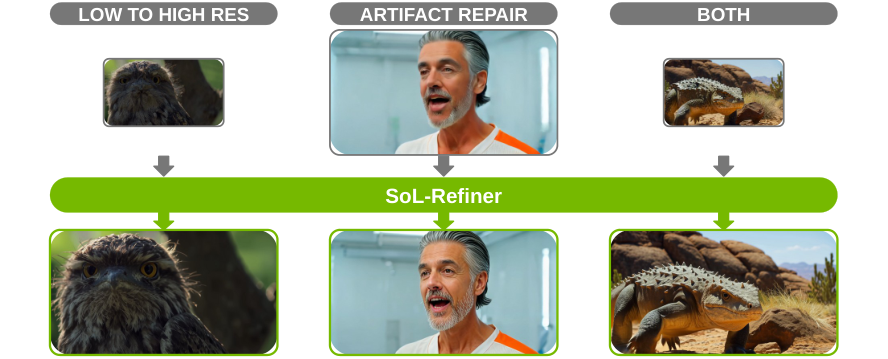
高分辨率视频生成代价高昂,其成本随时空 token 数量快速增长。一种实用的替代方案是先由低分辨率模型生成视频,再用 refiner 精炼,但传统的多步精炼会引入第二个采样瓶颈。 我们提出 SoL-Refiner ,一个单步视频 refiner,可通过单次去噪步骤将低分辨率模型的输出转化为 4K 视频。其三阶段配方依次结合了高分辨率持续训练、强化学习(RL)后训练,以及最终的单步蒸馏。 此外,我们提出 Refiner-Bench,一个由不同视频生成器输出构建的视频精炼基准,并采用共享输入协议,在约 2K 的输出分辨率下比较各类 refiner。 实验表明,在 2K 分辨率下,单步 SoL-Refiner 在 VBench 与 UniPercept 平均值上优于所有外部 refiner;在 3840×2176 下,它相对三步 LTX-2.3 Refiner 同时提升了两项指标。配合完整的加速栈,在 2K 延迟设定下, SoL-Refiner 的精炼延迟相比同一基线实现了 8.91 倍 加速。
论文精读
TL;DR SoL-Refiner 用单步去噪把低分辨率视频直接精炼到 4K,结合持续训练、RL 后训练和一步蒸馏,在 2K 基准上超越外部精炼器,延迟加速 8.91 倍。
问题
背景
高分辨率视频生成是当前生成模型落地的关键瓶颈,推理成本与输出分辨率之间的权衡成为研究焦点。
现有方法局限
现有做法常采用 两阶段生成:先低分辨率生成,再用 refiner 提升分辨率。但传统 refiner 依赖 多步扩散采样,形成第二个采样瓶颈。例如三步 LTX-2.3 Refiner 在 2K 输出下延迟较高,与低分辨率生成相比速度严重不匹配。直接生成高分辨率视频则面临时空 token 数随分辨率平方增长的问题,每步计算成本大幅上升,难以在有限算力下运行。
为什么难/重要
核心挑战在于 单步 refiner 必须一步完成高频细节恢复、时序一致性保持以及对不同 base generator 输出域的适应。这要求高质量配对数据、有效的强化学习信号和一阶段蒸馏策略,同时保证质量不降。业界对高分辨率视频的需求持续上升,推理延迟和能耗直接决定产品化可能性。
类比
该问题类似于图像超分辨率从多步扩散到单步感知蒸馏的演进,但视频还需额外处理时序维度,复杂度更高。
核心洞察
- One-step video refiner 通过三阶段配方(持续高分辨率训练、RL 后训练、单步蒸馏)消除第二采样瓶颈,并在 2K 及 4K 分辨率超越多步 refiner。相比传统级联模型在低分辨率生成后再做多步精修,SoL-Refiner 用 truncated-σ flow matching 训练 paired data,再用 RL 优化感知质量,最终单步蒸馏保留效率。这打破“refiner 必须多步”的假设,为高分辨率视频推理提供新加速路径。
- Refiner-Bench 采用 shared-input 协议,对同一低分辨率输入比较不同 refiner 的输出,避免不同基础生成器造成的评分偏差。此协议让 SoL-Refiner 与 LTX-2.3 Refiner 等外部模型在公平条件下对比,揭示单步模型在 VBench 与 UniPercept 上平均超多步模型。该基准贡献不仅服务本工作,也为视频超分/精修任务提供可复用的公平评测框架。
方法
输入:来自任意基础视频生成器的低分辨率视频 latent(或像素),输出目标为 2K 或 4K 高分辨率视频。
关键模块与流程
- 高分辨率持续训练:在配对低-高分辨率视频数据上,对预训练视频扩散模型进行继续训练。采用 truncated-sigma flow matching,仅在低噪声水平区间训练,让模型专注于恢复高频纹理与细节;低分辨率视频作为条件,模型初始化自预训练权重,避免从零学习空间先验。
- RL 后训练:使用可学习奖励模型(基于 VBench / UniPercept 等感知指标)对 refiner 进行强化学习微调,直接优化感知质量而非像素误差,使输出更符合人类偏好。
- 一步蒸馏:先进行 few-step 蒸馏,将多步 refiner 压缩至极少数步,再进一步蒸馏为单步模型。核心是让学生模型在一步内匹配教师模型多步输出或直接优化最终质量,消除第二采样瓶颈。
- 推断优化:配合 TensorRT 等加速栈,降低单步计算延迟,实现 8.91 倍加速。
输出:单步去噪即得到高分辨率视频。
与同类方法差异:常规多步 refiner 引入第二个采样瓶颈,SoL-Refiner 通过蒸馏与 RL 组合将 refinement 压缩为一步,同时保持或超越多步 refiner 的感知质量。
实验
实验设计
论文引入 Refiner-Bench,一个由不同视频生成器输出构建的视频精细化基准。采用 shared-input protocol 在约 2K 输出分辨率下比较各 refiner,并进一步在 4K (3840×2176) 分辨率下评估。主要指标为 VBench 和 UniPercept 平均值,同时测量 refinement 延迟。
关键发现
- 在 2K 分辨率下,单步 SoL-Refiner 在 VBench 和 UniPercept 平均值上超越所有外部 refiner。
- 在 4K 分辨率下,SoL-Refiner 在两个指标上均优于三步 LTX-2.3 Refiner。
- 完整的加速栈使 SoL-Refiner 在 2K 延迟设置中比 baseline 快 8.91 倍。
与基线对比解读
与多步 refiner 相比,one-step 蒸馏将采样步数压缩至一步,避免了二次采样瓶颈,同时保持或提升质量。8.91 倍的加速表明推理优化栈(如算子融合、低精度量化等)显著降低了延迟,对实时应用具有实际意义。跨分辨率性能的一致性则显示模型在高分辨率扩展性上的优势,为高分辨率视频生成的工程落地提供了高效路径。
行业影响
落地场景
SoL-Refiner 主打一步式高分辨率视频细化,可应用于需要快速产出 4K 视频的场景:短视频平台的内容增强、电商商品视频生成、影视预览与概念片渲染、游戏过场动画、以及在线教育课程视频。这些场景通常先用低分辨率模型快速生成内容,再通过细化提升画质。
商业价值
- 降本:一步细化替代多步,单次推理延迟降低 8.91 倍(对比三步 LTX-2.3 Refiner),同等 GPU 资源可服务更多请求,直接降低单位视频生成成本。
- 体验提升:低延迟获得高清视频,用户无需长时间等待,提升内容生产效率和用户满意度。
- 增收:可作为独立的高分辨率细化 API 售卖,或嵌入视频生成平台作为增值服务。
与现有产品/工作流集成
- 作为后处理插件:接收低分辨率视频 latent,输出高分辨率视频,无需改动上游生成器。
- 标准化接口:可封装为推理微服务,与现有视频生成管线的 scheduler 和存储对接。
- Refiner-Bench 提供统一评测基准,便于团队横向对比不同细化器。
具体 use case
- 电商产品视频:商家用低分辨率模型生成产品展示动画,然后调用 SoL-Refiner 一步细化到 4K,用于商品详情页和广告素材,缩短制作周期并降低渲染成本。
- 内容平台视频增强:用户上传低分辨率视频,平台后台自动细化到高清,提升整体内容质量和观看体验。
局限
- - **端到端质量受限于低分辨率基座生成器**:**SoL-Refiner** 作为单步 refiner,仅对低分辨率输出做条件增强,无法修复基座模型已产生的严重语义错误、物体畸形或结构崩塌。**Refiner-Bench** 仅采自若干视频生成器的输出,未覆盖真实低质视频、极端运动、传感器噪声等退化类型,因此在更广泛域上的泛化性存疑。
- - **单步蒸馏存在多样性/细节折衷**:从多步教师蒸馏到单步学生,容易造成生成多样性下降与精细纹理丢失。论文仅报告 **VBench** 与 **UniPercept** 平均分,未提供 FID、Inception Score 或用户研究等分布级/感知级指标,无法充分评估模式覆盖和样本丰富度,单步模型是否出现模式坍缩仍需进一步验证。
- - **4K 分辨率评估不充分**:在 3840×2176 下仅与 **LTX-2.3 Refiner**(三步)对比,缺少与其他外部 refiner 在 4K 下的横评;延迟分析主要针对 2K 设置,未量化 4K 实际吞吐与显存占用,**DGX Spark** 等边缘部署的能效比和可行性证据不足。