Context Language Models(上下文语言模型)
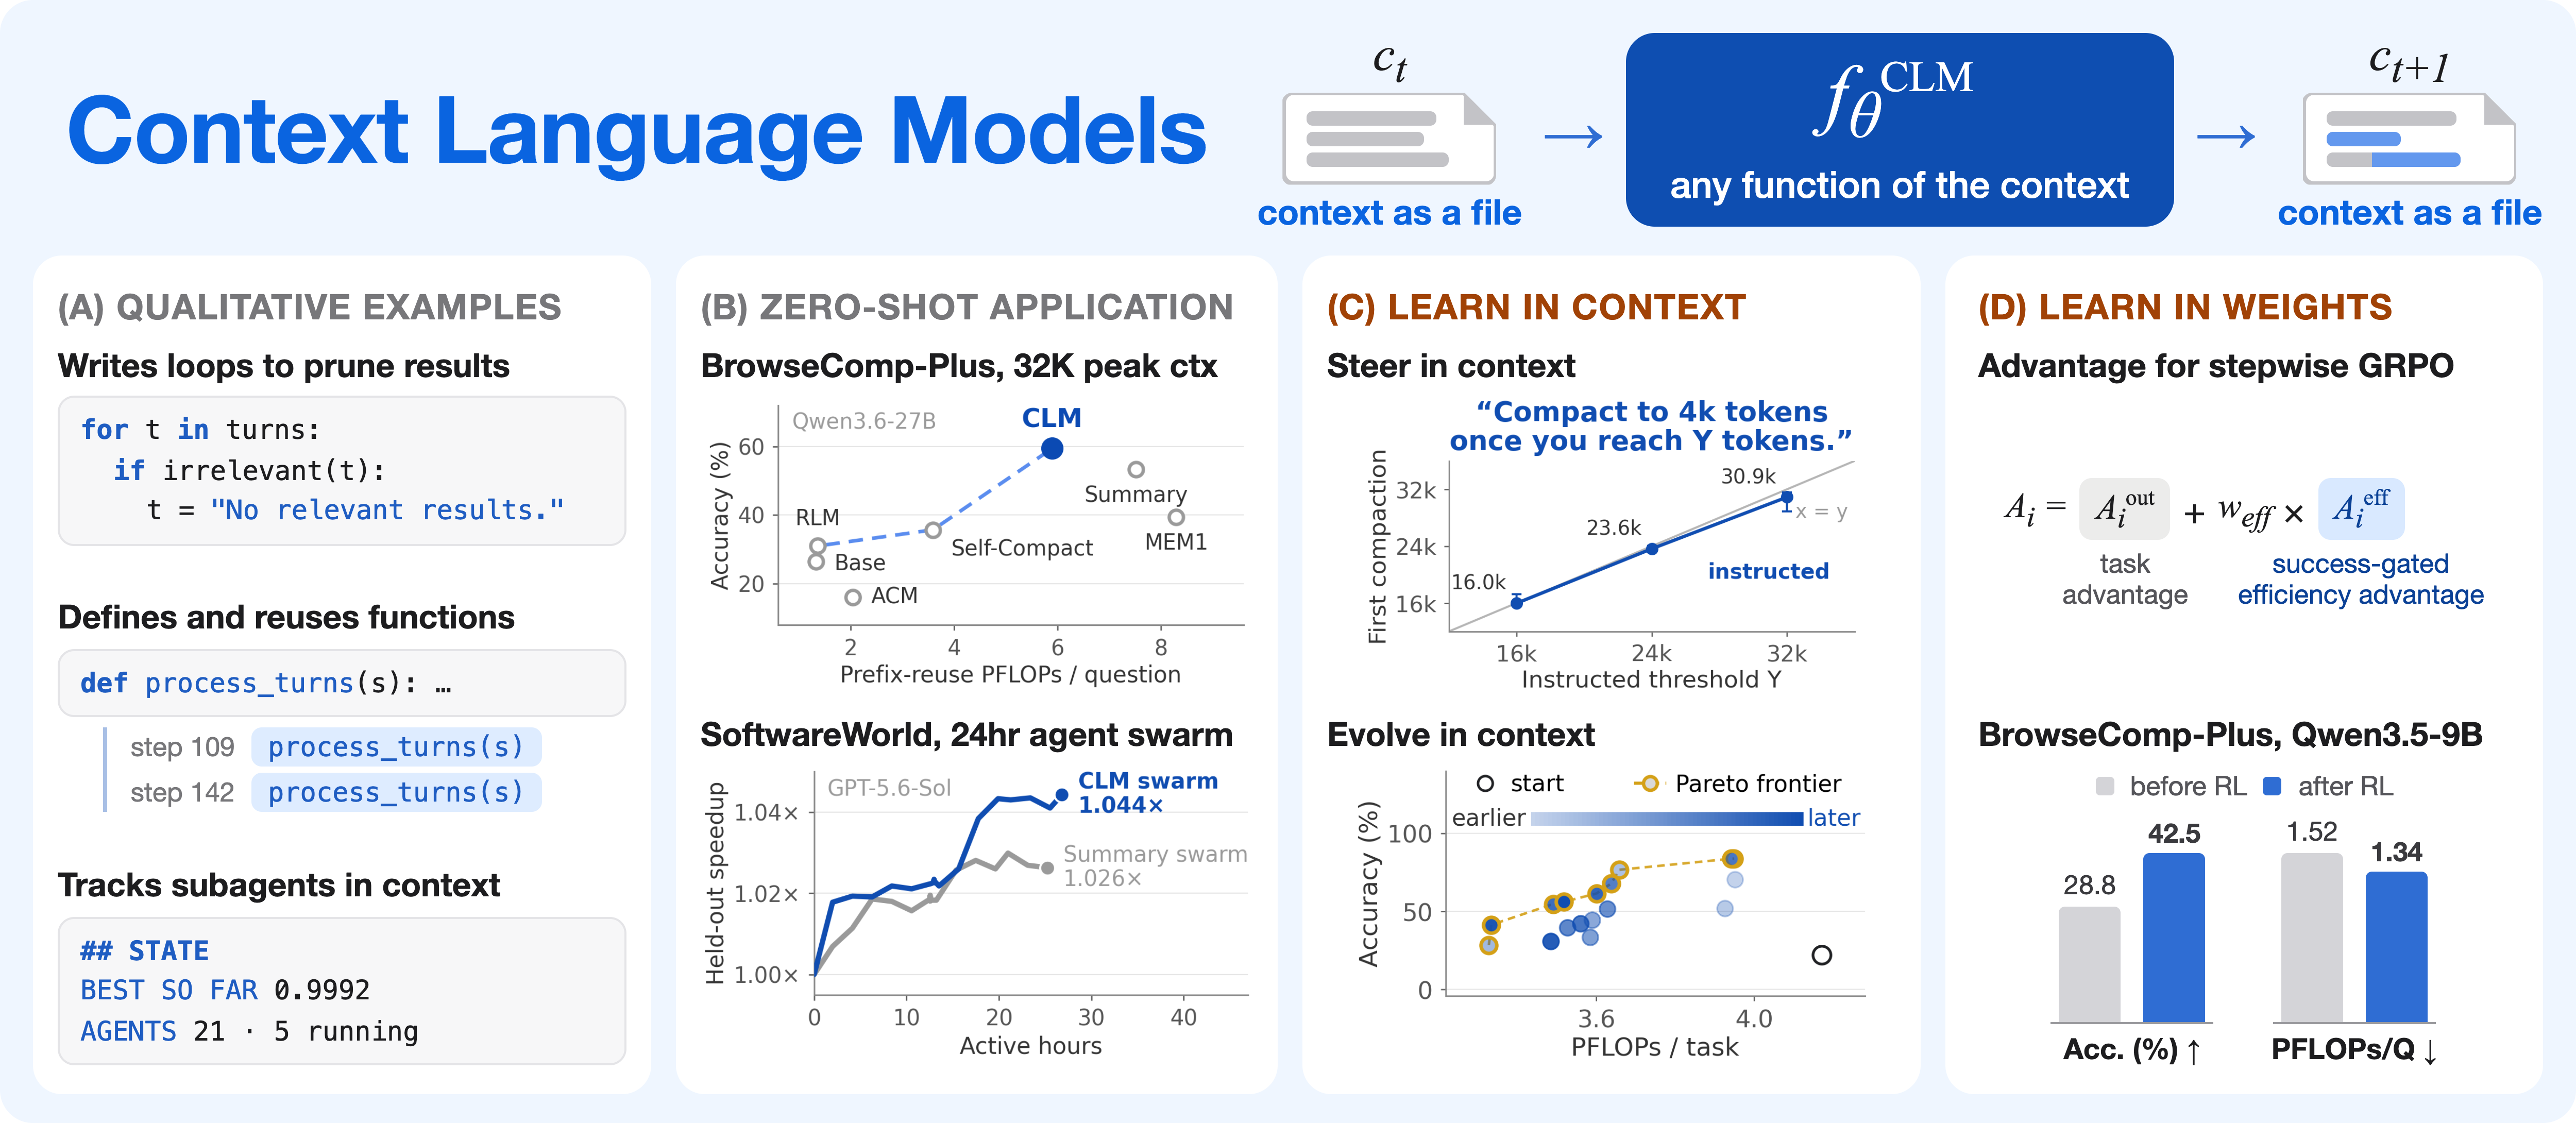
我们提出 Context Language Models (CLMs),一类能够原生管理自身上下文的语言模型。实现方式是把上下文当作一个文件,并允许模型对该文件做不受限制的更新。这样模型可以自行学习上下文中哪些内容最值得保留,并天然扩展到多智能体系统——多个 agent 的上下文作为文件并存。 零样本(zero-shot) 构建的 CLMs 在多种任务上超越了 SOTA 上下文管理策略: - BrowseComp-Plus:准确率高 11.4%,FLOPs 少 21.5%; - 12 小时 EdgeBench:得分高 5%,FLOPs 少 59%; - 24 小时多仓库 agent-swarm 任务:同等算力下改进幅度高 65%。 把上下文管理从外部 harness 控制转为模型内在行为后,CLMs 可同时支持上下文管理策略的 in-context 与 parametric 学习。用标准 skill-optimization 循环演化出的自然语言指令加以引导,可在降低算力的同时把 held-out 准确率最多提升 35.9 点;新提出的在线强化学习方法让 Qwen3.5-9B 在 BrowseComp-Plus 上性能提升 47.6%,FLOPs 减少 12%。 我们还为 CLM 服务联合设计了 Suffix Cache Reuse,在性能持平的情况下使服务端算力相对标准 SGLang 再降低 35%。
论文精读
TL;DR CLM 让语言模型把上下文当作可自由编辑的文件,自主决定保留或删除信息,零样本即在多项长程任务上超越现有上下文管理策略并大幅降低 FLOPs。
问题
问题背景
长上下文语言模型在智能体、深度研究等长时程任务中,上下文长度随交互持续增长,如何高效管理上下文窗口成为关键瓶颈。
现有方法局限
- 多数模型依赖外部 harness 进行上下文管理,如定期摘要、裁剪或重排,模型本身对上下文无原生控制权。
- 动作空间受限:现有方法仅在预定义的有限动作集(如保留/丢弃文本块)中选择,无法对上下文做细粒度、任意位置更新。
- 策略固定:外部调度策略难以适应不同任务分布和资源约束,且与模型推理分离,难以进行端到端优化。
- 计算冗余:上下文管理决策往往不能感知后续计算开销,导致不必要的 KV cache 计算和存储。
为什么这个问题难/重要
- 技术挑战:上下文管理本质是一个序列决策问题,需要模型在推理过程中动态权衡信息保留与计算成本,但当前 LLM 缺乏内在的上下文状态更新机制。
- 业界关注:长时程智能体任务(如 12 小时 EdgeBench、24 小时多仓库 swarm)中,上下文线性增长导致 FLOPs 急剧上升,成为部署瓶颈。提高上下文管理效率可大幅降低计算成本,同时提升任务性能,具有很高的实用价值。
行业类比
类似于代码智能体在长时间浏览大型代码库时,需要自主维护一个工作记忆文件(如记录已探索模块、关键依赖),而不是依赖外部脚本定期清理历史对话。
核心洞察
- 上下文管理范式转变:从外部调度到模型内生行为。CLM 将上下文视为模型可自由更新的文件,打破了此前上下文管理要么由外部 harness 预定义调度、要么在受限动作空间内让模型选择的局限。这种无限制更新使模型能够根据任务动态学习维护什么信息,并且天然支持多智能体环境中多个上下文的共存与交互。对工程而言,这意味着上下文不再是被动存储,而是主动计算的一部分,为构建完全自组织的智能体系统提供了新的抽象。
- 零样本 CLM 即展现效率优势,说明现有上下文管理策略存在显著可优化空间。通过在 BrowseComp-Plus、EdgeBench 等长时程任务上的实验,CLM 零样本构建即比 SOTA 策略准确率更高且 FLOPs 减少 21.5%–59%,证明让模型自己管理上下文比手工设计的启发式策略更有效。这启示实际工程中可将上下文管理作为模型的可学习组件,而非固定 pipeline,同时为后续通过 in-context steering 或 RL 进一步优化留出了明确空间。
- 学习与服务的协同设计:Suffix Cache Reuse 释放了编辑型上下文的推理加速潜力。传统 prefix cache 无法处理模型频繁修改上下文带来的 KV cache 失效,而 CLM 通过将编辑视为 suffix 保留,使服务端可复用未修改的后缀部分,额外降低 35% 计算。这一系统级优化与模型行为共同进化,展示了算法-系统联合设计在降低长上下文推理成本中的重要性,也提示未来上下文管理方法的评估应包含服务端效率指标。
方法
输入与建模
CLM 将模型当前上下文视为一个上下文文件(context file)。模型在每一步推理中除了生成常规 token,还可输出针对该文件的无限制更新操作(如追加、删除、替换片段)。更新后的文件内容作为后续推理的输入,使模型自主决定保留、压缩或丢弃信息。多智能体场景下,每个 agent 拥有独立的上下文文件,自然扩展为文件集合。
关键模块
- 文件更新接口:模型通过预定义的动作语法(如写入/擦除标记)操作上下文文件,将上下文管理从外部 harness 调度转为模型内在行为。现有 LLM 无需微调即可通过提示启用该接口,实现零样本构建。
- 策略学习:
- In-context 进化:用自然语言描述上下文管理策略,通过标准 skill-optimization loop(如进化搜索)优化指令,提升 held-out 准确率。
- Online RL:将文件更新操作作为 action,设计 success-conditioned efficiency reward(准确率与计算量约束),对模型参数进行强化学习(如
Qwen3.5-9B)。
- Suffix Cache Reuse:服务端针对 CLM 的文件更新模式,复用后缀 KV cache,降低 server-side compute。
输出
模型基于自己维护后的上下文文件生成最终回答,在长时程任务中保持关键信息,减少冗余 FLOPs。
差异点:与外部 harness 控制的上下文调度(如 SGLang 的 prefix cache 策略)不同,CLM 把上下文管理内化为模型可学习行为,使策略可通过 in-context 或参数化优化持续进化。
实验
实验设计
CLM 将上下文视为一个文件,模型可对文件进行无限制的更新,从而自主决定保留或删除信息。实验首先在 BrowseComp-Plus、EdgeBench、Software World(24 小时多仓库多智能体任务)等长时程任务上,与当前 SOTA 的上下文管理策略(通常由外部 harness 调度压缩或裁剪)做 zero-shot 对比。同时引入 ContextBench 与 TerminalBench 2.1 作为隔离诊断。学习层面,通过 skill-optimization loop 进化自然语言指令实现 in-context steering,以及在线 RL 方法微调 Qwen3.5-9B。Serving 方面提出 Suffix Cache Reuse,对比标准 SGLang 前缀缓存。
关键发现
- zero-shot CLM 在 BrowseComp-Plus 上准确率提升 +11.4%,同时 FLOPs 减少 21.5%
- EdgeBench 得分提升 +5%,FLOPs 减少 59%
- 多仓库智能体集群任务,同等算力下 improvement 提升 +65%
- in-context evolution 使 held-out accuracy 最高提升 35.9 个百分点,并降低计算
- RL 微调 Qwen3.5-9B 在 BrowseComp-Plus 上性能提升 +47.6%,FLOPs 减少 12%
- Suffix Cache Reuse 使服务端计算比 SGLang 再降 35%,性能不变
与基线对比的深度解读
传统方法将上下文管理作为外部工程问题,依赖固定预算的裁剪或压缩,模型无法根据任务动态权衡。CLM 把控制权交还模型,通过文件读写机制让模型自主决定保留哪些信息,这在长跨度、多智能体场景中优势明显——不仅效果更好,而且因为丢弃不必要 token,FLOPs 显著下降。RL 与 in-context evolution 进一步说明该范式支持参数化和上下文内两种学习路径,可针对特定任务优化策略。Suffix Cache Reuse 利用 CLM 编辑上下文的稀疏性,突破传统前缀缓存局限,是配套 serving 的关键创新,表明 CLM 全栈效率潜力。
行业影响
落地场景
CLM 将上下文管理从外部 harness 移入模型自身行为,使模型能自主决定保留、删除或修改上下文内容。这对长时程智能体任务最具价值:
- 深度研究与代码智能体:如 BrowseComp-Plus、TerminalBench 等场景,模型在长时间运行中自行维护关键信息,避免上下文污染和遗漏。
- 多智能体系统:每个智能体上下文作为独立文件共存,CLM 原生支持多智能体协作,无需额外的中央调度器。
- 企业知识工作流:如金融分析、法律检索、医学文献综述等,需要长时间跨文档推理的任务,CLM 可降低上下文膨胀导致的性能衰减。
具体落地 use case:
- 电商智能客服与个性化推荐:智能体在处理用户多轮会话时,自主管理用户画像、历史订单、实时意图等关键信息,避免无关信息占用窗口,提升响应准确率和个性化程度。
- 企业级数据分析与报告生成:数据分析智能体在查询数据仓库、调用工具链过程中,CLM 自行维护中间结果与关键假设,减少重复计算和外部缓存依赖,直接降低 API 调用成本和延迟。
商业价值
- 降本:论文显示 CLM zero-shot 在 BrowseComp-Plus 上以 21.5% 更少 FLOPs 获得 11.4% 更高准确率;Suffix Cache Reuse 进一步降低服务端 35% 计算。对按 token 计费或自建推理集群的企业,可显著减少 GPU 消耗。
- 增效:在 12 小时 EdgeBench 上,CLM 用 59% 更少 FLOPs 获得 5% 更高分数;多仓库智能体群体任务中,相同算力下提升 65%。长时任务成功率提升直接减少重试和人工干预。
- 产品体验:上下文管理策略可通过自然语言指令 or RL 学习进行自适应优化,模型能根据任务动态调整,避免固定窗口截断或摘要导致的上下文丢失,提升输出一致性与可靠性。
与现有产品/工作流的接口
- 推理框架集成:Suffix Cache Reuse 已实现在 SGLang 上,可作为独立模块集成到现有 serving stack,无需更换上游模型或业务逻辑。
- 模型微调与 RL 流水线:CLM 支持 in-context 和参数化学习,企业可复用现有 RLHF/DPO 基础设施,将上下文管理作为可优化行为加入奖励信号中。
- 多智能体编排:CLM 天然适合去中心化的多智能体架构,无需中心化记忆模块,可替换现有 LangGraph/AutoGen 等框架中的上下文管理组件,降低编排复杂度。
局限
- **上下文更新的计算开销与效率权衡**:CLM 将上下文视为可自由更新的文件,模型可能产生大量不必要的写入操作,导致 token 消耗增加,部分抵消了在关键任务上节省的 FLOPs。论文在 BrowseComp-Plus 等基准上展示了整体 FLOPs 减少,但未提供对写入频率、单次写入 token 开销与最终性能之间关系的定量分析。实际部署中需要额外的裁剪或预算控制机制,避免长时任务中上下文文件无限膨胀。
- **对基础模型指令跟随能力的强依赖**:零样本 CLM 建立在现有模型的指令执行能力之上,其上下文管理质量高度依赖模型能否准确理解并执行“更新文件”等操作。对于参数规模较小或指令微调较弱的模型,可能无法有效管理上下文,甚至破坏有用信息。论文实验主要在 Qwen3.5 系列等高性能模型上进行,缺少跨模型家族、跨参数规模(如 1B-7B)的系统性评估,限制了方法在低资源场景下的适用性。
- **多智能体一致性与安全对齐未充分解决**:在多智能体系统中,多个 agent 的上下文文件并存且相互读取,可能引入竞态条件、信息冲突或级联错误。模型自主修改上下文也带来安全风险,例如恶意或错误地删除关键约束、注入有害指令。论文未讨论文件级访问控制、冲突消解机制或对模型编辑行为的对齐训练,这些是实际多智能体部署前必须解决的关键问题。