路由应当自付成本:面向经济型 LLM 路由的稀疏监督
LLM 路由 通过为每个查询分配合适的模型来降低服务成本,同时保持回复质量。但训练这样的路由器通常需要在历史查询上执行多个候选模型,以收集 query–model 质量反馈,在部署前就产生不可忽视的监督成本。现有工作多关注服务时效率,却忽略了节省的开销是否足以回收这笔前期投入。我们还观察到,路由质量往往在收集完所有反馈之前就已饱和,稠密监督 在经济上可能属于过度供给。 我们提出 SaveRouter,一种稀疏监督路由框架:它选择性地获取有信息量的模型反馈,并在相关查询之间共享能力信息,同时保留查询级细化以实现细粒度路由。评估时,我们同时计入监督开销与后续服务节省。 在四个路由基准上,主设置仅用约 33–41% 的可用训练反馈,即维持相当或更优的路由质量,并将 盈亏平衡部署量 相比最快的传统路由器降低约 1.9–9.5 倍。进一步分析显示,获取更多监督并不总是更经济:使服务成本最低的监督水平,可能与最早回本的水平不同。代码开源于 https://github.com/LAMDA-Model-Reuse/SaveRouter 。
论文精读
TL;DR SaveRouter 提出稀疏监督路由:只采集约 33-41% 训练反馈即可达到竞争路由质量,显著降低部署前的监督成本与盈亏平衡点,让路由学习真正“自负盈亏”。
问题
问题背景:LLM 推理成本高企,routing 技术通过为每个 query 动态选择合适模型,在保持响应质量的前提下降低服务开销,已成为模型部署的关键环节。
现有方法局限:主流 router 的训练依赖历史 query 在所有候选模型上的执行结果,以收集 query-model 质量反馈。这类密集监督的前期成本十分可观:假设候选模型规模较大,需要付费调用多个大模型 API 或本地推理全部候选。现有研究几乎只关注 serving-time 的调度效率,却忽略监督支出能否被后续节省覆盖。此外,作者观察到 routing 质量在反馈收集比例未达 100% 时已饱和,说明密集监督存在过度供给。
难点与重要性:核心挑战在于如何主动挑选信息量高的反馈样本、迁移相似 query 的能力估计,并保留 query 级残差处理细粒度差异,同时联合优化前期监督支出与后期服务节省。业界对 LLM 部署成本日益敏感,单纯追求路由准确率而忽视投资回报率难以持续。需要引入 SA-BEP(监督调整后的盈亏平衡点) 等经济指标,对 router 的全生命周期成本进行核算。
行业类比:类似推理优化中若 profiling 开销超过最终节省的算力,优化本身就失去意义;SaveRouter 让 router 训练也遵循 ROI 原则,只采集能带来净收益的反馈。
核心洞察
- 路由学习的前期监督成本应纳入全生命周期经济性评估,而非只关注部署后的服务期效率。现有工作普遍忽略收集 query-model 质量反馈所需的执行成本,SaveRouter 首次将 upfront supervision expenditure 与后续 serving savings 联合建模,提出 SA-BEP(supervision-aware break-even point)等指标,揭示仅优化 serving cost 会导致经济上不可持续的方案。这一视角转换迫使从业者重新审视“更准的路由器是否真的更省钱”,尤其是在中小规模部署中,监督成本往往占据主导地位。
- 路由质量存在明显的饱和效应,密集收集所有 query-model 反馈在经济上属于过度供给。实验表明仅使用 33–41% 的可用训练反馈即可达到竞争甚至更好的路由质量,SaveRouter 通过自适应稀疏采集、层次化能力估计和查询级残差校正实现这一目标,将 break-even deployment volume 相比最快传统路由器降低约 1.9–9.5 倍。这直接挑战了“更多监督一定更好”的默认假设,证明稀疏监督策略不仅能降低前期投入,还可能因减少噪声反馈而提升泛化能力。
方法
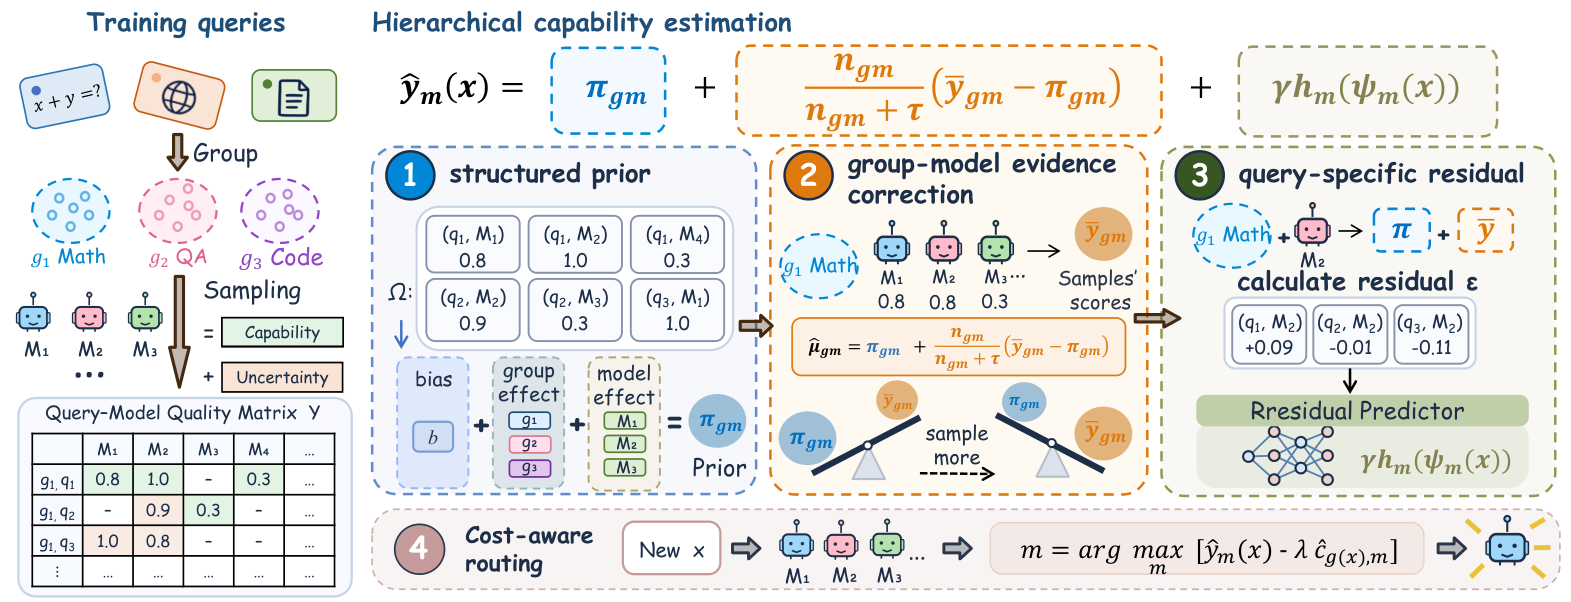
SaveRouter 的输入是一批历史查询与候选模型池,但不需要预先收集所有查询-模型质量反馈。它通过三个核心模块完成稀疏监督下的路由学习。
关键模块
- 自适应稀疏反馈获取:在训练循环中动态估计每个查询-模型对的信息量,优先选择不确定性高或对路由决策影响大的反馈执行模型推理,避免稠密标注带来的前期开销。
- 分层能力估计:将语义相近的查询划分到同一组,在组级别共享模型的能力先验,例如用组内少量反馈估计整体性能分布,减少逐查询冷启动成本。
- 查询级残差校正:在组级估计基础上,为每个查询学习轻量残差,修正组内个体偏差,保留细粒度路由能力,防止过度分组造成质量损失。
输出是一个训练好的路由器,对新查询输出模型分配策略;同时训练过程的总成本(监督采集 + 后续服务推理)被显式纳入优化,路由盈亏平衡点(break-even deployment volume)显著提前。与既有聚焦 serving-time efficiency 的路由方法不同,SaveRouter 将监督采集支出计入总账,通过稀疏采样 + 分层共享 + 残差细化在更少反馈下达到同等路由质量。
实验
实验设计
SaveRouter 在四个路由基准上评估(文摘未逐一列出,补充实验包含 RouterEval),核心设定是联合计算监督支出和服务期节省。作者引入经济指标 SA-BEP(break-even point)和 SA-CR(cost reduction),通过改变监督预算,对比 dense supervision 与几种常规路由器(如最快路由)。训练反馈通过自适应稀疏获取,仅选择信息量大的 query-model 对进行查询,并结合层级能力估计。
关键发现
主实验中,SaveRouter 仅使用 33–41% 的可用训练反馈,即达到与全量监督相当或更好的路由质量;同时,与最快的常规路由器相比,break-even 部署量降低约 1.9–9.5 倍。进一步分析表明,更多的监督并非总是经济上最优:使服务成本最小化的监督水平,与最早回本所需的监督水平可以不同。这表明路由学习中的监督存在过度供给现象,稀疏监督可以同时降低前期投入和加速回本。
基线对比与工程启示
与只优化服务效率的 dense routing 方法不同,SaveRouter 首次显式考虑监督采集成本对整体经济性的影响。对比实验显示,dense supervision 在路由质量饱和后继续增加反馈,只会增加支出而不会带来显著增益。实际工程中,部署 LLM 路由前应权衡反馈采集预算与预期流量——低成本监督 + 尽早回本对于中小规模流量尤其重要。代码已开源:SaveRouter。
行业影响
落地场景
SaveRouter 直接适用于需要动态调度多个 LLM 的推理平台,如模型路由网关、企业级 LLM 服务、RAG 后端等。具体场景包括:
- 电商智能客服:用户问题复杂度差异大,可以将简单 FAQ 路由到 Llama-3-8B,复杂售后问题路由到 GPT-4 级模型。通过 SaveRouter 仅对少量历史 query 采集多模型反馈,即可训练出高质量路由策略。
- 内容平台内容审核:视频/图文平台每天产生大量审核请求,不同内容类型对模型能力要求不同,使用路由后能在保证准确率的同时大幅降低推理成本。
商业价值
核心是降低 路由训练的前期数据成本。传统做法需要在大规模历史 query 上并行运行多个候选模型来获取反馈,成本可能超过后期节省。SaveRouter 只用约 33-41% 的反馈数据即可达到同等或更优路由质量,使 盈亏平衡点 提前 1.9-9.5 倍。这意味着:
- 降本:减少标注和推理冗余支出,让中小团队也能负担起 LLM 路由部署。
- 提速:更快达到成本回收,缩短从技术验证到生产收益的周期。
与现有工作流集成
SaveRouter 可作为训练侧组件嵌入现有 routing 框架(如 RouteLLM、LiteLLM 等):
- 接入历史 query 日志,通过
adaptive sparse feedback acquisition选择性地将少量 query 发送给候选模型获取反馈。 - 基于
hierarchical capability estimation和query-level residual correction输出轻量 router 权重,可直接部署到推理网关中,无需改变在线服务链路。
局限
- 论文在四个 benchmark 上评估,模型池规模相对有限(主要涵盖 4-6 个模型),且成本核算依赖特定云服务定价假设和固定缓存策略。实际部署中服务商价格模型、批量折扣、网络延迟和缓存命中率存在较大差异,可能导致 break-even 部署量显著偏离论文报告值。此外,路由质量统一采用准确率或偏好分数等单一指标,未全面考虑不同任务对质量损失的容忍度差异,例如代码生成与闲聊对错误响应的代价完全不同,这可能高估稀疏监督在异构任务上的普适性。
- SaveRouter 的核心是层次能力估计,依赖查询分组或相似性度量来共享模型能力信息。该方法隐含假设相似查询的模型相对性能具有可迁移性,但当查询分布高度异质、长尾查询占比高或任务上下文快速变化时,共享可能引入系统性偏差,导致路由器将查询错误分配给不合适的模型。论文未对分布漂移、对抗查询或极端稀疏(反馈比例低于 30%)场景进行深入分析,实际应用中可能需要动态调整分组粒度或引入不确定性校准机制。
- 稀疏反馈获取策略在离线实验中仅使用 33-41% 的反馈,但这是基于静态历史数据集模拟的结果。在线部署时,查询到达流与反馈收集过程存在交互:主动选择哪些查询执行多模型推理会改变系统负载分布,可能造成延迟尖峰或资源争用;同时反馈延迟和探索-利用权衡也未在论文中讨论。因此,SaveRouter 的算法框架距离生产环境仍有一定距离,需要进一步设计在线学习版本以平衡监督成本、路由性能与系统稳定性。