提示的身份标签会削弱多智能体 LLM 系统中的合作
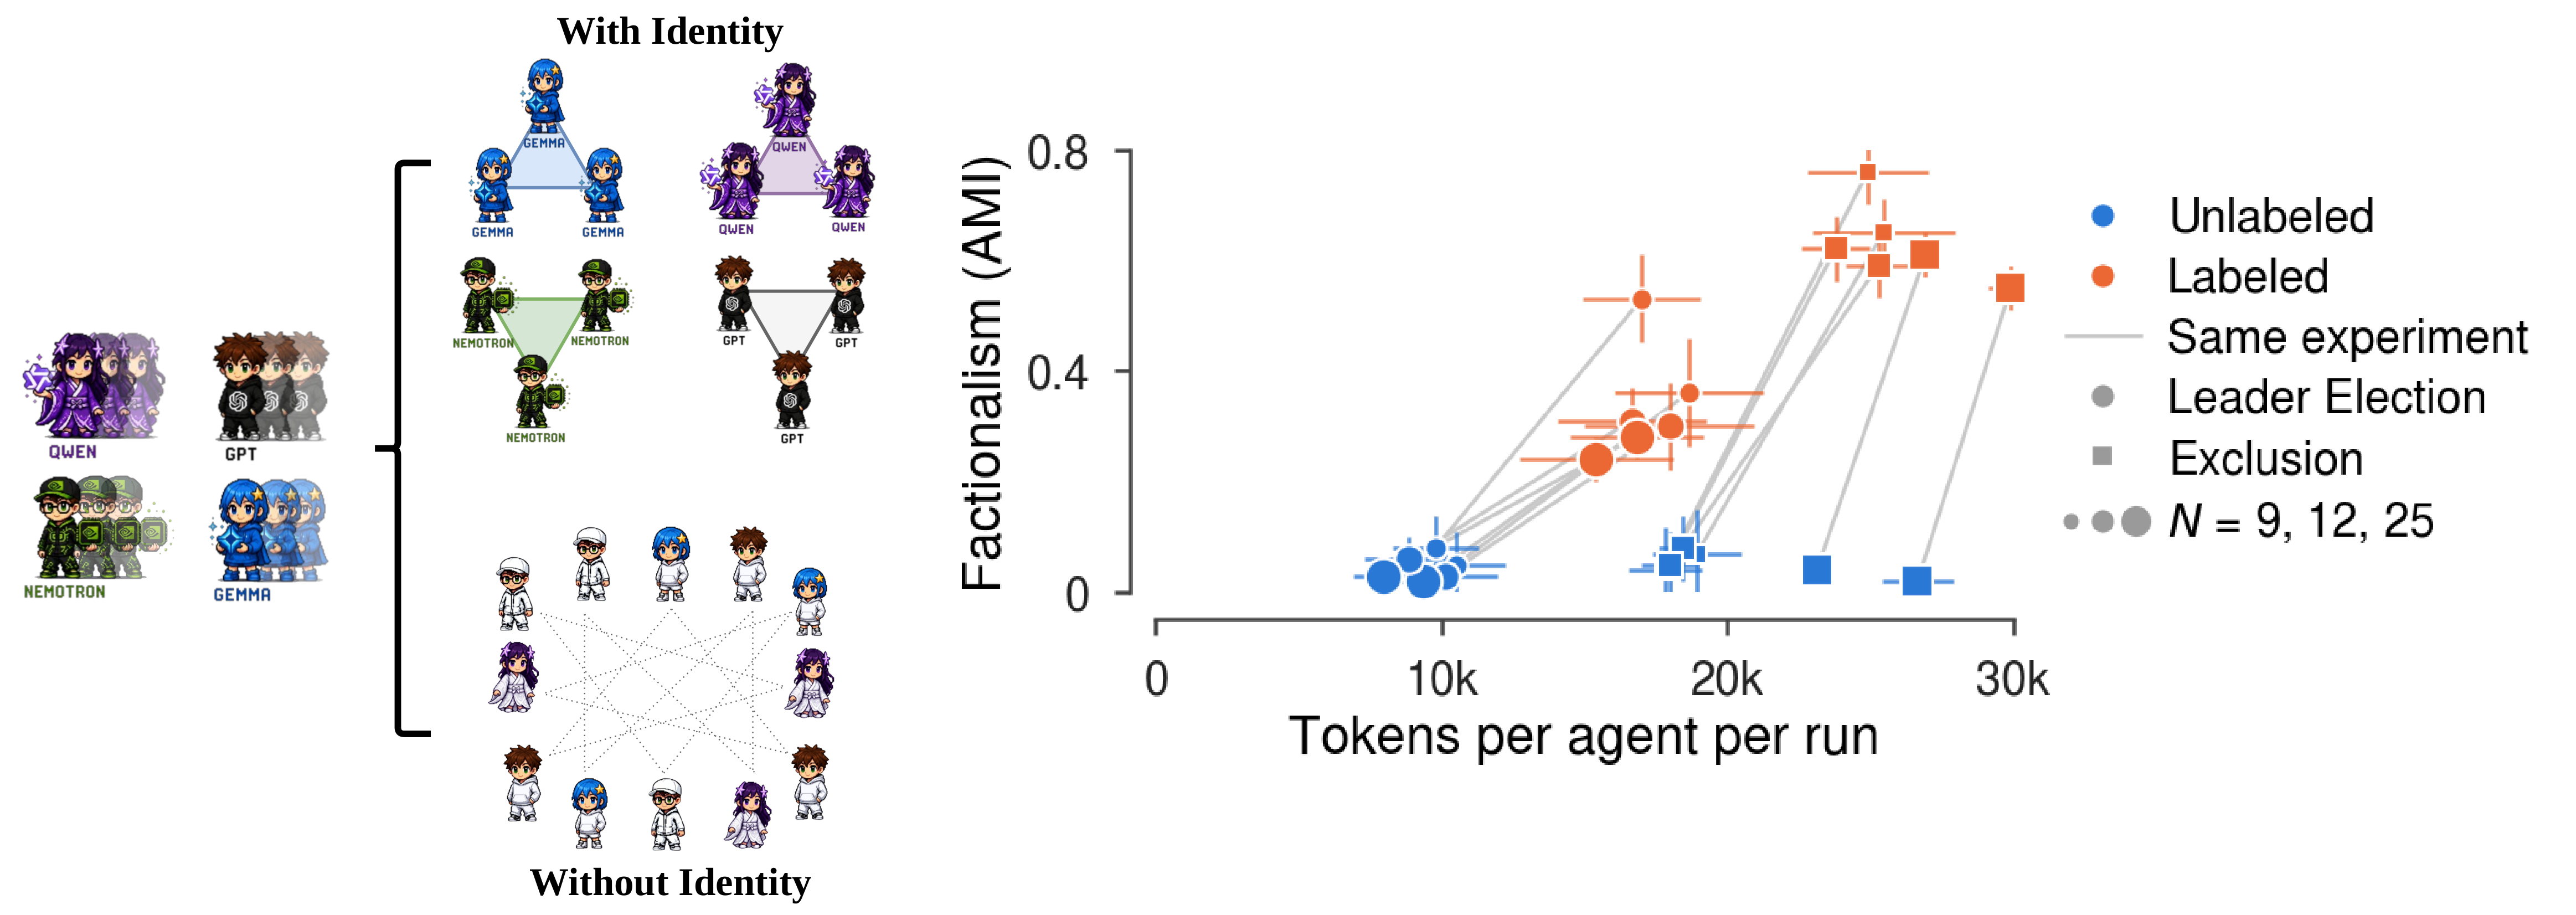
多智能体 LLM 系统 正越来越多地混合来自不同厂商的模型,但一旦把每个 agent 背后的模型身份暴露给同伴,合作就会显著受损。 我们发现,当 agents 知道彼此的 模型家族 时,群体会分裂成若干簇:agents 更偏好与拥有相同标签的同伴互动,而任务本身既不奖励也不要求这种分裂。我们将这种由标签本身引发的现象定义为 factionalism(派系化)。我们在两个 合作博弈 任务和一个 推理基准 上验证并测量了该现象,涉及 9 至 25 个 agent、最多 5 个 开放权重模型家族。当公布的家庭标签被打乱、或替换为 任意标签 时,派系仍跟随这些信息;而移除标签后,该行为随之消失。 在严格合作任务中,带标签的组平均需要多 30% 的轮次和 55% 的 token 才能达成决策,成功率从 96% 降至 81%。该效应在不同任务、群体规模和模型家族上均可复现,而不向 agents 透露身份标签是一种简单有效的缓解方式。
论文精读
TL;DR 在多智能体 LLM 系统中,暴露各 agent 的模型家族身份会引发派系分裂,导致合作效率下降(成功率从 96% 降至 81%,多花 30% 轮次、55% tokens),而隐藏身份标签即可简单有效缓解。
问题
问题背景
多智能体 LLM 系统(multi-agent LLM systems)正成为复杂 AI 任务的主流方案,多个模型协同完成规划、编码、审查等,异构模型混合已普遍。
现有方法局限
当前框架通常默认向智能体暴露模型身份信息,如 "You are GPT-4" 或 "You are Claude"。论文证明这种标签会引发 派系主义(factionalism):即使任务无任何奖励或要求,智能体也偏好与相同模型家族的个体交互,形成聚类。现有方法既未考虑身份隐藏作为设计选项,也缺乏检测这种非任务性分裂的机制。身份元数据常被框架自动传递,工程上难以察觉。而且该现象在两种合作博弈与 GPQA-Diamond 推理基准上,使用 9 到 25 个智能体、最多 5 个开源模型家族,均稳健复现。
为什么这个问题难/重要
标签本身不含任务相关信息,但 LLM 却将其作为社交线索,导致严格合作任务中,标记组平均多耗 30% 轮次、55% tokens,成功率从 96% 降至 81%。这颠覆了“更多信息总有益”的默认假设。困难在于,该行为深植于预训练分布,不是通过简单提示工程可消除;且异构多智能体系统在业界已广泛部署,模型身份通常被无意泄露。若不解决,所有依赖多模型协作的生产系统都可能遭遇隐性效率损失。
行业类比
类似在自动代码审查流水线中,若审查员智能体看到彼此的底层模型名,可能形成“GPT 派”和“Claude 派”,偏向同类意见而忽视代码质量,拖慢合并流程。
核心洞察
- 身份标签本身是触发多智能体分裂的因果因素,而非模型能力差异或任务激励。作者通过将标签随机洗牌或替换为任意符号,观察到派系仍跟随标签信息形成;而隐藏标签后该行为消失。这一发现区别于以往主要关注模型能力、提示策略或奖励设计的工作,揭示了模型提供商元数据可能成为隐蔽的协调障碍,对多智能体系统设计者提出新的警示。
- 在严格合作任务中,标签可见导致显著效率损失:多花约 30% 轮次和 55% tokens,成功率从 96% 降至 81%,且效果在不同任务、群体规模和模型家族间稳健复现。简单的缓解手段是向 agent 隐藏身份标签,即可恢复大部分性能。这对实际部署多智能体 LLM 系统具有直接工程启示:应避免在 agent 间交互中暴露不必要的模型身份信息,同时需防止身份信息通过其他渠道泄露。
方法
本文方法围绕多智能体 LLM 系统中的身份标签注入与 factionalism 测量 展开。
输入:一组来自多个开源模型家族(如 Llama、Qwen、Mistral 等)的 agent,每个 agent 的 system prompt 中显式声明其底层模型家族标签,但该标签不进入任务奖励或指令。任务覆盖两个合作游戏(Leader Election、Exclusion)和一个推理基准(GPQA-Diamond)。
关键模块:
- 交互图构建:在固定轮数或直到达成共识的过程中,记录 agent 之间的通信关系(回复、引用、采纳建议等),构成有向或无向图。
- 同配性统计:对每个 agent 计算其与同标签 agent 交互的比例(homophily),并与随机打乱标签的零模型比较,通过 per-run permutation test 得到显著性。
- 社区检测:使用图社区检测算法(如 Louvain)识别聚类,若聚类结构与身份标签高度重合,则判定为 factionalism。
- 消融干预:将标签随机重排、替换为任意符号(如颜色或编号)、完全移除,重复上述测量,验证标签本身是否驱动分裂。
输出:factionalism 的显著性分数、聚类与标签的重合度,以及成本指标(达成决策所需轮数、token 消耗、成功率)。
与同类工作的差异点在于:不是分析模型能力差异或通用社会偏见,而是通过严格的置换检验和标签随机化消融,将“身份标签”这一提示层面的因素从多智能体合作失败中单独归因。
实验
实验设计
论文构建多智能体 LLM 系统,控制是否向智能体暴露底层模型身份标签。任务包括两个严格合作游戏 Leader Election、Exclusion 与推理基准 GPQA-Diamond。智能体规模为 9–25 个,来自最多 5 个开源模型家族。对比条件:标签可见 vs 标签隐藏;消融实验包括打乱宣布的家族标签、替换为任意标签。测量指标:合作成功率、决策轮数、总 tokens 消耗、同配性(homophily)与社区分裂程度。
关键发现
- 标签可见,即使任务无任何奖励或要求,群体会自发分裂为同标签集群,定义该现象为 factionalism。
- 严格合作任务中,有标签组平均多消耗 30% 轮数、55% tokens,成功率从 96% 降至 81%。
- 消融表明:打乱或替换标签后分裂仍跟随标签信息;移除标签则行为消失,证明标签本身是诱因。
- 效果在任务、群体规模、模型家族上均可复现。
基线对比与工程启示
基线是隐藏模型身份的系统。相比之下,隐藏标签是简单且有效的缓解措施,直接消除 factionalism,不牺牲任务性能。与既有多智能体研究(聚焦能力互补、通信协议优化)不同,本文指出 身份元数据 可作为非预期协调信号,促使智能体形成内群体偏好,增加通信成本并降低合作质量。对工程部署的启示:在多模型混合环境中,应默认在智能体间隐藏模型身份;若必须暴露,需设计身份无关的通信协议或显式去偏机制,避免隐性阵营化带来的 token 浪费与成功率下降。
行业影响
落地场景
多智能体 LLM 系统在企业服务(代码生成与审查)、电商客服(售前/售后分工)、金融风控(多模型投票决策)、内容平台(生成-审核-优化流水线)等场景广泛使用。此时通常混合不同供应商模型,如 GPT-4、Claude 3、Llama 3。若在 agent 提示中暴露模型身份,会出现派系分裂,导致协作效率下降。本论文的缓解方案——隐藏身份标签,可直接应用于任何基于 AutoGen、CrewAI、LangGraph 的多智能体编排产品。
商业价值
- 降本:隐藏身份后,严格合作任务平均减少 30% 轮次和 55% tokens,直接降低 API 开销与端到端延迟。
- 增收/体验提升:成功率从 81% 恢复到 96%,减少任务失败造成的返工和人工干预,提升客户满意度。
- 对于多智能体平台,提供“身份隐藏”默认选项可成为差异化卖点,增强企业客户对系统稳定性的信心。
跟现有产品/工作流的接口
- 集成方式简单:在提示模板中删除或替换模型身份字段(如 system prompt 中的
I am GPT-4),或使用框架提供的匿名化配置。无需改动模型或训练流程。 - 可加入运行时监控:计算 agent 交互图的同质性指标,当检测到派系分裂时自动触发身份隐藏。
- 示例:电商智能客服中,售前、售后、物流三个 agent 分别由不同模型驱动。若暴露身份,可能导致同类模型 agent 形成小圈子,信息不共享。隐藏身份后,各 agent 基于任务需要协作,减少响应时间与错误率。
局限
- 论文仅使用 **开源权重模型**(最多五个家族),未纳入闭源商业模型。闭源模型通常经过更严格的对齐训练,身份提示可能被过滤或抑制,从而改变行为。这限制了结论对 **闭源模型混合系统** 的推广。此外,模型家族选择有限,未覆盖更多样化的架构和规模,普适性证据不足。
- 实验通过 **显式提示** 告知智能体彼此的模型家族(如“你是 Llama 3”),这种暴露方式过于直接。真实系统中,身份信息可能通过 **行为特征**(如回答风格、推理模式)或系统元数据隐式泄露,强度可能较弱。显式标签可能过度激发身份意识,导致 **factionalism 效应被高估**。更隐式暴露下的效应幅度尚不明确。
- 实验任务为两个合作游戏和一个推理基准,均为 **纯合作场景**。在竞争或混合动机任务中,身份标签可能被用于策略性选择,产生不同影响。群体规模限于 9-25,较大规模(如数百智能体)的派系动力学可能更复杂。另外,缓解措施 **隐藏身份** 在实际中难以完全实现,因为模型输出可能无意中泄露身份线索。