InfiniHand:从第一视角视频进行流式世界空间手部运动估计
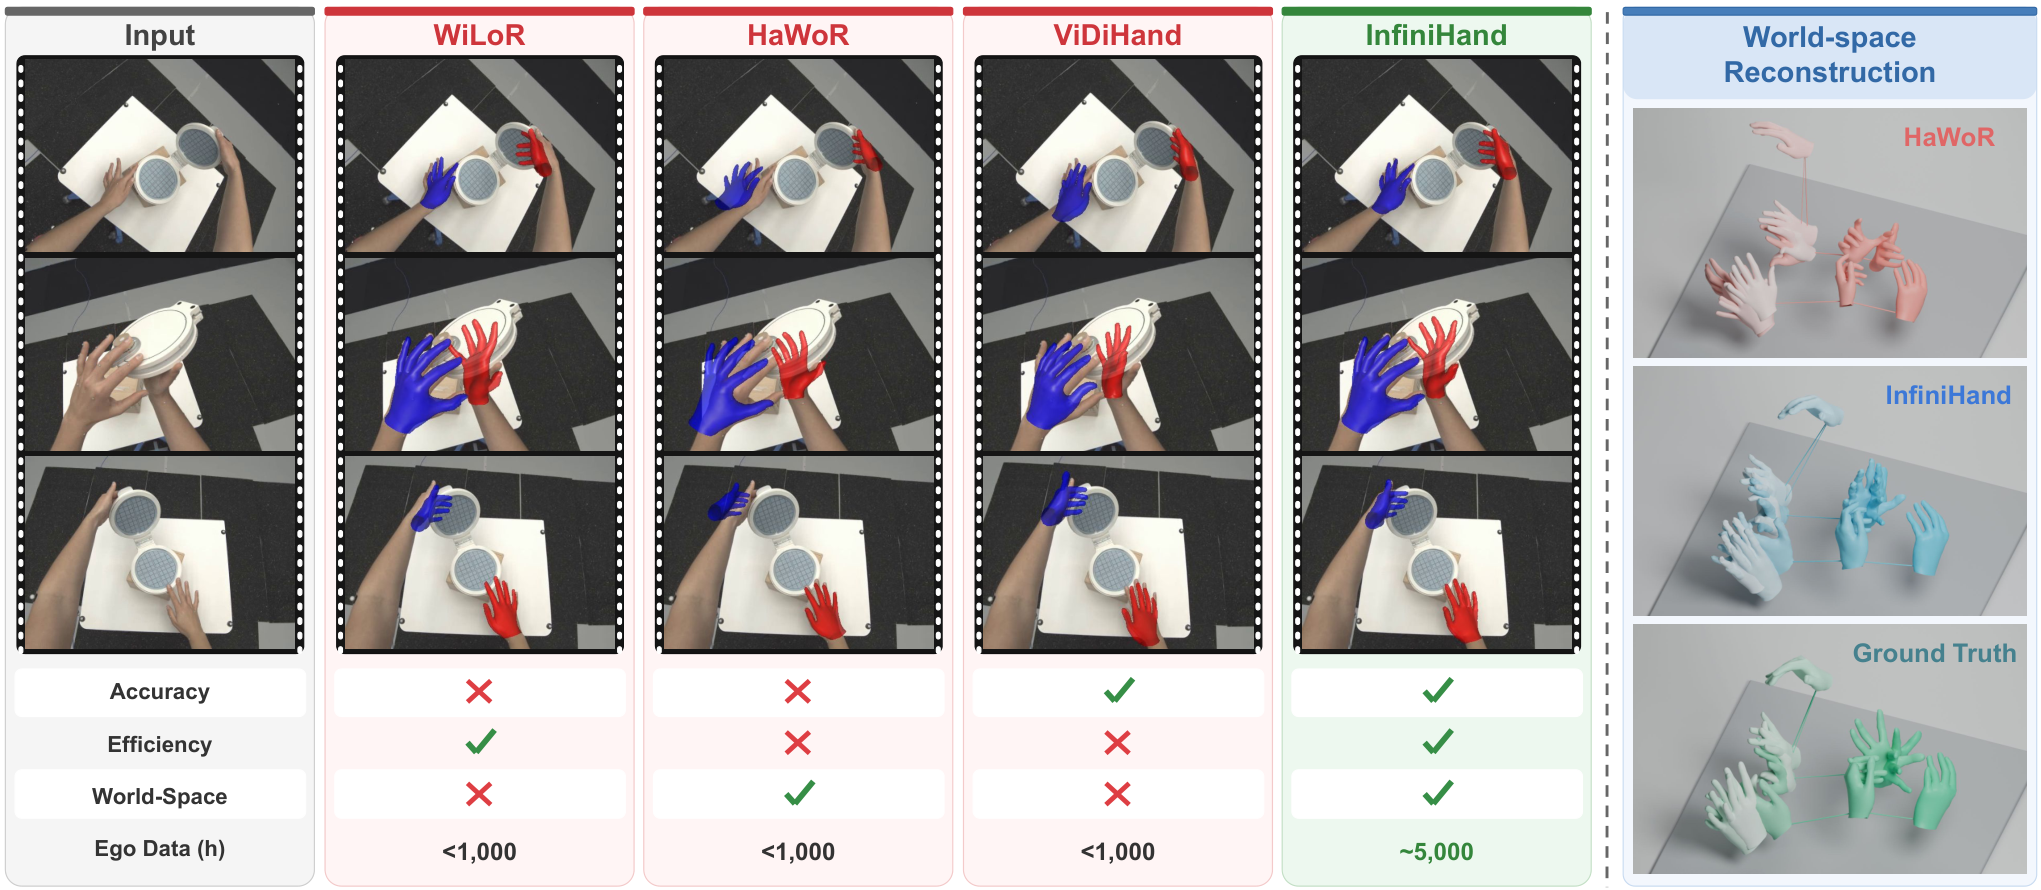
从第一视角(egocentric)视频估计世界空间的手部运动,需要在跟踪相机自运动的同时恢复 3D 关节手部几何。现有方法严重依赖级联的独立手部姿态估计器与 SLAM 系统,导致误差累积、流程复杂以及严重的计算开销。 为此,我们提出 InfiniHand —— 一个端到端的流式前馈框架,可直接从未标定的第一视角视频中联合估计 MANO 参数、相机轨迹与手部位置。它将持久化的时空记忆与以手为中心的视觉特征相结合,在统一架构内显式耦合相机运动与局部手部几何。 训练采用两个渐进阶段:先学习鲁棒的相机空间手部先验,再扩展到流式世界空间重建。为支撑该过程,我们聚合了约 5,000 小时、覆盖多个公开数据集的第一视角预训练语料。 大量评测表明,InfiniHand 在域内基准上优于当前最优基线:相比 ViDiHand,ARCTIC PA-p 降低 21.4%,并显著缓解世界空间漂移。此外,它能鲁棒泛化到野外视频,运行速度达 11.19 FPS,吞吐量超过 HaWoR 的两倍以上。
论文精读
TL;DR InfiniHand 直接从无标定 egocentric 视频流式联合回归 MANO 手部姿态、相机轨迹与手部位置,基于持久时空记忆与手中心特征,端到端消除级联误差,ARCTIC PA-p 降低 21.4%,速度达 11.19 FPS。
问题
问题背景
从 自拍视频 重建 世界坐标系下的手部运动,需要同时恢复手部 MANO 参数与相机 6-DoF 轨迹。该领域正从单帧姿态估计走向长序列流式三维重建。
现有方法局限
主流方案采用 级联式架构:独立的手部姿态估计器(回归 MANO 参数)与 SLAM 系统分别处理,再通过后处理融合。这带来三类明显缺陷:
- 误差累积:手部局部误差与相机全局位姿误差在投影到世界坐标时叠乘,导致轨迹漂移,尤其在长视频中迅速发散。
- 流水线复杂:多个模块独立训练、独立推理,需要复杂的数据对齐、时间同步与标定,工程维护成本高。
- 计算冗余:重复特征提取与多阶段推理使得吞吐受限,例如 HaWoR 仅约 5 FPS,难满足实时交互需求。
为什么这个问题难且重要
手部物体小、关节灵活,在自拍视角下常被遮挡或快速运动;相机同时进行无约束运动,使得手部局部几何与全局轨迹高度耦合,是一个病态的非线性优化问题。业界对轻量级 AR 眼镜、动作捕捉等应用有低延迟、长时稳定的刚需,因此该方向在 CV/机器人交叉领域关注度持续上升。
行业类比
与 自动驾驶中的多目标 3D 跟踪 + SLAM 类似:分模块级联会放大误差,端到端联合优化才能同时提升精度与速度。
核心洞察
- 端到端流式联合估计手部姿态、相机轨迹与手部位置,避免级联方法中的误差累积与系统复杂度。现有方法通常先用手部姿态估计器回归相机空间手部参数,再依赖 SLAM 系统跟踪相机轨迹,两者独立导致误差传播、多阶段调优和高计算开销。InfiniHand 在统一网络内同时输出 MANO 参数、相机位姿和手部位置,从根本上消除模块间不一致性,并支持在线流式推理,这是架构层面的关键差异。
- 通过持久时空记忆与手部中心特征显式耦合相机运动与局部手部几何,显著抑制世界空间漂移。许多方法虽然也进行世界空间重建,但缺乏手部与相机之间的显式交互建模,长序列下漂移累积严重。InfiniHand 以手部为中心聚合特征,并将历史信息融入当前帧估计,使相机轨迹估计与手部运动相互约束,实验显示 ARCTIC PA-p 相对 ViDiHand 降低 21.4%,证明了该机制对长时稳定性的贡献。
方法
输入:无标定的自中心视频流(egocentric video),无需相机内参或预建地图。
关键模块
数据预处理:聚合约 5,000 小时多源自中心数据,统一标注格式,为两阶段训练提供大规模先验。
相机空间手部重建(Camera-Space Hand Reconstruction)
- 手部定位(Hand localization):在每帧中检测手部区域,提取手部中心视觉特征。
- 手部重建(Hand reconstruction):从手部中心特征回归 MANO 参数(姿态、形状)及相机空间下的手部位置;引入持久时空记忆(persistent spatiotemporal memory)建模长序列依赖,提升单帧鲁棒性。
世界空间手部重建(World-Space Hand Reconstruction)
- 联合流式训练:在同一前馈架构中耦合相机轨迹与手部几何,直接输出世界空间位置,避免级联 SLAM 与手部估计器的误差累积。
- 稀疏束调整(Sparse Bundle Adjustment):使用二进制关键帧池(Binary Keyframe Pool)选取关键帧,在线优化相机位姿与手部位置,缓解长序列漂移。
输出:流式的 MANO 参数、相机轨迹、手部世界坐标,推理速度 11.19 FPS。
训练策略:先学习鲁棒的相机空间手部先验,再扩展到世界空间联合重建,两个阶段渐进训练。
与同类方法的差异:InfiniHand 首次在端到端流式框架中同时估计手部运动与相机轨迹,替代了 ViDiHand、HaWoR 等依赖独立手部姿态估计器和 SLAM 的级联方案,显著降低系统复杂度并提升吞吐量。
实验
实验设计
- 训练数据:聚合约 5,000 小时 自中心视频,来自多个公开数据集(具体名称未列出)。
- 训练策略:两阶段——先学习相机空间手部先验,再扩展至流式世界空间重建。
- 基准:与 ViDiHand、HaWoR 等 SOTA 方法对比;评估指标包括 ARCTIC PA-p(世界空间手部关节误差)、FPS 等。
关键发现
- 在域内基准上,InfiniHand 显著优于现有方法:ARCTIC PA-p 相对 ViDiHand 降低 21.4%。
- 世界空间漂移得到实质缓解,表明联合估计手部姿态与相机轨迹能有效抑制误差累积。
- 对 in-the-wild 视频泛化稳健,推理速度达 11.19 FPS,是 HaWoR 的两倍以上。
与基线对比解读
- 传统级联方案(独立手部估计器 + SLAM)存在误差传递与计算开销问题;InfiniHand 的端到端流式前馈架构统一了 MANO 参数、相机轨迹与手部位置 的估计,避免了多阶段误差叠加。
- 性能与效率的同时提升,证明了手中心视觉特征 + 持久时空记忆 的设计对长序列自中心视频的有效性。
行业影响
落地场景
InfiniHand 的端到端流式手部运动估计可应用于第一人称视频的实时手部追踪,典型场景包括:
- AR/VR 交互:在智能眼镜或手机 AR 中,用户无需手柄即可通过裸手与虚拟物体交互,例如捏合、抓取、指向。
- 电商虚拟试戴:用户开启前置摄像头,系统实时估计手部 3D 姿态和位置,将戒指、手表、手链等虚拟商品精准叠加在正确关节上,支持转动和缩放查看。
- 机器人遥操作与示教:操作员佩戴头戴摄像头执行精细装配或手术动作,InfiniHand 记录世界坐标系下的手部轨迹,直接转化为机械臂末端轨迹或动作原语。
- 内容创作与虚拟人驱动:第一人称视频中的手部动作可被提取并映射到虚拟角色,用于 Vlog 特效、游戏直播或虚拟主播的手势驱动。
商业价值
主要价值在于降本与提升实时性:
- 替代传统多相机或惯性手套方案,仅依赖单目第一人称视频,硬件成本大幅下降。
- 端到端联合估计避免了 SLAM 与手部姿态估计独立运行带来的累计误差和复杂后处理,减少开发与维护成本。
- 11.19 FPS 的吞吐量满足多数实时交互需求,相比 HaWoR 提升一倍以上,可直接嵌入消费级设备。
- 世界空间漂移的显著缓解提高了长序列动作记录的可靠性,适用于需要精确轨迹回放或分析的企业场景。
与现有产品/工作流的接口
InfiniHand 输出 MANO 参数、相机轨迹和手部位置,可轻松集成到以下技术栈:
- AR 引擎:作为 Unity/Unreal 插件,替代现有手部追踪模块(如 MediaPipe Hands),提供世界空间锚定,减少开发者在 SLAM 与手部估计之间进行坐标系对齐的工作。
- 视频编辑与特效工具:以流式 API 的形式嵌入剪辑软件或云端视频处理管线,对第一人称素材自动生成手部 3D 轨迹和相机路径,用于添加 3D 贴纸或重新打光。
- 机器人控制框架:与 ROS 等系统对接,将手部位姿转换为末端执行器目标,用于遥操作记录回放或模仿学习数据采集。
具体落地 use case:某电商平台开发 AR 戒指试戴功能,用户用手机前置摄像头对准手部,InfiniHand 实时输出世界空间的手部关节位置和姿态,虚拟戒指精准跟随手指运动,无需预标定或深度传感器,显著提升试戴转化率。另一个场景是远程专家指导系统,专家佩戴 AR 眼镜执行精密维修,其手部动作轨迹被记录并叠加到现场视频中,供学员回放学习,降低培训成本。
局限
- 虽然 **InfiniHand** 在效率上比 **HaWoR** 提升两倍以上,但 11.19 FPS 仍低于常规实时标准(如 25–30 FPS),可能限制需要即时反馈的交互应用。此外,论文未明确报告所用 GPU 型号及内存占用,实际部署于边缘设备或移动端时可能面临额外瓶颈。端到端架构虽然简化了流程,但单一前馈网络可能对计算资源要求较高,难以直接在低功耗硬件上运行。
- 尽管联合训练和稀疏束调整(**Sparse Bundle Adjustment**)显著缓解了世界空间漂移,但长视频流式估计中仍可能存在累积误差,特别是在相机快速旋转或场景纹理稀疏时。论文主要评估了 **ARCTIC** 等受控基准,而对完全无约束的 in-the-wild 视频,其长期一致性尚未得到充分验证。此外,统一架构将相机轨迹与手部姿势耦合,一旦某一模块出现错误,可能相互影响,导致误差传播。
- **InfiniHand** 聚焦于单手运动估计,未涉及双手交互或手-物交互的复杂场景,而 **ARCTIC** 等数据集包含双手操作任务,该方法可能简化了问题。此外,模型依赖 **MANO** 参数化,对手部外观变化(如戴手套、遮挡严重)的鲁棒性未知。预训练语料虽达 5000 小时,但主要来自公开数据集,覆盖场景可能有限,对于极端视角或光照条件的泛化能力有待进一步检验。