GeoVerse: 几何隐空间中的世界一致性新视角合成
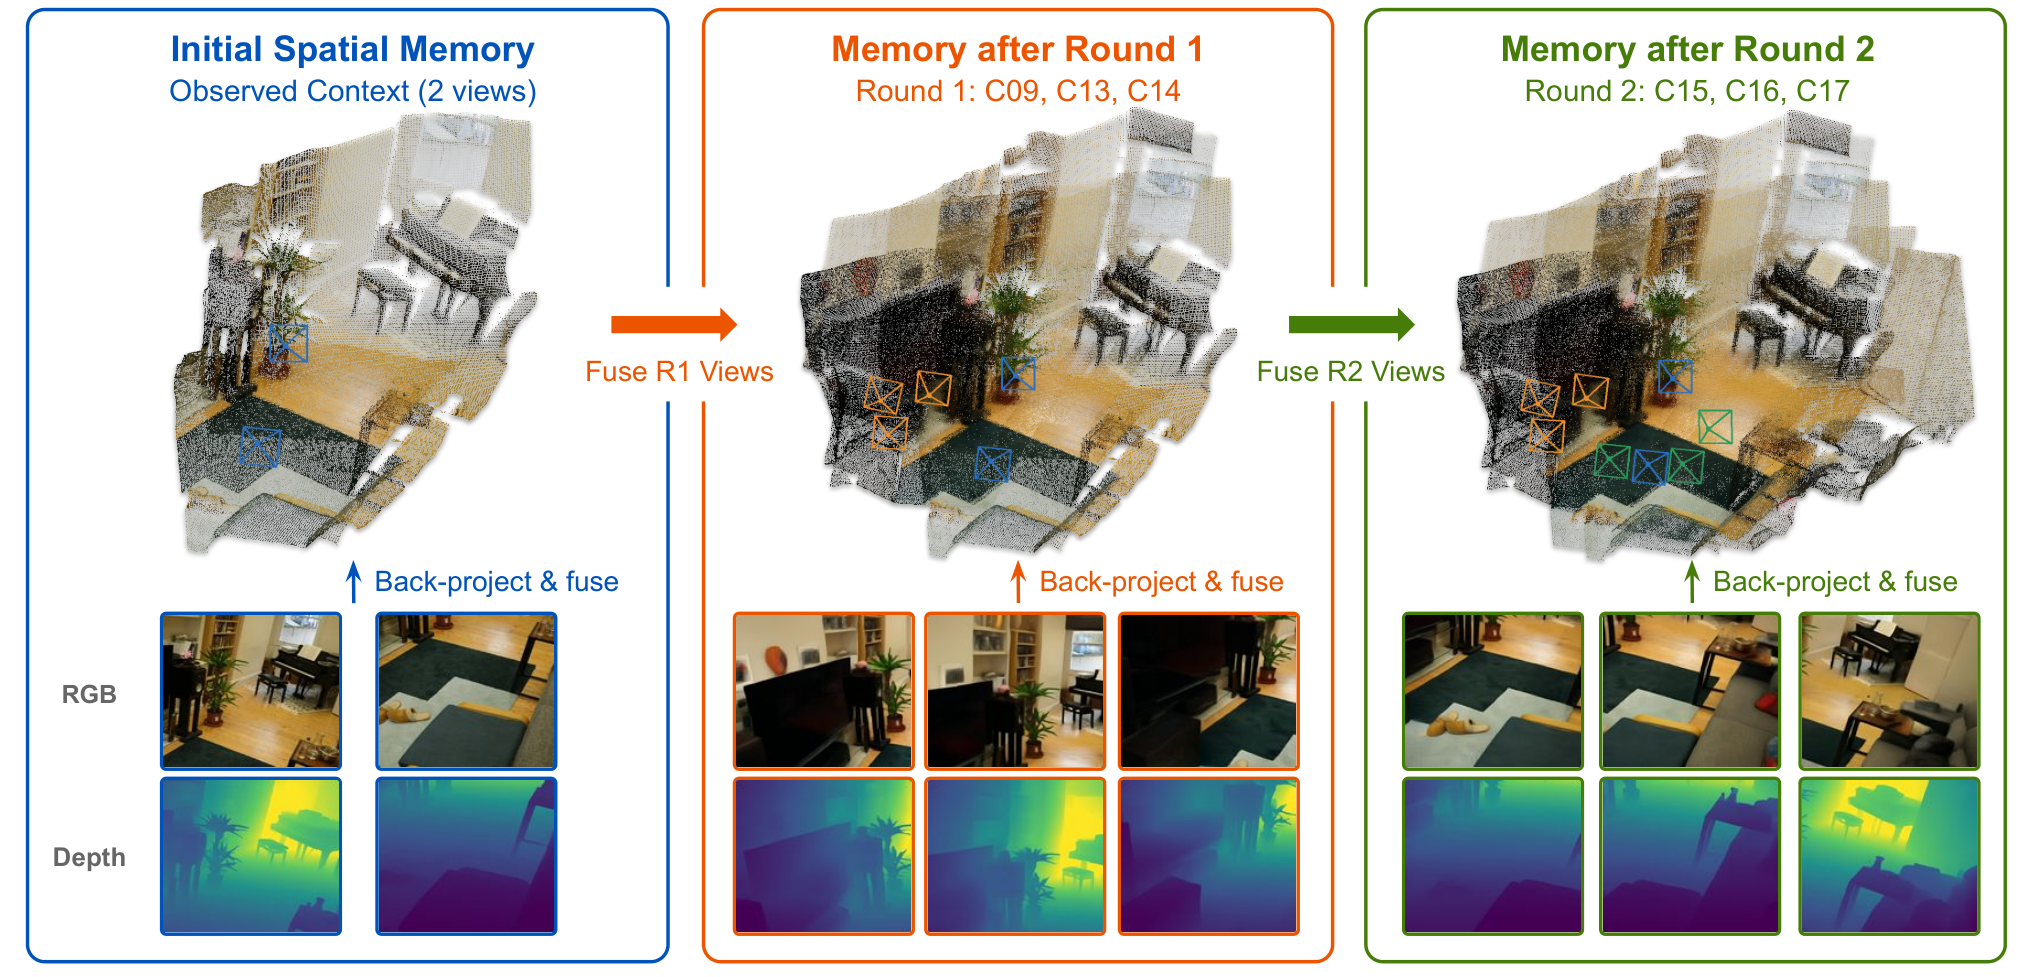
从稀疏图像进行新视角合成,必须同时兼顾对已观测区域的高保真重建与对未见内容的合理补全,并在不同视角间保持世界一致性。现有方法各有取舍: - 基于几何的方法 能保持已观测场景结构,但难以补全未见区域; - 视频生成模型 提供了丰富的外观先验,但在逐帧顺序生成过程中会累积不一致性。 我们提出 GeoVerse,一个在预训练 3D 基础模型 的几何隐空间中执行生成的新视角合成框架,并注入来自视频生成模型的外观先验。具体而言,GeoVerse 从 Wan2.2 VACE 提取多层级特征,通过 ControlNet 风格的适配器注入几何隐扩散模型,借助视频学习到的外观先验增强结构补全能力。为实现跨视角一致性,我们引入 全局空间记忆,持续聚合已观测与已合成内容,并把与目标视角对齐的引导重投影回来,使后续预测锚定在共享的场景表示上。 在多个数据集上的大量实验表明,GeoVerse 提升了视觉质量与几何一致性:相比 GLD,在 DL3DV 上 PSNR 提升 2.23 dB,在 Mip-NeRF360 上 ATE 降低 32.4%。
论文精读
TL;DR GeoVerse 将视频生成先验注入几何潜扩散模型,并用全局空间记忆实现跨视角一致的新视角合成,在 DL3DV 上 PSNR 提升 2.23 dB、Mip-NeRF360 上 ATE 降低 32.4%。
问题
问题背景
新视角合成(NVS)的核心目标是从稀疏观测生成任意视角图像,同时保持观测区域保真与未观测区域合理补全。当前研究焦点从重建质量转向世界一致性——生成结果需在跨视角下保持一致场景结构与外观。
现有方法局限
- 几何扩散模型如 GLD 在预训练 3D 基础模型的几何潜在空间中生成,能较好保留观测结构,但缺乏丰富外观先验,导致大范围缺失区域补全出现纹理模糊或几何畸变。
- 视频生成模型(如 Wan2.2 VACE)提供强外观先验,但逐视角生成时无全局约束,误差随序列累积,造成相机轨迹漂移和跨视角不一致。
为什么难且重要
技术难点在于融合两种异质先验:将视频先验注入几何潜在扩散的同时不破坏几何一致性,并设计持久空间记忆机制聚合已生成内容,避免误差累积。该问题直接影响 3D 资产生成、具身智能、空间计算等领域的落地效率,业内对可扩展、长序列一致的 NVS 需求迫切。
行业类比
类似自动驾驶仿真中,从稀疏相机输入生成环视一致的道路场景,任何局部补全瑕疵都会导致拼接接缝或物理矛盾。
核心洞察
- 在 geometric latent space 中进行生成,而非直接在图像空间或通用潜空间扩散,使生成过程天然具有几何一致性约束。GeoVerse 将生成锚定在预训练 3D foundation model 的几何潜空间,再注入视频生成模型的外观先验,而 GLD 等基线未能同时利用这两种先验,导致结构补全与外观生成割裂。这种设计让未观测区域的补全既符合场景几何,又具备真实外观,是解决稀疏视图 NVS 中重建与生成矛盾的有效路径。
- 全局 spatial memory 通过持续聚合已观测与已合成内容,并将目标视角对齐的指导重投影回共享场景表示,有效抑制了序列生成中的累积误差。与逐视图独立生成或自回归视频模型不同,GeoVerse 让每个新视角的预测都锚定到同一个全局记忆,从而在长序列新视角合成中保持世界一致性。实验显示 **ATE** 指标比 GLD 降低 **32.4%**,验证了该机制对几何一致性的关键作用。
方法
GeoVerse 接受一组稀疏视角图像作为输入,目标是在任意新视角下合成视觉可信且几何一致的结果。核心思路是在预训练 3D 基础模型的几何潜在空间中执行扩散生成,而非直接回归像素或依赖顺序视频生成。
- 视频先验注入:从 Wan2.2 VACE 提取多尺度特征,通过 ControlNet-style adapter 注入几何潜在扩散模型,补充外观先验以改善未见区域的结构补全。
- 持久空间记忆:维护全局 3D 空间记忆,持续聚合已观测与已合成的内容;对每个新视角,将目标对齐的引导信息重投影到共享场景表征,用于锚定后续预测,从而保证跨视角一致性。
- 少步推理:通过 Reflow 蒸馏 将扩散采样压缩至少数步骤,提高推理效率。
训练使用两级流匹配损失,结合 RGB 监督与尺度对齐深度监督。输出为世界一致的新视角图像序列。
与同类方法相比,GeoVerse 将视频生成先验引入几何潜在空间,并用全局空间记忆替代逐步累积的条件传递,避免了顺序生成中的漂移。
实验
实验设计
在 DL3DV 与 Mip-NeRF360 数据集上进行稀疏输入的新视角合成评估,对比重建式与生成式基线,重点考察视觉质量(PSNR)与几何一致性(ATE)。同时验证 Few-Step 推理 的效率与质量权衡。
关键发现
- GeoVerse 在 DL3DV 上取得 PSNR +2.23 dB(相对 GLD),表明重建保真度显著提升。
- 在 Mip-NeRF360 上 ATE 降低 32.4%,说明跨视角位姿漂移大幅减少,场景世界坐标一致性更好。
- 定性结果显示生成区域更连贯,未见区域补全更符合场景结构,减少了漂浮伪影。
与基线对比解读
GLD 作为纯几何潜变量扩散方法,缺乏场景级外观先验,在稀疏输入下易在未见区域产生纹理模糊或几何错误。GeoVerse 通过注入 Wan2.2 VACE 的视频先验提升生成逼真度,并利用 全局空间记忆 持续聚合已观测与已生成内容,缓解了顺序生成中的误差累积。Reflow Distillation 进一步减少推理步数,为实际部署提供效率保障。整体表明,将视频先验与几何潜空间结合是平衡重建保真与生成补全的有效路径。
行业影响
落地场景
GeoVerse 适用于需要从稀疏图像生成多视角一致画面的业务:
- 电商 3D 商品展示:仅用几张商品照片即可合成任意视角,支持 AR 预览、细节放大,降低建模门槛。
- 内容平台 / 虚拟制作:影视预演、虚拟直播、短剧场景搭建中,从少量实拍图快速扩展可探索的 3D 环境。
- 自动驾驶仿真:由真实街景稀疏照片生成覆盖新视角的合成数据,用于感知模型训练与 corner case 补全。
- 游戏 / 数字孪生:快速生成可交互的场景漫游视图,减少手工建模与贴图成本。
商业价值
- 降本:传统多视角采集或人工 3D 建模周期长、成本高;GeoVerse 仅需少量输入即可获得一致的新视图,显著缩短资产生产时间。
- 体验提升:相比纯几何方法或视频生成方法,GeoVerse 在 PSNR 提升 2.23 dB、ATE 降低 32.4%,提供更稳定、无跳变的新视图,改善 AR/VR 沉浸感与用户停留时长。
- 增收:电商多角度展示可提高转化率;内容平台的高质量相机轨迹生成能增强互动与付费意愿。
跟现有产品 / 工作流的接口
GeoVerse 可作为 渲染后端模块 集成到现有 3D 生成或重建管线:
- 与 NeRF / 3DGS 重建流程结合,负责 unseen view 的生成与补全,输出可被现有渲染引擎消费。
- 通过 ControlNet 风格适配器 复用 Wan2.2 VACE 视频先验,无需更换底层 diffusion 架构,便于嵌入已有视频生成服务。
- 支持 few-step inference(reflow distillation),可部署为 API:输入稀疏图像与目标相机位姿,输出一致新视图,适配云渲染或边缘推理。
典型 use case:电商平台将 GeoVerse 作为“3D 视图生成器”插件,商家上传 4-6 张商品图,自动产出 360° 展示链接;自动驾驶数据团队用其从历史路采照片合成新视角,扩充训练集。
局限
- **依赖多个大型预训练模型** 与 **多阶段训练流程**,包括 3D foundation model、Wan2.2 VACE 以及 ControlNet-style adapter,部署门槛较高。整体性能受限于底层模型的泛化边界,对动态场景、非朗伯材质、极端光照等分布外数据可能失效。虽然通过 reflow distillation 实现少步推理,但训练阶段仍需大量计算资源与多模型协同,实际落地的推理成本仍高于纯几何方法。
- **全局空间记忆机制** 通过 reprojection 聚合观测与合成内容,但随着生成序列延长,累计误差、遮挡/去遮挡处理以及远距离视角的几何不确定性会导致漂移,长序列一致性尚未完全解决。实验仅在 **DL3DV** 与 **Mip-NeRF360** 上验证,输入视图稀疏程度和场景多样性有限,对于大范围室内外混合场景、复杂反射表面等未充分评估,与 **GLD** 的对比也缺少更多基线方法(如近期生成式 NVS 方法)的横向比较。