统一模型中基于交错强化学习的学习原生反思
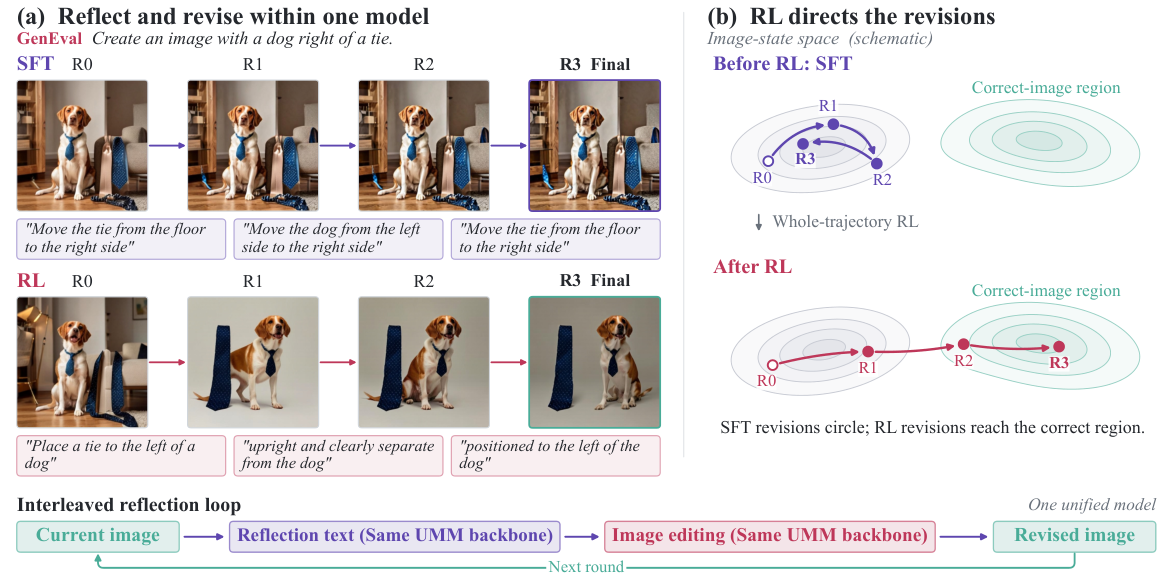
统一多模态模型 同时具备看图与生成图像的能力,原则上可以自我修复生成结果:诊断图像问题、修改、观察结果、再次诊断。但一次修改是否有帮助,只有渲染之后才能知道,因此 反思文本 与 图像生成 必须在整个循环中联合学习。 监督微调(SFT)在反思轨迹上能提供冷启动,却找不到高成功率的修复路径;而只优化渲染器或单个 head 的朴素 RL,则让大部分收益流失。 我们提出 UMM-Reflection,在一个统一模型内部对完整反思轨迹施加强化学习: - 兄弟轨迹共享同一张初始图像,组相对优势 因而能直接比较不同反思策略; - 一条轨迹级优势同时更新反思 token 与基于 flow 的修订,避免逐轮信用分配的组合爆炸; - 与单轮编辑或带外部 critic 的流水线不同,信用跨轮流动并覆盖同一模型的两个角色,推理时也无需 verifier。 在 BAGEL 上,UMM-Reflection 相比 SFT 将 GenEval 提升 12.05 分,且增益可迁移到 WISE(+10.97)、OneIG-Bench(+3.48)与 T2I-CompBench++(+4.63),这些基准均未用于训练。
论文精读
TL;DR UMM-Reflection 让同一多模态模型边生成反思文本边修改图像,并对完整反思-修订循环做交错强化学习,无需外部验证器,在 GenEval 上提升 12.05 分且跨基准泛化。
问题
问题背景
统一多模态模型同时具备图像理解与图像生成能力,因此天然适合执行自我反思修复:生成图像 → 诊断缺陷 → 修订指令 → 再次生成 → 循环迭代。这一方向正成为文本到图像生成的研究热点。
现有方法局限
- 监督微调(SFT) 在人工采样的反思轨迹上训练,只能提供冷启动,容易使模型模仿平均或短视的修复策略,无法发现高成功率的修复路径。
- 朴素强化学习(RL) 通常只优化渲染器或只优化单一头部,忽略了反思文本与图像生成之间的耦合;由于同一模型承担两个角色,单头优化会造成梯度信号冲突,留下大部分潜在收益。
- 外部 critic 管线虽然可提供过程奖励,但推理时需要额外验证器,增加延迟与资源消耗。
为什么这个问题难且重要
反思文本与图像生成必须联合学习,因为修复是否有效只有在渲染后才能判断;如果分开训练,反思头输出的建议可能与生成器的实际行为脱节。同时,多轮修复的信用分配面临组合爆炸:若逐轮计算优势,会引入巨大方差;若忽略轮次结构,则无法识别关键修复步骤。本文提出的整条轨迹强化学习 + 共享根采样 + 组相对优势 提供了一种简洁的解决方案,对多模态自纠正、测试时缩放以及统一模型架构设计都有工程参考价值。
行业类比
类似具身智能中的“感知-规划-执行”闭环:视觉语言模型观察环境、规划动作、执行后再次观察,需要联合优化决策链而非孤立模块。
核心洞察
- 将反思循环建模为完整轨迹进行强化学习,用共享根采样与 group-relative advantage 替代逐轮信用分配。与 SFT 冷启动只能模仿已有轨迹不同,RL 能发现高成功率的修复路径;与只优化渲染器或单独优化一个头的朴素 RL 相比,本方法同时更新反思 token 和基于 flow 的修订,既避免了组合爆炸,又让信用跨轮流动,充分释放统一模型双重角色的潜能。在 BAGEL 上 GenEval 提升 12.05 点,且迁移到多个未见基准。
- 在统一模型内联合优化反思文本与图像修订,而非依赖外部 critic 或单轮编辑。修订是否有益只有在渲染后才能确定,因此反思策略与生成策略必须联合学习。单轮编辑或外部批判者无法捕捉多轮反射中的累积修复与动态交互。本方法让同一模型同时承担诊断与渲染两种角色,推理时无需额外 verifier,实现了原生自我修复能力,在迁移基准上平均提升超过 4 点。
方法
输入:统一多模态模型(支持文本诊断与图像生成/编辑)接收初始生成图像,并按照固定的 反射协议 在单一序列中交替产出诊断文本、修订指令和修订后的图像,直到模型输出 DONE 结束标记。
关键模块
- 反射轨迹构建:从初始图像的多个候选生成中采样,构造多轮轨迹,每轮包含“诊断当前图像问题 → 生成修订指令(flow-based 编辑)→ 渲染新图像”的完整记录。轨迹末尾以
DONE表示停止。 - 有监督初始化:先在收集到的轨迹数据上进行 SFT,为模型提供冷启动,使其初步掌握反思和修订的格式与基本行为。
- 整体轨迹强化学习:核心采用 共享根采样,对同一初始图像采样多条不同策略的轨迹,构成一组 sibling trajectories。计算 组相对优势:将组内各轨迹的最终奖励(如修复后图像与真实 caption 的一致性)减去组均值,以此比较反思策略的相对好坏,而非绝对奖励。然后,用一个轨迹级别的优势信号同时更新轨迹上的所有 反思 tokens 和 流式修订 参数,避免逐轮信用分配的指数级组合爆炸。奖励设计包含多改进项,并惩罚错误的
DONE。 - 文本–流协调:通过共享同一梯度信号,保证文本反思与图像修订两个角色同步优化。
输出:一个在推理时无需外部验证器即可自主进行多轮修复的统一模型。
与单轮编辑或外部 critic 流水线不同,本方法将信用分配贯穿整个反射循环,同时优化同一模型的诊断与生成角色,且推理时无需额外验证器。
实验
实验设计
方法在 BAGEL 数据集上训练,采用 SFT 冷启动随后应用 RL 优化完整反思轨迹。评估在 GenEval、WISE、OneIG-Bench、T2I-CompBench++ 四个基准上进行,均未参与训练。对比基线包括 SFT、单轮编辑、外部验证器 pipeline 以及仅优化渲染器的 naive RL。
关键发现
- UMM-Reflection 在 GenEval 上比 SFT 提升 12.05 点;该增益迁移至 WISE (+10.97)、OneIG-Bench (+3.48)、T2I-CompBench++ (+4.63)。
- 消融实验表明,反思文本头和图像生成头必须联合训练,单头训练效果显著下降;RL 收益并非来自 best-of-N 采样或额外编辑次数,而是轨迹级信用分配和跨轮次协调。
与基线对比解读
SFT 只能提供冷启动但无法探索高成功率修复路径;RL 通过 group-relative advantage 比较同初始图像下的兄弟轨迹,并以 trajectory-level advantage 同时更新两个头,避免逐轮信用分配的指数爆炸。推理时无需外部验证器,模型自身完成诊断-修改-观察循环,展现出原生反思能力。
行业影响
落地场景
UMM-Reflection 可嵌入统一多模态生成服务,用于需要多次修正才能达标的视觉内容生产。典型场景:电商平台批量生成商品主图,模型根据文本描述生成初稿,自动诊断“主体缺失/构图错误”并迭代修复,直至达标;内容平台为文章自动配图,根据标题与正文反思图像相关性,减少人工选图;设计工具中用于 logo/海报的草稿优化。
商业价值
主要降本与提效:在 GenEval 上 +12.05 点,意味着同 prompt 下一次性生成合格率显著提升,减少人工重绘与审核成本。推理时无需外部 verifier,省去额外模型调用与延迟;训练仅需 500 updates 左右即可获得大部分收益,RL 微调成本可控。对体验而言,输出更符合用户意图,降低返工率。
与现有工作流的集成
可替换现有“生成器 + 外部判别器 + 重生成” pipeline 为单一模型内闭环。通过 SFT 冷启动 + 组相对优势 RL 微调,可基于已有 unified multimodal backbone 训练。部署时以标准自回归/流式接口暴露,模型内部完成反思-修正,无需额外 critic 服务。企业可将该模型作为即插即用的图像生成微服务,接入电商 CMS 或设计平台 API。
局限
- 虽然迁移到多个外部基准有提升,但训练仅使用 BAGEL 数据集,该数据集可能侧重特定类型的生成错误(如文本渲染、属性绑定等),导致模型在更广泛或不同风格的图像生成任务上的鲁棒性尚不明确。此外,训练域与迁移域之间的分布差异可能被部分掩盖,因为外部基准与 BAGEL 可能存在共享的底层特征,实际部署时仍可能遇到未覆盖的错误模式。
- 该方法的计算开销较大:强化学习阶段要求对每个初始图像采样多个兄弟轨迹(以实现组相对优势),并且每个轨迹包含多轮反思、文本生成和图像渲染,相比标准 SFT 或单步优化显著增加了 GPU 时间和显存消耗。虽然论文报告 500 步内大部分增益已获得,但初始训练成本仍然较高,可能限制资源有限的团队复现或扩展到更大模型。
- 方法有效性依赖于模型架构中文本和图像生成头的可联合优化,以及基于流的图像生成接口。对于非流式或文本与图像生成模块耦合较弱的统一多模态模型,直接应用该 RL 框架可能困难。另外,奖励函数虽然没有使用外部验证器,但依然需要某种自动评估(如 CLIP 分数或专有评估器)来计算优势,这些评估器自身的偏差可能影响学习目标的准确性。