LongCat-DeepResearch 技术报告
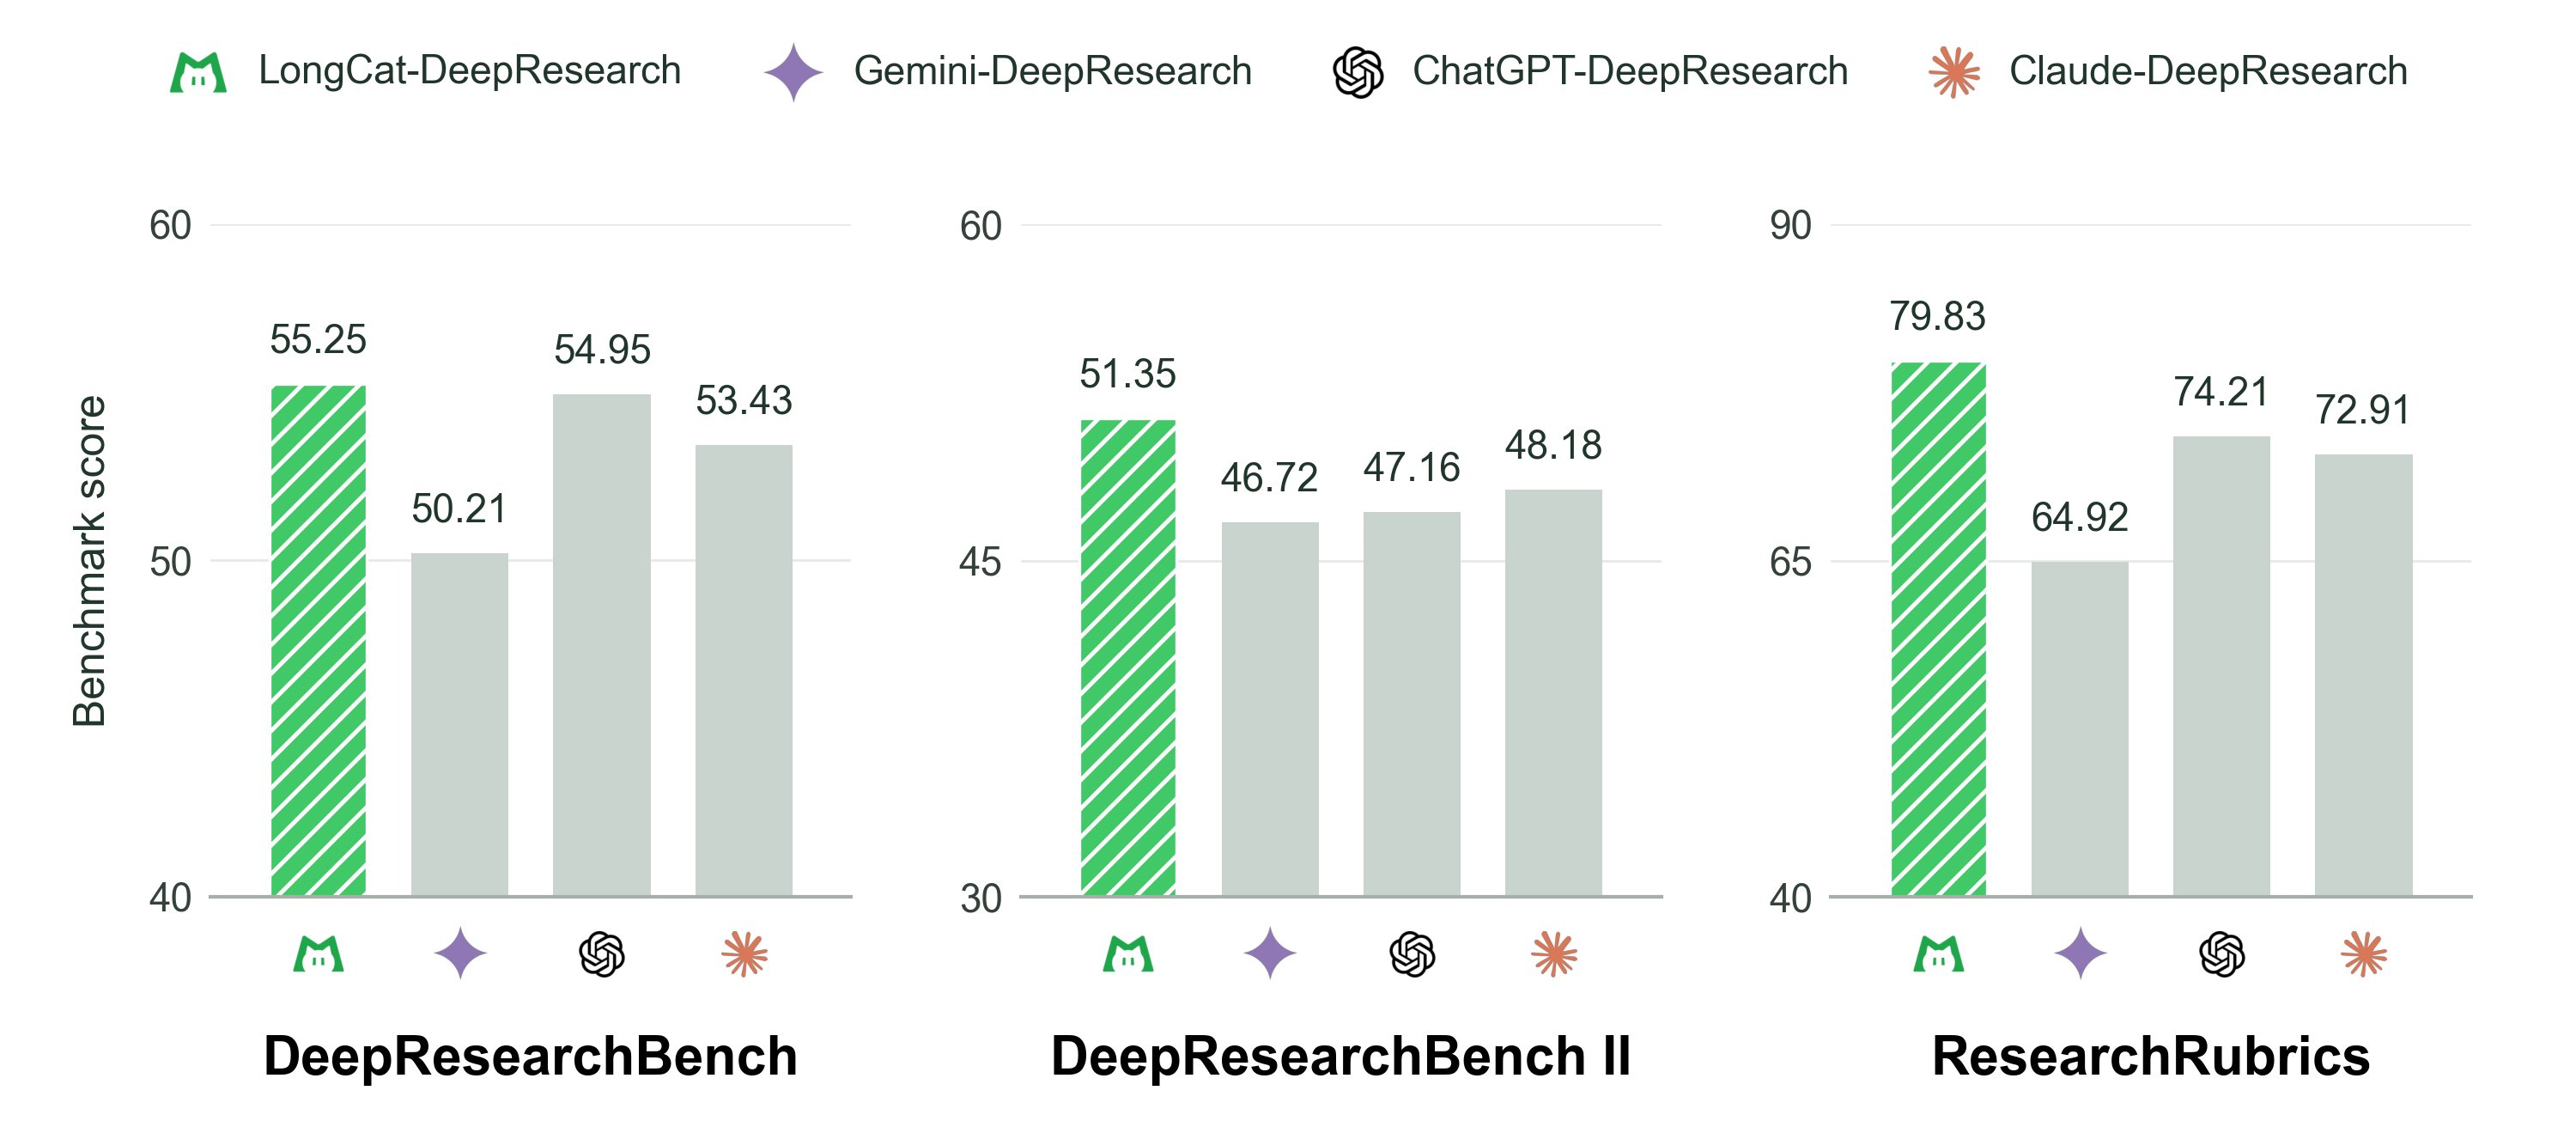
我们提出 LongCat-DeepResearch,一个深度研究系统,将增强的 LongCat 模型与多智能体工作流结合,用于生成全面且基于证据的报告。该工作流将全局规划与细节调研分离,并在章节层面协调修订。 方法层面:多个规划智能体先探索外部来源,细化出可执行的研究计划,称为 ResearchSpec;随后研究智能体并行调研并撰写各自负责的章节,在分析推进过程中于独立上下文中持续收集额外证据。章节汇总后,由全局审阅指导有针对性的局部修订,减少对整篇报告反复重写的依赖。该工作流还支持为 LongCat 通用模型的中期训练与后期训练构造研究任务与轨迹。 实验结果:LongCat-DeepResearch 在 DeepResearchBench 上取得 55.25,在 DeepResearchBench II 上取得 51.35,在 ResearchRubrics 上取得 79.83;在内部基准上得分 76.04,在四个对比系统中排名第二。 分析结论:开发集分析显示,融合多种规划视角带来收益,而进一步细化规划的效果则好坏参半;额外的编辑在两个基准上提升了平均自动可读性偏好,但各自趋势不同。
论文精读
TL;DR LongCat-DeepResearch 将全局规划、并行调研与章节级修订解耦,结合多代理工作流,在多项深度研究基准上取得领先,并通过数据构造反哺模型训练。
问题
问题背景
当前 AI 行业正从单轮问答转向能自动完成检索、规划、多步推理和长文合成的 Deep Research 系统。
现有方法局限
- 单一上下文与全量重写:许多现有 agent 在单个长上下文中完成规划、调研、撰写,局部修改往往触发全文重新生成,token 开销高且容易破坏已有内容。
- 规划与调查耦合:缺少独立的、可执行的研究计划,agent 容易在搜集证据时偏离原始问题,无法有效并行和复用。
- 证据管理薄弱:并行调研时各 section 的证据分散在不同上下文中,缺乏全局协调与交叉引用,导致报告一致性差。
为什么这个问题难/重要
- 上下文与证据保真:长报告需要多源引用,上下文窗口有限,如何在不丢失关键证据的前提下扩展任务规模是核心挑战。
- 多 agent 协调:全局评审与局部修订需要解耦,若每次修改都重写全文,成本随报告长度线性甚至超线性增长。
- 评估体系残缺:自动评估 deep research 的基准(如 DeepResearchBench / ResearchRubrics)仍不成熟,难以客观比较系统能力。
行业类比
类似代码智能体将任务分解为规划、编码、测试、修复的 pipeline,deep research 也需要“研究版”的 plan-and-execute 架构,以结构化计划驱动长文生成与迭代修订。
核心洞察
- LongCat-DeepResearch 的核心设计是将全局规划与局部研究彻底解耦,先通过多个规划 Agent 探索外部资料形成 ResearchSpec,再并行执行各节的研究与写作,最后仅对组装后的报告做局部修订。这种“先组装后编辑”的方式不同于许多端到端长文生成系统反复重写全文的做法,能显著降低上下文丢失和计算浪费,同时保留跨节证据协调能力,为多智能体研究报告系统提供了更可维护的工程范式。
- 该系统不仅是推理时的多智能体工作流,还通过解耦的接口采集“任务-轨迹”数据,用于 LongCat 通用模型的中训练与后训练。研究过程本身变成训练数据来源,形成从系统运行到模型能力提升的闭环。与只关注推理侧编排的同类系统相比,这种数据构建视角使模型能吸收研究规划、证据检索、章节写作等环节的模式,有望缓解通用模型在深度研究任务上的分布偏移。
方法
输入与总体流程
系统输入为开放式研究问题,输出为结构化的综合报告。工作流分为三个解耦阶段:全局规划 → 并行章节研究 → 组装与章节级编辑。
关键模块
- 研究计划生成与细化:多个规划智能体先探索外部来源,将问题拆解为可操作的研究计划
ResearchSpec,包含章节分配、证据来源、搜索关键词等。规划视角的多样性来自不同智能体独立探索后的融合。 - 并行研究代理:每个研究智能体负责一个章节,在独立的上下文中进行调查、收集证据并撰写草稿。随着分析深入,可自主发起额外搜索,避免不同章节之间的上下文污染。
- 组装与协调编辑:所有章节草稿组装成完整报告后,全局审阅器识别跨章节的不一致、证据缺口或逻辑断裂,指导对特定章节进行局部修订。该方法避免了反复重写全文,降低长报告迭代成本。
- 数据构建与训练支持:基于源材料生成问题与评分标准,检查证据可搜索性和任务质量,筛选分阶段轨迹用于 LongCat 模型的中期训练和后训练。
与同类方法的差异点
不同于常见的端到端生成或整体重写式深度研究系统,LongCat-DeepResearch 将全局规划与章节级执行彻底分离,并在组装后只做局部协调编辑,显著减少长报告场景下的计算与改写开销。
实验
实验设计
系统在 DeepResearchBench、DeepResearchBench II、ResearchRubrics 与内部基准上评估报告质量,重点考察证据支撑与可读性。内部基准包含四套对比系统,采用统一评分协议。开发集消融覆盖规划视角组合、ResearchSpec 细化程度与编辑器扩展配置,用于分离各模块贡献。
关键发现
- DeepResearchBench 得分
55.25,DeepResearchBench II 得分51.35,ResearchRubrics 得分79.83。 - 内部基准得分
76.04,在四套对比系统中排名第二。 - 组合多个规划视角带来明确收益;进一步细化
ResearchSpec的效果混合,并非单调提升。 - 额外编辑提高两个基准上的平均自动可读性偏好,但各基准趋势不一致。
与基线对比的深度解读
内部基准排名第二说明方法已接近头部系统,但与第一名仍有差距。分段并行调查配合全局评审局部修订,显著降低全文重写成本,更适合工程化落地。编辑步骤对可读性总体正向,但不同基准趋势不同,提示需要依据报告类型动态决定编辑深度,不能默认全局套用同一策略。
行业影响
落地场景
LongCat-DeepResearch 的核心能力是生成证据扎实、可追溯的长篇研究报告,适用于需要深度信息整合与决策支持的产品场景:
- 企业知识库与竞争情报:自动追踪行业动态、竞品发布、技术趋势,输出结构化调研报告,替代人工初级分析。
- 金融投研与尽调:从财报、新闻、公告、第三方数据中交叉验证,生成公司或行业深度报告,支撑投资决策。
- 教育与科研辅助:为课程项目、文献综述、政策分析提供多源证据整理与引用标注,降低信息收集成本。
- 内容平台的长文生成:针对热点话题或知识类栏目,自动生成带引用来源的深度解读文章。
商业价值
- 降本:将资深分析师数小时至数天的资料搜集、交叉验证、初稿撰写压缩到分钟级,显著降低人力成本。
- 增收:通过 API 或 SaaS 形式提供深度研究报告服务,可成为企业订阅制的增值模块;在投研、咨询等高价值场景可按报告收费。
- 体验提升:报告附有证据链接与可追溯引用,减少幻觉带来的信任风险;多轮局部修订替代全文重写,缩短用户等待时间,适合交互式研究助手场景。
与现有产品/工作流的接口
LongCat-DeepResearch 以 多智能体工作流 形式封装,接口边界清晰:
- 输入:用户问题 + 可选初始资料;输出:
ResearchSpec计划、分节草稿、编辑后报告及引用轨迹。 - 可通过 REST API 集成到企业级知识管理平台、BI 工具或客服系统;
ResearchSpec可作为可审计的中间产物,便于人工复核。 - 训练数据构造接口支持从自身运行轨迹中筛选高质量样本,用于持续微调基础模型,适合有自研模型团队的企业。
具体落地用例
- 电商平台的选品与市场分析:运营人员输入“2026 年户外储能电源的消费者关注点与竞争格局”,系统自动搜索电商评论、社媒、竞品页面,生成含市场细分、价格带、卖点趋势的报告,直接指导选品和广告投放。
- 企业服务中的销售赋能:销售在接触大客户前,系统自动生成客户行业、财报、近期新闻、组织变动的尽调摘要,并附来源链接,帮助销售快速建立上下文,缩短准备时间,提高赢单率。
局限
- **规划与编辑的收益不稳定**:开发集分析显示,结合多个规划视角有正面效果,但进一步对 `ResearchSpec` 细化存在“混合效果”;额外编辑在 DeepResearchBench 和 ResearchRubrics 上的自动可读性偏好提升幅度不一,甚至趋势相反。这表明当前工作流中的一些超参数(如细化轮数、编辑强度)缺乏通用性,需要针对不同基准或任务进行调优,限制了开箱即用的稳健性。自动指标无法完全捕捉报告的事实一致性和论证深度,需要人工评估进一步验证。
- **评估与泛化性有限**:报告仅在三个公开基准和一个内部基准上验证,其中内部基准排名第二,说明系统并非全面领先。所有结果均来自自动评分,缺乏大规模人工评估,自动指标可能偏向某些风格而非内容正确性。此外,虽然提供了 GitHub 仓库和项目页,但训练数据构建、模型增强细节和评测协议部分内容较简略,复现完整系统有难度。跨领域、跨语言的泛化能力未讨论,实际部署效果待观察。
- **缺乏与最强基线的直接对比**:论文只与四个系统比较(自家基准),未与当前主流商业或开源 deep research 系统(如 OpenAI Deep Research、Perplexity 等)在相同设置下对比,因此难以判断相对位置。同时,没有报告生成延迟、token 消耗或硬件成本,对于实际工程落地,这些指标与质量同等重要。多智能体并行调查虽然提升效率,但独立章节上下文可能牺牲跨章节证据一致性(案例研究中也提到 cross-section coordination 仍有限),这是架构层面的内在限制。