Mara Chain: 将失败重新视为 AI 系统自进化的垫脚石
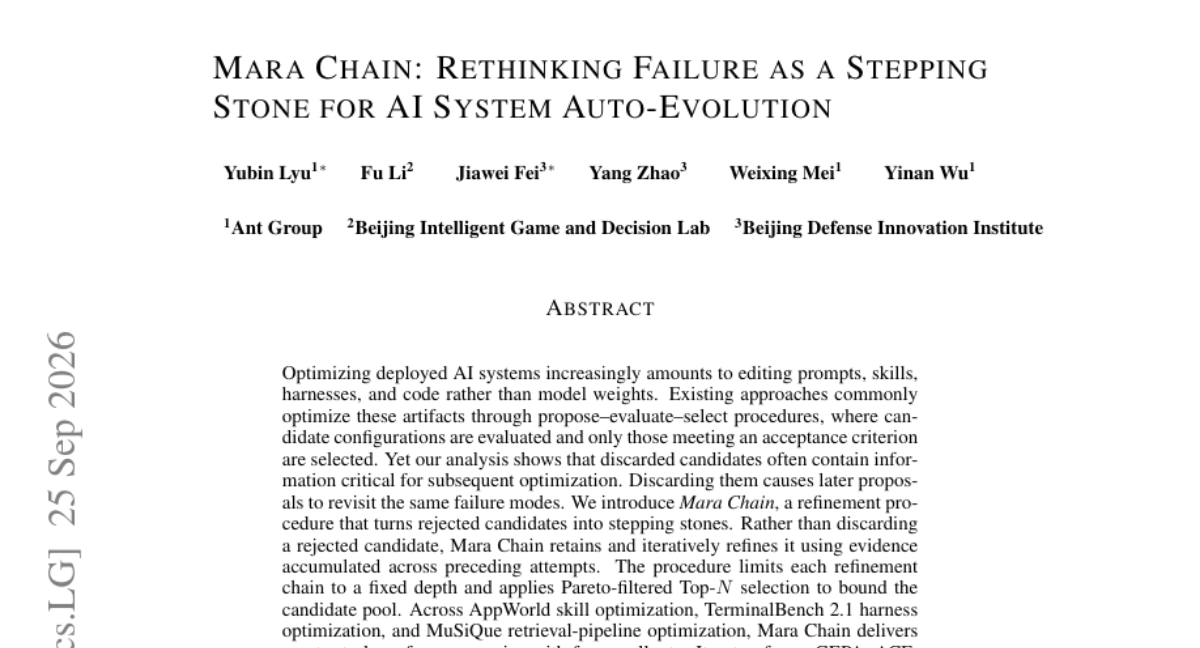
优化已部署的 AI 系统正越来越等同于编辑 prompts、skills、harnesses 与代码,而非调整模型权重。现有方法通常采用 propose-evaluate-select 流程:先生成候选配置,再逐一评估,仅保留满足接受准则的候选。然而分析表明,被丢弃的候选往往包含对后续优化至关重要的信息,直接舍弃会让新的 proposal 反复踏入同一类失败模式。 为此,作者提出 Mara Chain,一种把被拒候选转化为垫脚石的精炼流程。它不再丢弃被拒候选,而是将其保留,并利用前序所有尝试累积的证据对其进行迭代精炼。该流程把每条精炼链限制在固定深度,并采用 Pareto 过滤的 Top-N 选择 来控制候选池规模,从而在探索与开销之间取得平衡。 实验覆盖三类场景:AppWorld 的 skill 优化、TerminalBench 2.1 的 harness 优化,以及 MuSiQue 的检索流水线优化。结果显示: - 相比 GEPA、ACE 与 SkillOpt-Lite,Mara Chain 以更少的 rollouts 取得更大的任务性能增益;在 AppWorld 上相对性能提升最高达 20.5%,达到目标分数所需 rollouts 比 GEPA 少 65.5%。 - 在 TerminalBench 2.1 上,其通过率分别比 AHE 和 Meta-Harness 高出 20.2 与 22.5 个百分点。 - 在 MuSiQue 上,相比手写检索流水线,test nDCG@10 与 Recall@10 分别提升 0.104 与 0.131。
论文精读
TL;DR Mara Chain 将被拒绝的候选配置保留并沿链迭代精炼,把失败当作垫脚石。它在 AppWorld、TerminalBench 2.1、MuSiQue 上以更少 rollouts 实现更高性能,相对 GEPA 等最高提升 20.5%。
问题
问题背景
当前 AI 系统部署后的优化重心正从模型权重转向可调工件(prompts、skills、harness、代码),自动进化方法成为研究热点。
现有方法局限
主流流程采用 propose-evaluate-select:生成候选配置,评估后仅保留通过接受标准的候选,其余一律丢弃。这造成严重信息损失:
- 被拒绝候选常包含部分有效修改或关键失败模式;
- 丢弃后,后续提议容易重复探索相同无效路径,浪费 rollout;
- 如在 AppWorld 技能优化中,反复遇到同一失败模式,收敛缓慢。
为什么这个问题难/重要
可调工件空间离散、高维且受约束,评估需运行完整任务,成本高。失败信号中蕴含梯度信息,但直接保留所有失败候选会导致候选池爆炸。如何有选择地利用失败样本、控制链式细化深度与候选池规模,是核心技术挑战。业界对自动调优智能体、持续集成自动修复等场景高度关注,减少 rollout 次数直接决定落地成本。
行业类比
类似于强化学习中经验回放不仅保留高奖励轨迹,也保留失败轨迹用于学习;或代码调试中保留失败测试用例以指导后续修改,Mara Chain 把“失败”变成可复用的进化素材。
核心洞察
- Mara Chain 的核心洞见是把被评估拒绝的候选当作可迭代精炼的中间产物,而非终点错误。传统 propose-evaluate-select 循环只保留通过验收的候选,丢弃大量包含部分有效组件的失败配置,导致后续提议重复类似失败模式。Mara Chain 通过保留失败候选并沿着证据积累链逐步修正,将失败转化为下一轮优化的起点。这一视角与 GEPA、ACE 等一次性选择方法形成差异:它们缺乏失败记忆,而 Mara Chain 显式建模失败路径,减少冗余采样,在相同 rollout 预算内实现更高任务性能。
- 第二个关键角度是引入 Pareto-filtered Top-N 选择来约束候选池规模,平衡搜索的探索深度与计算成本。链式精炼可能导致候选数量指数增长,而 Mara Chain 先按多个指标(如任务得分、多样性、链深度)做 Pareto 支配筛选,再截断至 Top-N,保留非支配解。这种机制既防止了有效候选被过早淘汰,又控制了并发调度和存储开销。相比固定精英策略或随机丢弃,Pareto 过滤能保留处于不同权衡前沿的候选,有利于跳出局部最优;实验显示它在 AppWorld 上比 GEPA 减少 65.5% rollout 达到目标分数,验证了其效率优势。
方法
输入
优化对象是部署 AI 系统中的可调 artifacts:prompts、skills、harnesses、检索管线代码等。评估通过指定任务集和指标(如 pass rate、nDCG@10、Recall@10)完成,目标是最大化性能并减少 rollout 次数。
关键模块
外部优化循环:整体遵循 propose-evaluate-select 范式,但引入 Mara Chain 细化阶段。候选配置生成并评估后,未通过接受准则的候选不再直接丢弃,而是转入细化链。
Mara Chain 反思细化:每条链从一个被拒绝的候选开始,利用此前所有尝试的评估日志、错误信息和诊断结果作为“证据”,迭代修改 artifact(例如改写 prompt、调整 harness 参数、重写检索逻辑)。每次细化生成新候选并再次评估,若仍被拒绝则继续在同一链上细化。链深度固定在有限值(如 4),防止无限循环。
Pareto-filtered Top-N 选择:每轮生成多个细化候选后,使用 Pareto 支配关系过滤掉被其他候选在多个指标上支配的个体,再按综合得分取前 N 个进入下一轮候选池,控制搜索空间规模,平衡探索与利用。
实际实现:包含并发调度器以并行评估候选,文件系统作为全保真记忆保存每一轮的 artifact 变更历史,以及带防作弊和可靠性约束的 proposer 扩展,保证修改可追溯且合法。
输出
最终输出满足接受准则或达到终止条件的优化 artifacts(例如更新后的 skill 配置、harness 代码或 retrieval pipeline)。
与同类方法的差异
与 GEPA、ACE、SkillOpt-Lite 等只保留合格候选的方法不同,Mara Chain 将被拒绝候选转化为后续搜索的起点,利用失败证据引导持续细化,从而减少对相同失败模式的重复探索,提升优化效率。
实验
实验设计
Mara Chain 在三个不同场景下验证:AppWorld 技能优化、TerminalBench 2.1 智能体 harness 优化、MuSiQue 检索 pipeline 优化(超越智能体系统)。评估策略包含任务性能提升与 rollout 效率,对比基线包括 GEPA、ACE、SkillOpt-Lite、AHE、Meta-Harness 及手写 pipeline。
关键发现
- AppWorld:相对性能提升最高达 20.5%,达到目标分数所需 rollouts 比 GEPA 减少 65.5%。
- TerminalBench 2.1:pass rate 分别比 AHE 和 Meta-Harness 提高 20.2 和 22.5 个百分点。
- MuSiQue:test nDCG@10 和 Recall@10 分别提升 0.104 和 0.131,对手写检索 pipeline 优势明显。
基线对比解读
Mara Chain 不丢弃被拒绝的候选,而是将其迭代精化,利用累积证据突破持续失败障碍。与 propose-evaluate-select 类方法(如 GEPA)相比,它在更少 rollout 内达成更高性能,表明失败样本中蕴含可复用信息。该设计对实际工程启示:优化 AI 系统时,保留并分析失败轨迹能显著降低搜索成本,避免重复探索相同失败模式。
行业影响
落地场景
Mara Chain 适用于任何以 prompt / skill / harness / retrieval pipeline 为可调参数的 AI 系统自动优化。典型产品包括:
- 企业知识库问答机器人:自动优化检索 pipeline 与 agent skill,提高答案准确率。
- 电商推荐/搜索:优化排序模型外部的召回/重排 pipeline,提升 nDCG/Recall。
- 自动化代码助手:优化 harness 与工具调用逻辑,减少失败重试。
商业价值
- 降本:少至 65.5% 的 rollouts 达到目标,直接减少 GPU/API 调用成本和人工调参时间。
- 增效:在 AppWorld 上相对性能提升最高 20.5%,TerminalBench 2.1 通过率提升 20.2/22.5 个百分点,MuSiQue 检索指标显著提升,可转化为更高的任务完成率与用户留存。
- 体验:减少失败模式反复出现,agent 输出更稳定。
与现有产品/工作流的接口
Mara Chain 可作为独立 refinement 层 嵌入现有 propose-evaluate-select 循环。它不改动模型权重,只管理 artifact 候选池,因此可兼容现有 orchestrator、evaluation harness 和 CI/CD pipeline。例如可在 LangGraph / AutoGen 等框架中作为调度器插件,用文件系统保存全量编辑历史作为 memory,利用 Pareto 过滤控制候选数。
局限
- **适用性与评估信号依赖**:Mara Chain 在三个特定任务上验证——AppWorld 技能优化、TerminalBench 2.1 harness 优化、MuSiQue 检索管道优化,且 artifacts 类型均为文本或可编辑配置。对于数值型超参数调优、模型权重微调、多模态组件或其他非文本 artifact,该方法能否正常工作尚不明确。此外,Pareto 选择与验收准则要求目标可以量化比较(pass/fail 或标量分数),对于主观评估、开放式任务或难以定义单一指标的优化场景,可能需要额外设计评估模块,限制了即插即用性。
- **超参数敏感性未充分分析**:论文限制每个 refinement chain 的深度为固定值,并采用 Pareto-filtered Top-N selection 控制候选池大小。虽然这些设计用于防止候选爆炸,但固定深度可能提前截断有潜力的长链优化路径,而 Top-N 截断可能损失多样性,尤其在复杂搜索空间中。论文未系统研究不同深度、N 值或 Pareto 前沿参数对最终性能的影响,实际部署时需要额外调优,增加了工程成本。
- **基线覆盖与泛化验证有限**:论文主要与 GEPA、ACE、SkillOpt-Lite、AHE、Meta-Harness 等方法比较,但未涵盖更多最新自动优化框架,如 DSPy、TextGrad、OPRO 或基于强化学习的优化器。此外,跨模型泛化实验仅在少数模型上测试,未在更大规模或不同架构的 LLM 上进行系统性验证。对于实际生产环境中的模型多样性和任务复杂性,Mara Chain 的鲁棒性仍需更多证据支持。