用 Jev 决策模型替代大型语言模型,实现低延迟边缘服务编排
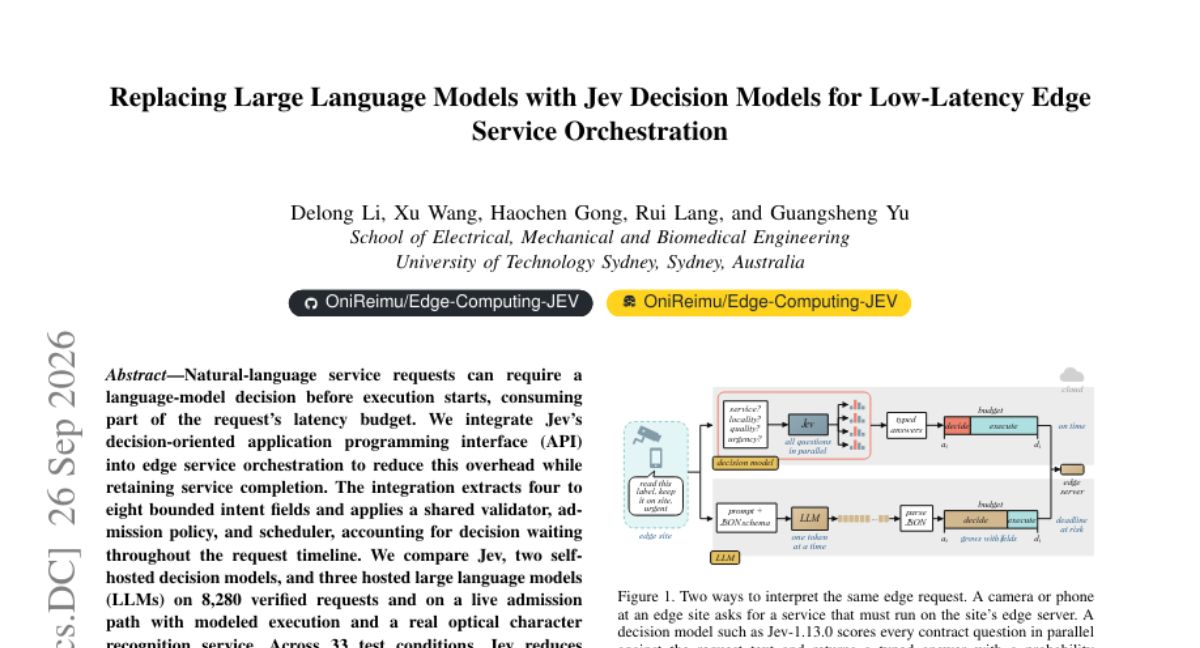
自然语言服务请求在执行前往往需要一次语言模型决策,从而占用请求的延迟预算。我们将 Jev 面向决策的 API 集成到边缘服务编排中,在保住服务完成率的同时削减该开销:抽取 4 至 8 个有界意图字段,共用一套 validator、admission policy 与 scheduler,并在整个请求时间线中计入决策等待。 我们在 8,280 条已验证请求、以及带建模执行与真实 OCR 服务的实时准入路径上,对比 Jev、两个自托管决策模型与三个托管 LLM。在 33 种测试条件下,Jev 将 中位决策延迟 相对最快的 LLM 降低 22.7–64.5%,且几乎不随输入规模、契约宽度或目录规模变化。 在四字段契约上,Jev 每次正确决策的 API 费用 低 59.7–80.9%,代价是少量精确匹配点;宽契约则触及替代方案的极限。随请求附带服务目录时,Jev 对未见服务的命名准确度与已知服务相当。 在实时准入路径上,LLM 达标率跌破 0.1 的负载下,Jev 仍保持 0.91–0.95 的请求精确且按时。缓存重复描述已使各解释器延迟相近,因此增益来自 新鲜决策;结果支持在受限契约上以决策模型替代 LLM,服务于延迟敏感的准入。
论文精读
TL;DR Jev 决策模型替代 LLM 处理边缘服务编排的意图决策,中位延迟降 22.7–64.5%、费用降最高 80.9%,延迟几乎不随输入与目录规模增长,适合低延迟有界契约准入。
问题
问题背景
边缘服务编排中,自然语言服务请求常需先经过语言模型决策,才能触发后续执行,这一决策步骤消耗了请求的延迟预算。
现有方法局限
- LLM 作为意图解释器:推理延迟高,且随输入长度、意图字段数(4–8 个有界字段)、服务目录规模增大而明显上升,难以满足边缘场景的毫秒级要求。
- API 成本:托管 LLM 每正确决策的费用较高,尤其在高吞吐量下累积成本显著。
- 性能退化:在宽合同(更多字段)场景下,LLM 的精确匹配率下降;高负载时,LLM 决策的准确性和及时性急剧恶化,实时准入路径上仅有不到 0.1 的请求能保持准确且按时完成。
- 缓存依赖:缓存重复描述虽可拉近延迟,但新鲜请求的决策仍是瓶颈,无法从根本上解决延迟问题。
为什么这个问题难/重要
边缘计算对延迟极度敏感,服务编排需要在极短时间窗口内完成意图解析与调度。自然语言本身具有模糊性,而 LLM 强大的语言理解能力伴随高计算开销,难以直接嵌入低延迟路径。业界正积极寻找在保持足够准确率的前提下,大幅降低决策延迟和成本的方法,例如专用小模型、决策导向 API 或结构化输出约束。本研究验证了用 Jev 决策模型替代 LLM 的可行性,为延迟受限的准入控制提供了新思路。
行业类比
类似在实时语音助手中,将大型语言模型替换为轻量级意图分类器,以在保证基本理解的同时将响应延迟从秒级压缩到毫秒级。
核心洞察
- 决策模型通过结构化输出和有界意图字段绕过 LLM 的 token 生成延迟,实现延迟与输入规模解耦。Jev 的 API 直接提取四个到八个有界意图字段,而不是生成自由文本,这使其决策延迟不随输入大小、合同宽度或目录大小变化,而 LLM 的延迟通常随生成 token 数线性增长。这种架构差异让 Jev 在边缘低延迟场景中具有可预测性,适合实时准入控制。
- 缓存重复请求掩盖了 LLM 与决策模型的延迟差距,新鲜请求才是真正瓶颈。论文发现缓存重复描述使得各模型延迟相近,Jev 的优势主要在未缓存的新鲜决策上。这表明在边缘服务中,大量重复请求可通过缓存处理,但服务目录动态变化或新请求涌入时,决策延迟直接影响端到端服务质量。因此选择轻量决策模型而非通用 LLM 是面向长尾新鲜请求的优化。
方法
输入
自然语言服务请求进入边缘编排系统,请求可能包含服务目录信息。系统需要快速解析意图,决定是否准入并调度到相应服务执行。
关键模块
Jev 决策模型 API:利用 Jev 的决策导向 API 替代通用 LLM,从请求中提取 4-8 个有界意图字段(如服务名称、参数、约束等)。这些字段受契约约束,确保输出结构化且可校验。
共享验证器:对提取的字段进行合法性校验,检查是否满足服务准入的契约要求,过滤非法或模糊请求。
缓存机制:对重复出现的请求描述缓存其解释结果,避免重复调用决策模型,降低延迟。但论文指出缓存重复描述时各解释器延迟接近,Jev 的优势主要体现在新鲜决策上。
准入策略:基于验证结果和系统当前负载,决定请求是否被接受。该策略与决策等待时间协同考虑,确保整体延迟预算不被突破。
调度器:将准入的请求调度到合适的边缘服务(如 OCR 服务)执行,同时将决策等待时间纳入端到端请求时间线。
输出
系统输出准入/拒绝决策及调度安排,保证服务执行完成。评估显示 Jev 在中位决策延迟、API 费用、新服务泛化等方面优于 LLM 基线。
与同类方法的差异
不同于直接使用通用 LLM 进行开放式意图解析,Jev 决策模型通过提取有界字段并配合验证、缓存、调度等模块,将决策过程约束在低延迟、低成本的目标内,尤其适用于边缘场景下延迟受限的服务编排。
实验
实验设计 本研究构建了 EdgeIntent v1 基准,包含 8,280 个已验证请求,覆盖四至八个有界意图字段。对比了 Jev、两个自托管决策模型和三个托管 LLM。在实时准入路径上,集成真实 OCR 服务并模拟执行,测试端到端服务完成情况。
关键发现
- 在 33 种测试条件下,Jev 的中位决策延迟比最快的 LLM 低 22.7–64.5%。
- 延迟几乎不受输入大小、合约宽度或目录大小影响。
- 四字段合约下,Jev 的 API 费用每正确决策低 59.7–80.9%,准确度略有下降。
- 动态服务目录中,Jev 对未见服务的命名准确度与已知服务相当。
- 实时准入路径上,当 LLM 的精确且按时完成比例低于 0.1 时,Jev 保持 0.91–0.95。
与基线对比解读 Jev 在延迟和成本上显著优于 LLM,尤其在新鲜决策上;缓存重复描述会缩小差距。宽合约(八字段)可能限制替换效果,表明 LLM 在复杂意图上仍具优势。工程启示:对于延迟敏感且有界意图的边缘服务编排,决策模型可作为 LLM 的低成本替代,但需评估合约宽度。
行业影响
落地场景
Jev 决策模型 适用于边缘侧需要自然语言意图解析且对延迟敏感的场景:
- 智能家居语音控制:本地网关直接解析指令(开关灯、调温)为设备操作,不依赖云端 LLM;
- 工业物联网:产线设备接收自然语言运维指令,生成带约束的任务计划并立即执行;
- 车联网与自动驾驶:车辆对道路事件描述进行即时意图分类,触发驾驶策略调整。
商业价值
主要沿降本与体验提升两条线:
- 推理费用:四字段合同下,Jev 每正确决策的 API 费用比最快 LLM 低 59.7–80.9%,且延迟几乎不随输入大小或服务目录大小增长;
- 实时服务质量:在实时准入路径上,Jev 保持 0.91–0.95 的精确按时完成率,LLM 则降至 0.1 以下,大幅减少超时与业务损失;
- 吞吐能力:低延迟决策释放边缘节点算力,可处理更多并发请求,提升系统整体效率。
与现有产品 / 工作流的接口
Jev 提供决策导向 API,可无缝替换现有服务网格或编排器中 LLM 的调用点:
- 在 Kubernetes 准入控制 或 API 网关 中,将自然语言请求解析为 4–8 个有界意图字段,再进入共享 validator、admission policy、scheduler;
- 结合服务目录动态下发,每个请求附带 catalog,Jev 对未见服务同样准确,适配微服务动态注册环境;
- 与本地 LRU 缓存配合:重复描述可直接命中缓存,Jev 优势在 fresh decisions,两者互补可最大化低延迟收益。
具体落地 use case
- 电商平台智能客服意图路由:边缘节点接收用户自然语言查询(如“查询订单物流”),Jev 在毫秒级提取意图字段并路由到对应微服务,避免调用中心 LLM,降低延迟和成本,支撑大促流量。
- 企业服务工单自动分派:ITSM 系统在用户提交自然语言工单时,用 Jev 在边缘解析优先级、分类、影响范围等字段,实时触发自动分派规则,保障 SLA 达标。
局限
- 论文在摘要与讨论中明确承认,当契约宽度增大(例如从4字段扩展到8字段)时,Jev 的准确率优势缩小,宽契约标记了决策模型替代 LLM 的极限。这表明 Jev 仅适用于意图字段数量有限、结构相对简单的边缘服务准入决策,对于需要复杂意图理解、多步推理或开放域语义解析的请求,其决策能力可能不足,应用范围受限。
- 论文实验表明,在启用缓存重复描述的条件下,LLM 与 Jev 的解释延迟几乎相同,Jev 的延迟优势主要体现在新鲜请求上。因此,在实际工作负载中若重复请求占比很高,Jev 带来的端到端延迟改善有限,且还可能引入准确率损失,此时替换 LLM 的经济与技术收益都会大打折扣,部署方需要仔细评估请求的新鲜度分布。
- 实验基于自建的 EdgeIntent v1 基准和真实 OCR 服务,服务类型较为单一,且对比的 LLM 均为托管 API(未涵盖本地部署的开源 LLM),结论的泛化性存在疑问。此外,Jev 作为决策模型可能依赖于结构化输出契约,对模糊或非规范的自然语言表达鲁棒性未知;论文虽报告 API 费用降低,但未讨论数据隐私、长期维护成本或供应商锁定等问题,这些都可能影响实际工程选型。