去中心化 Master-Mind:多智能体路径规划中通过迭代意图去噪的联合动作精化
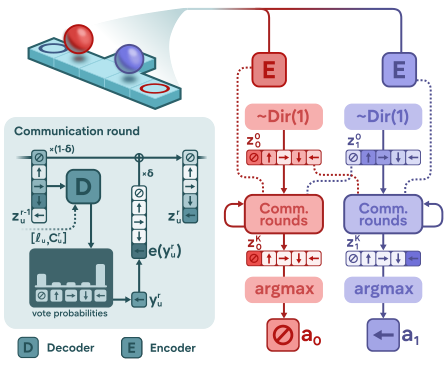
去中心化多智能体路径规划(MAPF)在部分可观测条件下要求智能体在通信辅助下无碰撞地抵达各自目标。基于专家数据训练的可学习策略是有效途径,但当同一情境下存在多个可行的协同联合动作时,各自独立地从单智能体分布中采样,可能把局部有效的选择重组为互不兼容的联合动作。这一失败可能源于最终的采样机制,即便单智能体动作分布已学得正确。 DMM(Decentralized Master-Mind)通过以离散、迭代式的动作意图精化替代一次性动作采样来解决该问题,其灵感来自扩散模型中的去噪过程。智能体先初始化随机的动作意图,再通过局部通信反复精化,在最终决策前耦合彼此的选择。DMM 先以模仿学习在专家 MAPF 解上预训练,再用 MICPO 进一步优化——这是一种面向多智能体、多轮动作精化的无 critic 组相对强化学习方法。 实验表明,DMM 的成功率普遍高于所评估的可学习基线,解成本更低。在 1,600 个 MovingAI 任务上,经 MICPO 微调的 DMM 解出 1,598 个,为所评估方法中覆盖率最高者,同时解成本接近最强基线。DMM 还可扩展至障碍密集环境中超过一百万个同时行动的智能体。 这些结果表明,轮级别的意图精化能在保持去中心化执行的同时改善联合动作协调。
论文精读
TL;DR DMM 将扩散去噪思想用于多智能体路径规划,通过多轮通信迭代细化动作意图,避免独立采样导致的不兼容,在 MovingAI 上解决 1598/1600 任务且可扩展至百万智能体。
问题
问题背景
多智能体路径规划(MAPF)是机器人集群、仓储物流等场景的核心问题,近年来可学习策略在分散执行环境下展现出潜力。
现有方法局限
主流学习式 MAPF 策略(如 SCRIMP、DCC)在训练后采用 一次性采样(one-shot sampling)生成动作:每个智能体根据局部观测输出动作分布,然后独立采样。当同一上下文中存在多个合法协调联合动作时,独立采样可能将每个智能体各自合法的动作重新组合成不兼容的联合动作,导致碰撞或死锁。即使单个智能体的动作分布已学习正确,这种 分散分解间隙(decentralized factorization gap)依然存在,成为阻碍协调的关键瓶颈。
为什么难/重要
分散执行约束下,智能体只能依赖局部通信,无法使用集中式协调;而联合动作空间随智能体数量指数增长,采样对齐难度极大。部分可观测进一步限制了全局状态感知,需要在不牺牲分散性的前提下实现动作层面的耦合。业界对大规模智能体协同(如自动驾驶、无人机编队、仓储机器人)需求持续增长,如何在保持低通信开销的同时提升联合动作一致性,是当前学习式 MAPF 落地的核心挑战。
行业类比
该问题类似于多智能体强化学习中的动作协同难题,尤其在自动驾驶无信号交叉口场景中,每辆车独立决策却必须达成一致的通行顺序。
核心洞察
- DMM 把多智能体动作协调从“直接采样”改为“多轮意图去噪”,将离散扩散的迭代细化引入去中心化 MAPF。独立采样正确边际分布仍然可能得到冲突的联合动作(论文称之为 decentralized factorization gap),而 DMM 通过多轮局部通信逐步对齐各智能体动作意图,在承诺最终动作前完成耦合。这与以往学习式 MAPF 方法(如直接使用图神经网络解码单步动作、或依赖集中式 critic 评价联合动作)形成对比,保留了去中心化执行的简洁性,同时缓解了采样层面的协调失效。
- MICPO 是一种无需 critic 的多智能体强化学习微调方法,专为多轮意图细化设计。它使用匹配 rollout 组计算团队回报和组相对优势,避免了学习全局价值函数或集中式 critic,从而在智能体数量增长时保持可扩展性。这与常见的 MAPPO / QMIX 等需要 critic 或值分解的方法不同,也与独立 PPO 直接优化单智能体策略不同。实验显示 MICPO 微调后 DMM 在 MovingAI 上达到 1598/1600 的成功率,覆盖率和成本均接近强 baseline,同时保持了去中心化执行的可部署性。
- DMM 的架构和训练范式支持百万级智能体同时动作,在障碍物密集环境中依然有效。这得益于意图初始化随机、局部通信状态简洁以及去中心化推理时无需全局协调,推理时 refinement 深度可调。论文将学习式方法扩展到 1,000,000 智能体,远超过以往学习式 MAPF 通常几百个智能体的规模,证明迭代意图去噪不会成为通信瓶颈,为大规模机器人调度或仓储场景提供实际参考。
方法
输入与问题建模
DMM 面向部分可观测的分散式 MAPF:每个智能体仅依赖局部观测与邻域通信做出动作决策。传统学习策略虽能输出正确的边际动作分布,但独立采样会导致 解耦因子分解间隙——多个局部合法动作在组合时互相冲突。
关键模块:迭代意图去噪
DMM 的核心创新是在最终动作采样前引入多轮协调机制。整体流程为:
- 意图初始化:每个智能体从随机或学习到的先验中采样一个动作意图
intent,作为本轮动作候选项。 - 迭代细化:在每轮通信中,智能体交换当前意图,通过可学习网络融合邻居信息,更新自己的意图;这一过程重复固定轮数,使各方逐渐收敛到兼容的联合动作。
- 最终承诺:经过预定轮数的细化后,智能体将最终意图解码为实际执行动作。
该机制类比扩散模型去噪:初始随机意图经过多轮“去噪”逼近协调一致的联合动作,从而在采样前耦合各智能体选择。
训练流程
训练分两步:
- 模仿预训练:利用专家求解器生成轨迹,监督学习意图初始化与多轮细化策略,让模型掌握基本协作模式。
- MICPO 微调:无 critic 的多智能体轮级策略优化。采用 group-relative advantage,在匹配 rollout 组内比较团队回报计算相对优势,并配合 bounded replay 控制回放规模,稳定优化策略。
工程启示
DMM 在采样前耦合选择,显著降低冲突概率。在 MovingAI 1600 项任务中微调后成功解决 1598 项,并扩展至百万级智能体,表明该设计适合大规模分散执行场景。
与同类方法的差异点:相比一次采样直接执行的基线,DMM 把协调开销前置到多轮意图协商,避免独立动作组合时的冲突。
实验
实验设计
DMM 在两类标准 MAPF 基准上评估:POGEMA 与 MovingAI。前者用于部分可观测、通信约束下的综合比较,后者包含 1,600 个任务,覆盖不同地图与智能体数量。此外还设计了大规模可扩展性实验(障碍物密集环境)与 Corridor 冲突实验,验证意图细化在狭窄通道中的协调能力。训练分为两阶段:先用专家解进行模仿学习预训练,再用 MICPO(无 critic 的群体相对强化学习)微调。推理时智能体通过多轮通信迭代细化动作意图,最终统一采样提交动作。
关键发现
- 在 MovingAI 1,600 个任务上,经过 MICPO 微调的 DMM 解决 1,598 个,覆盖率为所有评估方法中最高。
- 解代价与最强基线接近,说明细化没有牺牲路径质量。
- DMM 可扩展到 超过 100 万 智能体同时行动,且处于障碍物密集环境,验证了分布式执行下的可扩展性。
- 消融显示,用意图细化替代一次性采样缓解了 decentralized factorization gap,多轮通信耦合了本地合法选择。
与基线对比深度解读
相比从单智能体分布独立采样再组合的 learnable 基线,DMM 的核心差异在于先细化后承诺:即使每个智能体的动作分布学得正确,直接采样仍可能重组出不兼容的联合动作。DMM 用离散迭代意图去噪让智能体在提交前协商,使最终联合动作更一致。这一点在实际工程中尤其重要:在多机器人调度、仓储 AGV 等场景,无需集中控制器即可提升全局成功率,而 MICPO 的无 critic 设计也降低了多智能体强化学习的训练难度。但解代价只是接近而非低于最强基线,提示意图细化可能在极窄通道中仍有冲突残留,后续可结合更细粒度意图或更长细化深度。
行业影响
落地场景
DMM 适用于需要大量智能体在共享空间内安全高效移动的场景:
- 仓储机器人集群:电商仓库中数百台 AMR 同时执行拣选、搬运任务,DMM 的去中心化通信与迭代意图细化可降低碰撞率,提高任务吞吐。
- 自动驾驶车队调度:港口、机场的无人驾驶卡车或摆渡车协同路径规划,部分可观测环境下依然保持可靠性。
- 无人机编队与配送:城市低空多无人机同时执行快递配送,通过局部通信协调航路,避免空中冲突。
商业价值
- 降本:DMM 无需中心化求解器,随智能体数量线性扩展,在百万智能体规模下保持可用,大幅降低全局优化计算成本;训练采用模仿学习 + critic-free RL,避免训练 critic 网络,简化训练管线与算力消耗。
- 增收 / 体验提升:在 MovingAI 基准上 1,600 任务解决 1,598,高覆盖率直接减少任务失败导致的额外调度成本;更低的解决方案成本(路径长度)意味着更短的作业时间,提升单位时间产出。
与现有工作流的接口
- 替换采样模块:现有 learnable MAPF 策略通常输出动作分布后独立采样,可将该环节替换为 DMM 的迭代意图细化,保留原有编码器与通信网络,降低集成成本。
- 训练管线适配:DMM 的 MICPO 采用 group-relative advantage 和 bounded replay,可接入现有 PPO/多智能体 RL 框架;预训练使用专家数据(如来自 EECBS、LaCAM 等经典求解器),容易生成。
- 推理与环境集成:DMM 在 POGEMA 基准上验证,该基准提供 GPU 加速环境,可快速部署到现有的多智能体模拟器(如 NVIDIA Isaac Sim、AWS RoboMaker)作为策略后端。
局限
- **依赖专家数据预训练**:DMM 的模仿学习预训练阶段需要大量高质量专家 MAPF 解。虽然论文在标准基准上使用现成求解器生成专家演示,但在新环境或大规模场景中,获取专家解的成本可能很高。此外,专家解的质量直接影响策略上限,若专家解本身次优或存在偏差,DMM 可能继承这些缺陷。MICPO 的强化学习微调可以部分缓解,但无法完全消除对专家数据的依赖,限制了其在没有现成专家解的领域快速部署。
- **迭代细化增加推理开销**:DMM 通过多轮通信迭代细化意图,相比一次性采样方法(如 DCC),推理时需要更多通信轮次和计算。虽然论文在实验中用 GPU 加速环境实现百万智能体,但实际分布式系统中,通信延迟和带宽可能成为瓶颈。特别是在动态场景或需要快速响应的应用中,额外的通信轮次可能影响实时性。论文未深入讨论在受限通信条件下的推理延迟和能耗,这有待后续工作评估。
- **与专用搜索算法对比有限**:论文主要与学习型基线比较,但未与最先进的集中式 MAPF 求解器(如改进的 CBS、ECBS 等)在相同场景下全面对比。去中心化方法牺牲了全局最优性,虽然 DMM 在成功率上表现好,但在解成本上可能仍高于集中式最优解。此外,MICPO 作为无 critic 算法,训练稳定性可能不如基于 critic 的多智能体 RL,可能需要更精细的超参数调节。这些局限需要在更广泛基准上进一步验证。