打到标准杆:面向可证明最优四边形块分解的强化学习
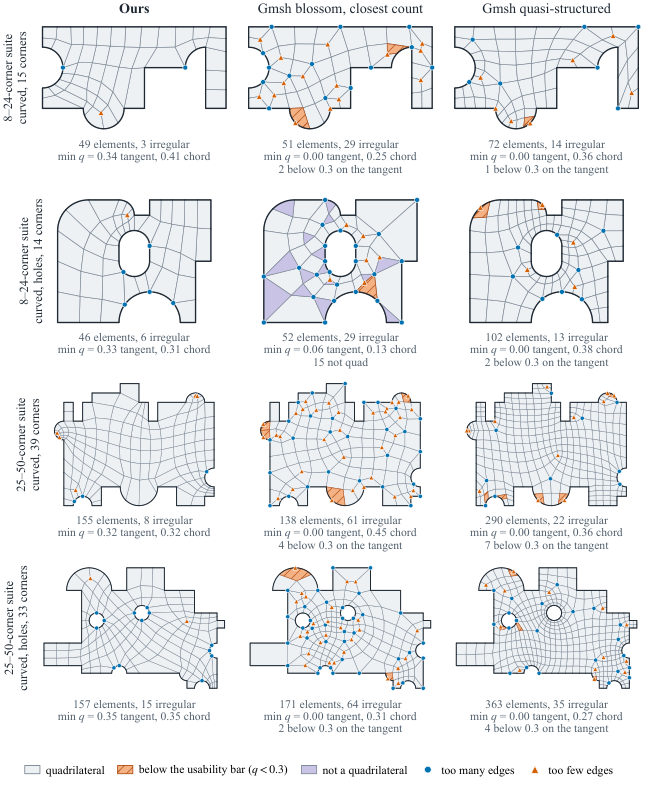
四边形块分解的质量由三点判定:是否完整、元素形状是否良好、不规则顶点有多少。最后一项存在可证明的下界:离散 Gauss-Bonnet 恒等式 仅凭区域的拓扑与角点角度,就为任意全四边形网格的顶点不规则度总和规定了最小值,我们称该下界为 par。 我们训练强化学习 智能体构建达到 par 的分解。它通过局部编辑 直接作用于网格的 half-edge 数据结构,策略网络的卷积遵循网格自身的连通性,因此无需改动即可用于比训练中所见更大的区域。奖励直接指向该下界且极为稀疏:边数超过八的区域上,随机采样无一能触及。我们先用行为克隆 克服这一探索障碍——最优网格易于构造,再反向走成演示轨迹——之后用 PPO 训练。 在 96 个留出区域上,智能体在每一个上都生成全四边形网格,平均 95.7 个可用、90 个可证明最优;Gmsh 在相同元素数下的最强配置仅完成 51 个、38 个可用、0 个最优,即使元素数增至三到十四倍也从未产出更规则的网格。在 64 个规模为训练集两倍的区域上,智能体全部完成、62 个可用,超出 par 的中位数 低于 1,而 Gmsh 在相同元素数下为 39。
论文精读
TL;DR 用强化学习训练智能体直接编辑半边网格,以离散 Gauss-Bonnet 下界为目标,生成可证明最优的四边形块分解,在多个域上远超 Gmsh。
问题
问题背景
四边形网格生成在有限元分析与几何处理中至关重要,相比三角形网格,四边形单元在流体、结构仿真中具有更高的数值精度与效率。当前研究聚焦于生成 完整、高质量、且不规则顶点数尽可能少 的四边形块分解。
现有方法局限
传统启发式方法(如 Gmsh 的 frontal 算法、quadrangulation 后处理)难以同时满足三个目标:它们通常无法保证达到理论下界 par,在相同单元数下完成率低、可用性差(论文实验中 Gmsh 最强配置仅完成 51/96,最优 0/96)。基于学习的方法(如 supervised mesh generation)依赖大量高质量配对数据,难以泛化到不同拓扑与更大边界,且在处理离散半边缘结构上的局部编辑时缺乏可行的探索策略。
为什么这个问题难/重要
达到 par 本质是一个组合优化问题:离散 Gauss-Bonnet 定理给出不规则顶点总数的下界,但如何通过局部编辑(如 edge flip、vertex insertion)达到该下界极其困难,动作空间巨大且奖励稀疏——随机探索在超过 8 边的域上完全无法获得正向奖励。此外,网格必须始终保持全四边形且无悬挂边,这要求智能体理解半边缘拓扑连接。业界对自动生成最优四边形网格有迫切需求,直接影响仿真精度和计算资源消耗。
行业类比
与 AlphaGo 通过深度强化学习解决围棋中稀疏奖励的组合博弈类似,本工作展示了 RL 结合模仿学习可在离散几何处理中达到可证明最优,为其他结构化网格生成任务提供了范式。
核心洞察
- 稀疏奖励直接由可证明最优下界定义,配合行为克隆最优解回溯生成的演示,使 PPO 能学到随机探索无法发现的策略。随机 play 在超过八边的域上无法命中 par,说明目标极端稀疏。传统方法要么采用密集启发式奖励,要么只在小型域上可行。本文利用“最优网格容易构造、但反向拆解成演示”的逆向课程,让策略先模仿从最优到随机的编辑序列,再微调,成功将 RL 应用于具有全局最优性保证的网格生成任务,避免了手动设计中间奖励。
- 策略网络直接在半边数据结构上定义,卷积仅沿 next/previous/twin 连接传播,使模型天然适配任意大小和拓扑的四边形网格,可零样本泛化到训练未见的大边界。区别于将网格体素化或转换为通用图的方案,半边结构编码了四边形网格的旋转对称性和局部一致性,策略因此学到的是与尺度无关的局部编辑规则。实验表明该策略在 64 个两倍训练尺寸的域上仍能完成全部网格分解,且中位超出 par 小于 1,而 Gmsh 在相同单元数下中位超出 39,说明拓扑感知的几何深度学习对网格优化至关重要。
方法
输入与 MDP 建模
方法输入为平面区域的边界表示(离散为折线段或曲线),内部以初始的半边数据结构(half-edge)网格承载。作者将该问题形式化为一个有限马尔可夫决策过程(MDP):
- 状态:当前网格的半边结构及其节点特征(如度数、角点标记等),不依赖全局坐标。
- 动作:一组局部编辑操作(如翻转、合并、分割、模板替换等),直接修改半边连接关系,保持四边形块分解。
- 奖励:以离散 Gauss–Bonnet 下界为基准,量化当前网格的总顶点不规则性与理论最优值(par)的差距,属于稀疏奖励。
关键模块:半边图卷积策略网络
策略网络不是传统 CNN 或 GNN,而是直接在半边结构上定义卷积。给定每个半边的特征,网络聚合其 next、previous、twin 三个邻接半边的特征,经过多层变换得到每个半边的嵌入。随后通过一个掩码动作分布层:根据当前网格状态生成所有合法编辑动作的概率分布(非法动作被屏蔽),采样得到下一步动作。该网络参数与具体网格规模无关,因此可泛化到比训练时更大的区域。
稀疏奖励下的训练策略
直接使用 PPO 在稀疏奖励下很难探索到最优解,尤其当边界边数超过 8 时随机探索几乎无法命中 par。作者采用行为克隆 + 强化学习的两阶段训练:
- 构造演示:利用可证明最优的网格实例(这些实例可以通过简单规则生成),从最优网格出发执行反向编辑序列,记录状态-动作对作为专家演示。
- 克隆初始化:用行为克隆预训练策略网络,使其初步具备朝向最优的编辑能力。
- PPO 精调:以稀疏奖励(与 par 的差距)为信号,用 PPO 继续学习,进一步提升策略的泛化与最优达成率。
输出与差异点
最终输出为完整四边形块分解,其所有顶点不规则度之和达到或接近理论下界。与 Gmsh 等基于启发式或局部优化的传统网格生成器相比,本方法通过 RL 直接学习全局最优编辑序列,并在半边连通性上定义卷积,避免了传统图网络对全局坐标或固定规模的依赖。
实验
实验设计
- 训练数据:合成平面域(四边形边界),训练后未见过的 96 个 held-out 域与 64 个更大边界域。
- 基线:Gmsh 最强配置,相同单元数。
- 流程:先用行为克隆从可构造的最优网格生成演示,再 PPO 训练;奖励直接以可证下界 par为目标(离散 Gauss–Bonnet 界)。
关键发现
- 96 个 held-out 域上:代理全部完成全四边形网格,95.7 个平均可用,90 个可证最优;Gmsh 完成 51 个、可用 38 个、最优 0 个。
- 64 个两倍训练尺寸的域上:代理全部完成,62 个可用,中位超出 par 低于 1;Gmsh 同单元数中位超出为 39。
与基线对比解读
Gmsh 即使使用 3–14 倍单元数也无法产生更规则的网格,说明其算法未直接优化顶点不规则度这一全局结构性目标;而本文智能体通过 mesh 原生卷积直接作用于半边结构,将奖励对齐 par 下界,因而能在稀疏奖励下学到可泛化的局部编辑策略。工程启示:在网格生成等组合优化问题中,将全局约束转化为可证明下界并作为奖励信号,配合从解反推的模仿学习,能突破纯搜索或启发式方法难以达到最优的瓶颈。
行业影响
落地场景
该方法适用于需要高质量全四边形网格的工程仿真与几何处理场景,例如有限元分析 (FEA)、计算流体力学 (CFD)、CAD/CAE 软件、游戏引擎自动重拓扑、数字孪生平台。四边形网格的顶点不规则性直接影响求解器收敛速度和数值稳定性,传统人工修复成本高。该 RL agent 可直接嵌入网格生成前端,自动将 CAD 边界转为可证明最优顶点不规则性的四边形块分解。
具体 use case:
- 自动驾驶仿真平台:道路、车辆几何更新频繁,该 agent 可自动生成高质量四边形网格,替代人工调整,减少预处理时间。
- 云端有限元分析服务:提供自动网格生成 API,用户上传几何即获得最优分解,提升仿真结果可靠性和一致性。
商业价值
核心价值在于降本增效。论文显示在 96 个 held-out 域上,agent 在相同元素数下比 Gmsh 最强配置多完成 39 个域的最优分解,且无需增加元素数,直接降低计算资源消耗。对于需要大量仿真的产品设计迭代(如消费电子结构优化、航空部件分析),可显著加速设计验证循环,减少网格修复专家投入,间接缩短产品上市周期。体验提升方面,自动生成可证明最优的网格,降低用户对网格质量的疑虑,减少仿真失败重跑次数。
与现有产品/工作流的接口
模型基于半边数据结构 (DCEL) 和图卷积策略网络,可封装为轻量级库或微服务,集成方式灵活:
- 作为网格生成器插件,读取 CAD 边界表示 (B-rep),输出四边形网格文件(如
.msh、.vtk),替换现有流程中的 Gmsh 调用。 - 提供 Python/C++ API,嵌入到仿真软件(如 OpenFOAM、FEniCS)的预处理步骤。
- 训练与推理分离:用户可在自有几何数据集上微调,或直接使用预训练权重,支持任意拓扑域,对更大边界泛化良好。
局限
- - **作用域限于平面问题**:方法专注于**平面四边形块分解**,未扩展到**曲面网格**或**三维体网格**。实际工程中的 CAD 模型常包含复杂曲面和实体,该方法无法直接套用。虽然论文提及 curved boundaries 的处理,但核心算法和最优性下界基于平面拓扑,推广到曲面需要重新定义离散 Gauss–Bonnet 下界及局部编辑操作,难度较大。 - **行为克隆依赖可构造的最优示范**:训练过程需要从可构造的最优网格“反向行走”生成示范数据,这要求对每个训练域都能快速得到最优解。对于任意复杂拓扑、非凸域或高亏格域,构造最优示范本身可能困难甚至 NP-hard,从而限制方法向更广泛输入类别的扩展。 - **泛化边界未充分验证**:实验仅在最多 128 个边的多边形域上进行,策略网络基于图卷积具有尺寸无关性,但对高亏格、大量孔洞、极不规则边界或非流形输入的泛化能力未测试。此外,奖励函数只优化顶点不规则性,可能忽略其他网格质量指标(如单元形状、尺寸分布),实际应用中需额外后处理或加权。