超球面语义轨迹分析:跨学术预印本、专利信号与算力扩展的技术扩散映射
宏观经济生产率指标(如 Total Factor Productivity )受行政调查周期与国民核算惯例所限,通常要在技术突破发生数年后才能记录,存在多年报告滞后。 本文提出 Hyperspherical Semantic Trajectory Analysis(HSTA),一种无监督定量方法,可直接从非结构化科学与商业文本流中追踪技术扩散,分析涵盖 arXiv 学术预印本与 USPTO 专利申请记录的 30,000 条筛选文档。 方法上,通过 Spherical K-Means 聚类与 UMAP 流形降维,将高维 Transformer 句向量投影至单位超球面,在八个主要子主题上形式化两项指标:Semantic Centroid Vector Drift,追踪时序子语料间的词汇迁移以识别结构性范式转变;Commercialization Offset,评估科学发现与知识产权申报之间的跨语料峰值密度对齐。 将季度主题量速度与 Epoch AI 数据库的硬件物理指标关联后,Vector Autoregressive F 检验显示,仅凭季度论文量速度在常规显著性水平下并不 Granger-cause 前沿算力分配激增,凸显文本信号需以物理资本约束为条件。实证结果表明,Large Language Models(漂移值 0.332)与 Artificial Intelligence Systems(漂移值 0.234)子主题的语义演化速率最高,为补充传统经济统计提供了客观、实时的机制。
论文精读
TL;DR HSTA 将 Transformer 嵌入投影到单位超球面,用语义质心漂移和商业化偏移量化 arXiv 与专利中的技术扩散,发现 LLM 语义演化最快(0.332),但论文量不能单独预测算力激增,提供补足传统经济统计的实时视角。
问题
问题背景
当前 AI 行业对技术突破的监测主要依赖论文发表数量、专利授权数或宏观生产率指标,但这类数据存在显著滞后,无法实时反映技术扩散与范式转移。
现有方法局限
- 宏观统计指标:如 Total Factor Productivity (TFP) 依赖行政调查周期,通常滞后数年,无法捕捉快速演进的 AI 子领域。
- 传统文本指标:基于关键词频率或 LDA 主题模型的方法假设词汇分布稳定,难以识别跨时间语料中的语义漂移和上下文重组;且无法同时对齐学术文本与专利文本的异构语义空间。
- 缺乏物理资本约束:多数研究孤立分析论文或专利,未将文本信号与计算资源投入等物理变量做因果建模,容易高估文本驱动的扩散效果。
为什么这个问题难/重要
技术挑战在于:Transformer 嵌入位于高维单位超球面,需要在流形上进行聚类与时间序列对齐;跨语料(arXiv 预印本 vs USPTO 专利)的语义偏移度量需要消除各自语料风格差异;同时,从观测数据推断 Granger 因果关系必须控制物理资本这一混杂变量。业界关注度高,因为早期识别技术扩散路径能指导研发资源配置、投资决策与标准制定,但现有工具缺乏可复现、可量化的实时信号。
行业类比
类似于在生产 ML 系统中用语义漂移监控替代事后报表:当模型输入分布发生概念漂移时,需要立即感知并联动资源调度,而不是等待季度财务报告滞后反馈。
核心洞察
- HSTA 在单位超球面上对 Transformer 句子嵌入做球形 K-Means,用语义质心向量漂移量化技术范式的结构性转变。与传统基于词频、关键词或 LDA 主题模型的文本指标不同,余弦相似度驱动的球形聚类对文档长度和词表规模不敏感,且质心漂移捕捉的是语义空间的连续位移而非离散词项变化,能更鲁棒地识别 LLM 和 AI Systems 等子领域的快速语义演化(drift 0.332 / 0.234)。该指标可作为模型能力跃迁或研究热点的实时探测器,补充滞后数年的 TFP 统计。
- 本文提出 Commercialization Offset 指标,通过跨语料对齐 arXiv 论文与 USPTO 专利的峰值密度延迟,量化科学发现到知识产权保护的扩散速度。不同于以往用专利引文网络或行政统计衡量创新传播,HSTA 直接利用非结构化文本流计算时序偏移,避免了引文滞后和分类不一致问题。工程上可用于监控技术从实验室到商业化落地的节奏,提前布局资源或识别技术成熟度拐点。
- VAR F 检验发现,仅凭 arXiv 论文量速度无法 Granger-cause 前沿计算分配激增,文本信号必须条件在物理资本约束上。很多 AI 趋势预测模型将论文/专利数量作为技术突破的先行指标,但本文用 Epoch AI 硬件数据证明文本量变化不具统计显著的预测力,说明算力供给瓶颈是更根本的驱动因素。构建技术扩散预测系统时应将文本语义信号与 GPU 产能、数据中心建设等物理指标联合建模,避免单维度误判。
方法
输入与预处理
HSTA 以 arXiv 学术预印本与 USPTO 专利申请记录 为双文本流,经过质量过滤后保留约 30,000 条文档,形成时序子语料库(temporal sub-corpora)。
关键模块
- 超球面向量化:对每个文档用 Transformer sentence embeddings 提取高维语义向量,再投影到单位超球面(即 L2 归一化)。
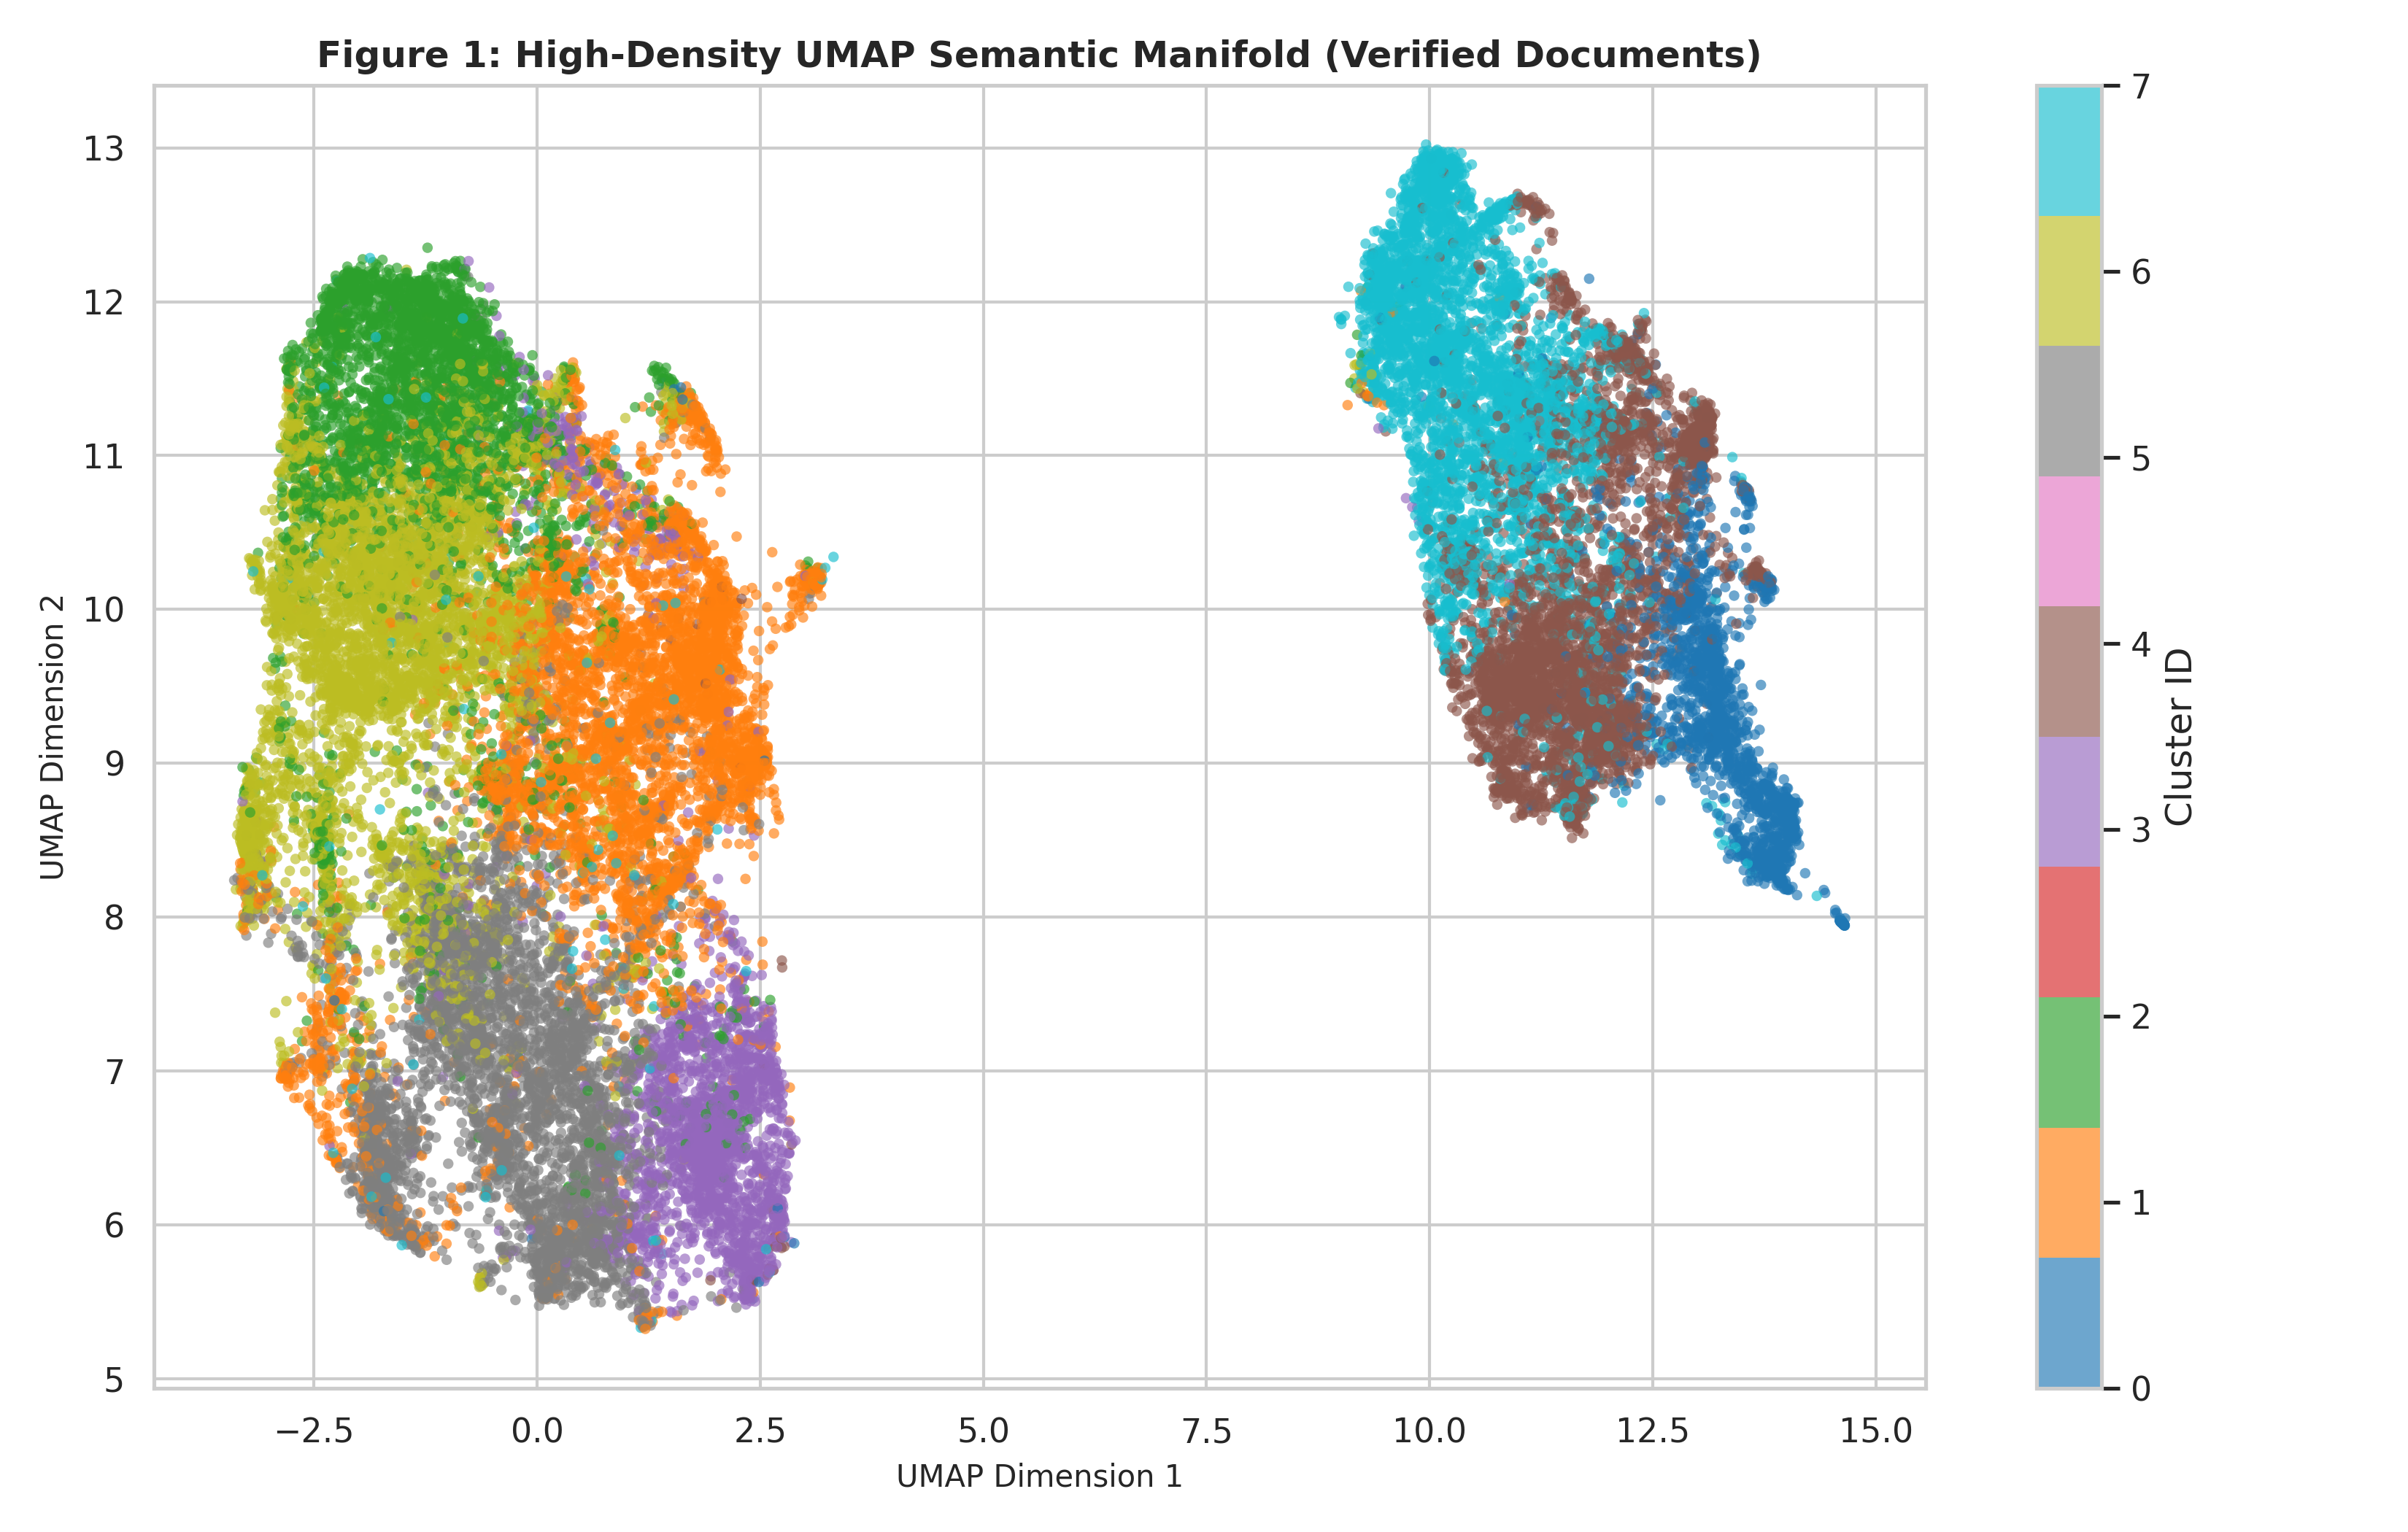
- 球面聚类与降维:使用 Spherical K-Means 在超球面上做 8 个主主题的聚类(簇数通过超参数验证确定);同时用 UMAP 做流形约简,用于可视化和质心轨迹追踪。
- 语义质心漂移 Δ_k:对每个主题簇,计算不同时间段子语料库的簇质心向量差异,量化词汇/语义的结构性转变;漂移值越大表示范式变化越剧烈。
- 商业化偏移 τ_k:将科学文本与专利文本分别按时间聚合密度,检测两流之间的峰值对齐延迟或领先关系,刻画从学术发现到知识产权申请的传播节奏。
- Granger 因果检验:把季度主题文档量增速与 Epoch AI 数据库 中的前沿计算硬件分配指标结合,通过 Vector Autoregressive (VAR) F-tests 判断纯文本信号是否 Granger-cause 计算资源激增。
输出
输出每个子主题的漂移指标(如 LLM 相关主题 Δ=0.332、AI Systems Δ=0.234)、商业化偏移 τ 以及 VAR 因果检验的显著性结论。实证显示纯论文量增速不足以 Granger-cause 计算分配激增,需将文本信号条件化于物理资本约束。
与单纯依赖文本计量或仅用专利/论文单一来源的方法不同,HSTA 同时融合学术与商业双流,并将物理计算资源作为因果检验的调节变量,提供更贴近真实技术扩散的量化机制。
实验
实验设计
研究从 arXiv 与 USPTO 采集 30,000 条经过质量过滤的文档记录,覆盖学术预印本与专利申请。通过 Transformer 句嵌入将文本投影至单位超球面,采用 Spherical K-Means 聚类为八个主要子主题,结合 UMAP 流形降维进行可视化。在此基础上定义两个指标:
- Semantic Centroid Vector Drift (Δ_k):跟踪时间子语料库间的词汇漂移,识别结构范式转变;
- Commercialization Offset (τ_k):评估科学发现与知识产权申请在跨语料库上的峰值密度对齐。
同时将季度主题量速度与 Epoch AI 物理硬件指标链接,用 VAR F-tests 检验格兰杰因果关系。
关键发现
Large Language Models 子主题的漂移指标达 0.332,Artificial Intelligence Systems 为 0.234,语义演化速率最高。格兰杰因果检验显示,仅凭季度论文量速度无法在传统显著性水平上格兰杰因果导致前沿算力分配激增,说明文本信号必须依赖物理资本约束进行条件化。该方法提供了一种实时、客观的机制来补充传统经济统计。
与基线对比解读
与传统 Total Factor Productivity 等宏观经济指标相比,后者因行政调查周期和国民核算惯例存在多年报告滞后,HSTA 直接从非结构化文本流中追踪技术扩散,消除时间延迟。与单纯依赖文本指标的方案不同,HSTA 显式引入 Epoch AI 物理硬件数据,通过条件化避免虚假因果推断,增强了指标的现实解释力。
行业影响
落地场景
HSTA 可直接嵌入技术情报与趋势监测产品,帮助科技公司、风投与研究机构实时追踪 AI 子领域的语义演化。例如,内容平台可用其监控 LLM、多模态等主题的漂移速度,提前调整算法研发重点;云计算厂商可基于 Commercialization Offset 判断某技术方向是否进入商业化拐点,优化产品路线图。
商业价值
- 降本:替代滞后的人工专家调研与宏观统计,从公开文本自动提取技术成熟度信号,降低市场研究人力成本。
- 增收/先发优势:语义漂移指标(如 Large Language Models 漂移值
0.332)可提前数季度提示范式迁移,企业据此布局专利、调整产品,抢占早期市场。 - 风险控制:Granger 因果检验表明单看论文数量无法预测计算资源投入,必须结合物理资本约束,这为投资者提供更稳健的决策依据,避免盲目跟风。
与现有产品/工作流接口
HSTA 方法可包装为 Python 库或 REST API,接入企业现有数据管道:从 arXiv、USPTO 拉取语料,用 Transformer 嵌入 + Spherical K-Means 聚类生成语义质心,输出到 BI 仪表盘或 MLOps 特征存储。也可与 Epoch AI 硬件数据库联动,做因果校验,成为技术投资决策支持系统的一个模块。
具体落地 use case
- 企业服务/云计算:某云厂商监控学术预印本与专利文本,当某子主题(如 agent 系统)的 Commercialization Offset 从 24 个月缩短到 9 个月时,自动触发 GPU 实例定价调整或新服务立项。
- 金融科技:量化基金将 HSTA 语义漂移作为另类数据因子,加入科技板块选股模型,回测验证其与超额收益的相关性,替代部分依赖财报滞后的基本面信号。
局限
- **数据集覆盖与代表性不足**:HSTA 仅依赖 arXiv 与 USPTO 两个数据源,可能遗漏工业界未公开的技术研发、开源社区讨论(如 GitHub、论坛)以及非英语学术资源。arXiv 以计算机科学为主,对 AI 而言覆盖较好,但对其他技术领域可能不均衡;USPTO 专利数据来自单一专利局,不能全面反映全球专利活动。此外,预处理中的过滤规则(如按相关性或关键词)可能引入选择偏差,影响技术扩散轨迹的完整刻画。与现有利用多源数据(如新闻、财报、招聘信息)的研究相比,本文的语料范围较窄。
- **方法稳健性与指标解释性**:语义漂移测量依赖 Transformer 嵌入模型的版本与训练语料,不同模型可能产生不同的漂移值,作者未提供敏感性分析。球面 K-Means 的簇数选择虽经附录验证,但 UMAP 降维与聚类结果可能不稳定。两个核心指标(Semantic Centroid Vector Drift 与 Commercialization Offset)缺乏外部基准(如专家标注或已知重大技术事件)的校准,其绝对数值难以跨领域或跨时间直接比较,目前只能作为相对排序工具。
- **因果推断的统计功效与内生性**:VAR 模型使用季度聚合数据,样本量可能不足,导致 Granger 因果检验的功效较低;未能控制可能同时驱动论文发表与计算投资的其他变量(如风险资本流动、政策激励),或使用工具变量缓解内生性。报告“论文量速度不 Granger-cause 计算分配”可能因时间分辨率过粗或遗漏非线性传导而得出过于绝对的结论。尽管作者强调需条件于物理资本约束,但模型设定仍较简单,不能刻画资本约束的动态反馈。