如何循环 MoE:扁平化专家,解绑注意力
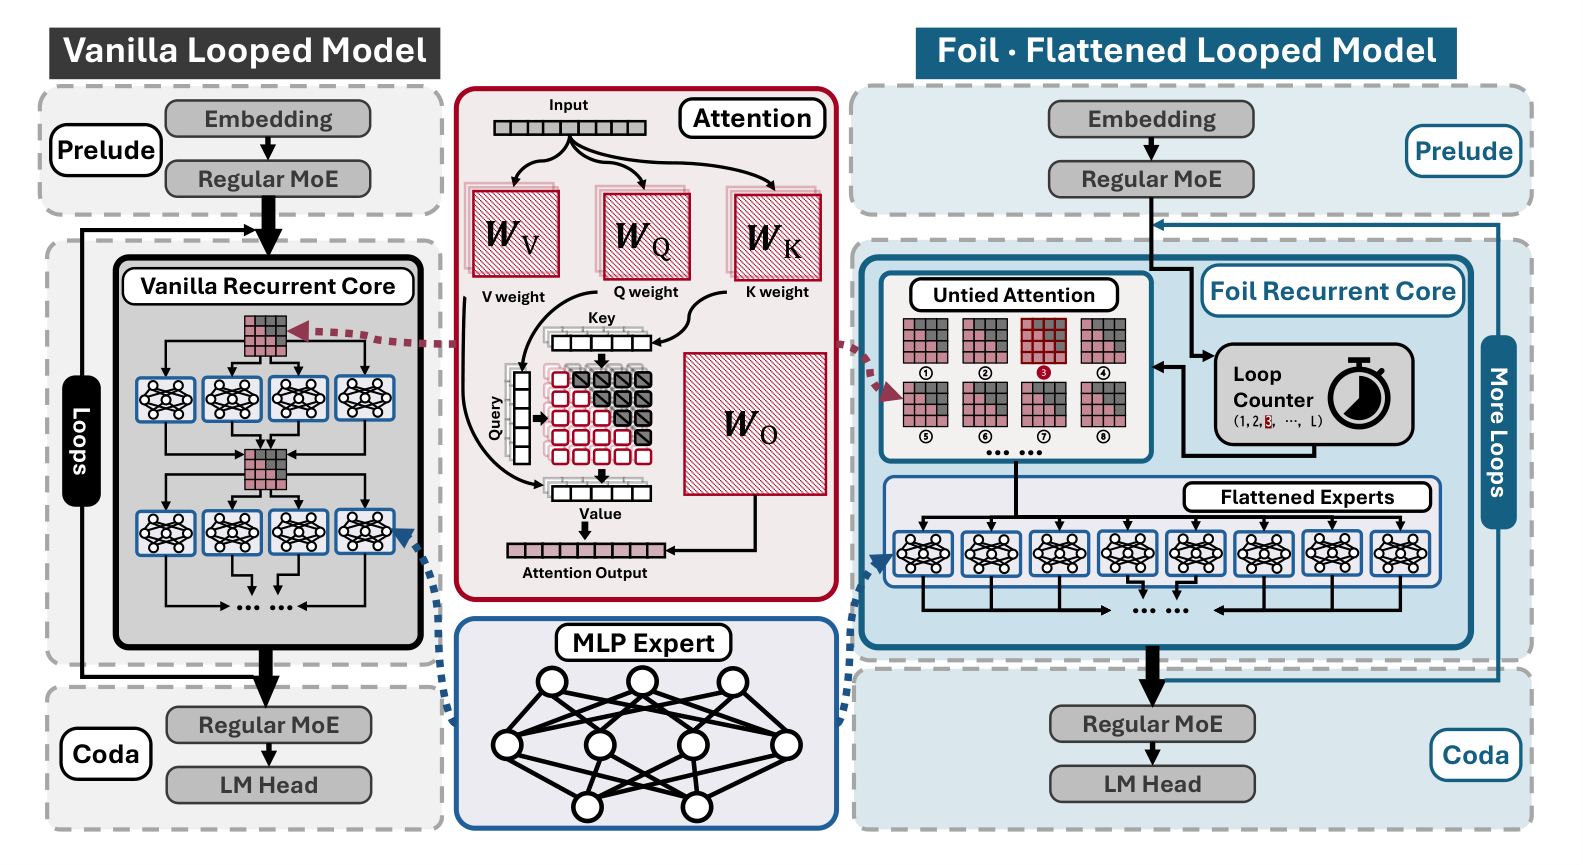
循环 Transformer 多次复用同一层块:以额外计算把固定规模的模型推得更远,从而更充分利用参数;稀疏 MoE 则对每个 token 只激活少数专家。Looped MoE 结合这两种理念,为 MoE 的专家利用带来新潜力,但也引出一个问题:如何对 MoE 做循环?我们以 Foil 作答。 在专家参数与每 token 专家计算量固定的前提下,Foil 做了两件事:(1) 扁平化专家,把专家层数减半、每层专家数翻倍、遍历次数翻倍,使每次路由决策都从更大的候选池中选择;(2) 解绑注意力,让每一遍遍历拥有自己的注意力参数,而专家与路由器保持共享。 实验显示,Foil 明显优于未扁平化的循环基线:在 20B tokens 时,每个 Foil 模型的预训练损失都低于基线;在 100B tokens 时,损失随扁平化程度单调改善,最扁平的 Foil 在同等参数与计算量下最终比基线低 0.012 nat,下游准确率持平或更好;在相同形状下,解绑注意力还带来更均衡、更自信的路由。 消融实验分析了 Foil 为何有效,并将结论转化为循环 MoE 的设计指导:循环与加宽专家层的收益会相互放大,路由置信度比负载均衡更能反映健康的专家使用,因此稀疏循环 MoE 应采用更多每层专家数与更多遍历次数。代码与配置见 https://github.com/SR-A-W/how-to-loop-moe。
论文精读
TL;DR Foil 提出 Looped MoE 新配方:flatten experts 让每层专家翻倍、passes 翻倍以扩大路由池,untie attention 恢复被丢弃的注意力参数,在不增加参数与算力下显著降低预训练 loss 并提升路由置信度。
问题
问题背景
当前高效模型架构研究聚焦于两条路径:稀疏混合专家 (MoE) 通过条件计算激活部分专家来降低推理成本;循环 Transformer (Looped Transformer) 重用同一组层以参数换深度。两者都试图在固定参数预算下提升模型容量。
现有方法局限
直接将 MoE 置入循环块会暴露两个缺陷:
- 共享权重的多次前向传播会累积路由误差,导致专家选择趋于退化,部分专家被过度使用或完全闲置。
- 原始 MoE 中每层专家数量有限,每个 token 只能从较小池中挑选,限制了条件计算的表达能力;若强行增加专家数则需相应增加参数和计算量。
为什么这个问题难/重要
循环机制引入时序依赖,要求路由决策在不同 pass 间既稳定又具多样性,否则会放大负载失衡;同时,专家参数和每 token 计算量固定时,如何在不断扩大模型规模的前提下提升 expert 利用率是核心矛盾。该问题直接影响大模型训练与推理的成本效益,是工程落地中的关键瓶颈。
行业类比
类似于推理引擎用多步迭代复用同一组算子来逼近更深网络表现,例如扩散模型的逐步去噪与动态条件路由的结合,循环 MoE 可能在相同参数量下获得更深层次的特征抽象。
核心洞察
- Foil 的核心发现是 flattening experts 与 looping 的收益互相放大,在固定专家参数和每 token 专家计算预算下,将专家层减半、每层专家数加倍并增加 pass 数,能扩大路由池、提升模型上限。这不同于单纯增加专家数量或加深网络,而是通过结构重排让循环 Transformer 的多次前向在更宽的专家层上反复选择,使有限专家被更多 token 路由覆盖,实验显示 flattening 程度越高,100B token 下的 loss 单调下降。
- routing confidence(MMR)比 load balance 更能指示专家使用的健康度和 looping 的边际收益。传统 MoE 常以负载均衡作为专家利用的代理指标,但该工作发现路由置信度随 pass 增加而衰减,其 per-pass 峰值位置可预测进一步 flattening 或增加 passes 是否还有收益;仅在负载均衡上优化可能掩盖专家坍缩,而 MMR 与 loss 改善的相关性更强,为工程监控提供了更有效的信号。
- untying attention 以零额外激活计算恢复了 flattening 丢弃的注意力参数,并改善了路由行为。在 flattening 将专家层减半后,模型容量受损,但通过为每个 pass 分配独立的注意力参数(专家和路由器保持共享),在不增加 per-token 计算的情况下恢复参数量,实验表明 untied 注意力在所有 shape 下都降低 loss,且路由更均衡、更自信,揭示了稀疏 MoE 循环结构中参数共享与专用化的精细权衡。
方法
输入:给定一个 token 序列,以及固定的资源预算——专家参数总量、每个 token 激活的专家计算量、总训练计算量。目标是设计一种 Looped MoE 结构,在同等预算下获得更好的专家利用与损失表现。
关键模块:
Flatten the experts(展平专家):将 MoE 的专家 FFN 层数减半,同时每层专家数加倍,并让循环次数(passes)加倍。这样每个 token 在每个 pass 中从更大的专家池里做路由决策,但每个 token 激活的专家总数保持不变。通过扩大路由池,缓解了稀疏 MoE 中专家利用率不足的问题。
Untie the attention(解绑注意力):在 Looped Transformer 中,不同 pass 通常共享同一组注意力参数。Foil 改为每个 pass 拥有独立的注意力参数,而专家层和路由器仍然在所有 pass 间共享。这一操作恢复了因展平专家层而“丢弃”的参数量,但不增加每个 token 的额外计算开销(注意力参数量相对较小,对 FLOPs 影响可忽略)。
监控指标:引入三个指标评估专家使用:每个 token 触达的不同专家数、负载均衡度
B_2、以及中位边缘比(MMR) 衡量的路由置信度。这些指标用于诊断专家坍缩和路由健康度。
输出:训练后的模型在相同参数和计算量下,预训练损失更低;随着展平程度增加,损失单调改善;下游任务准确率与基线持平或更好。同时路由更均衡、置信度更高。
差异点:与简单将 Looped Transformer 与 MoE 叠加的方法不同,Foil 通过同时展平专家和解绑注意力,让“加宽专家层”和“增加循环次数”的收益相互放大,而不是单独调整某一维度。
实验
实验设计
论文在同等参数量和计算量约束下,对比 Foil 与未扁平化的循环 MoE 基线。预训练分别在 20B 和 100B tokens 上进行,并评估下游任务性能。同时研究了解绑注意力对于路由行为的影响。
关键发现
- 在 20B tokens 时,所有 Foil 模型的预训练损失均低于基线。
- 在 100B tokens 时,损失随扁平化程度单调改善,最扁平的 Foil 最终损失比基线低 0.012 nat,且下游准确率与基线相当或更好。
- 解绑注意力在相同模型形状下带来更均衡、更自信的路由。
与基线对比解读
结果表明,循环机制与专家层宽度之间存在放大效应:扁平化扩大了路由池,使每个 pass 能从更多专家中选择,而解绑注意力赋予每个 pass 独立的注意力参数,在不增加每 token 计算的前提下恢复了被扁平化舍弃的参数容量。路由置信度随循环增益同步下降的现象提示,路由置信度可作为循环 MoE 健康程度的有效指标,比单纯负载均衡更能预测性能收益。
行业影响
落地场景
Foil 为循环 MoE 架构提供了明确设计准则,适用于任何已采用 MoE 的大规模语言模型或多模态模型。典型场景包括:
- 电商智能客服:基于 MoE 的对话模型在固定推理预算下提升回答准确率与多样性,减少人工转接。
- 内容平台审核:多专家模型处理多模态内容(文本、图像、视频),展平专家层使路由池扩大,提升审核精度与稳定性。
商业价值
在相同参数与计算预算下,Foil 能降低预训练损失并保持或提升下游准确率。这意味着:
- 降本:无需增加总参数量即可获得更强模型,减少训练和推理硬件成本。
- 体验提升:更多专家参与决策,路由更自信、更均衡,减少专家崩溃风险,提高服务稳定性。
与现有产品/工作流集成
- 训练侧:在现有 MoE 训练框架中,将专家层展平为更宽、更少的层,并增加循环次数;注意力参数改为每遍独立,专家与路由器共享。
- 推理侧:循环块可静态展开为深网络,兼容现有推理引擎;引入循环后需优化迭代控制开销(如使用
CUDA Graph)。 - 参考实现:GitHub。
局限
- **实验规模与模型容量有限**:论文仅在 20B 和 100B token 规模下验证,模型参数量未达到数十亿级,无法完全反映大规模生产环境下的行为。循环 MoE 的收益可能随模型规模增大而变化,且实验主要基于预训练损失和有限下游任务评估,缺乏长上下文、多语言或指令跟随等任务的系统验证。此外,flatten 操作会增加单层专家数,在分布式训练中可能引入更高的通信开销和负载均衡压力,论文未讨论这些工程约束。
- **与现有循环 Transformer 变体的对比不充分**:论文主要与未扁平化的循环基线比较,未系统对比其他循环策略(如 depth-wise 循环、权重共享的不同模式)或与更高效的路由机制(如 expert choice routing、soft MoE)结合的效果。虽然通过消融给出设计建议,但缺乏在标准 benchmark 上与强基线(如 Switch Transformer、Mixtral 架构的循环版本)的直接对比,这限制了 Foil 在更广泛 MoE 设计空间中的定位。
- **解绑注意力的收益条件未完全厘清**:论文指出 untied attention 在更扁平的结构中收益更大,但未深入分析其作用机理(例如是否因为不同循环层需要不同的位置编码或上下文依赖)。同时,解绑注意力增加了参数量,在严格参数匹配的对比中可能掩盖了 flatten 本身的贡献。此外,路由置信度指标(MMR)与最终性能的关系是相关性而非因果性,依赖该指标指导架构搜索可能存在误导风险。