VLA 强化学习的低秩结构
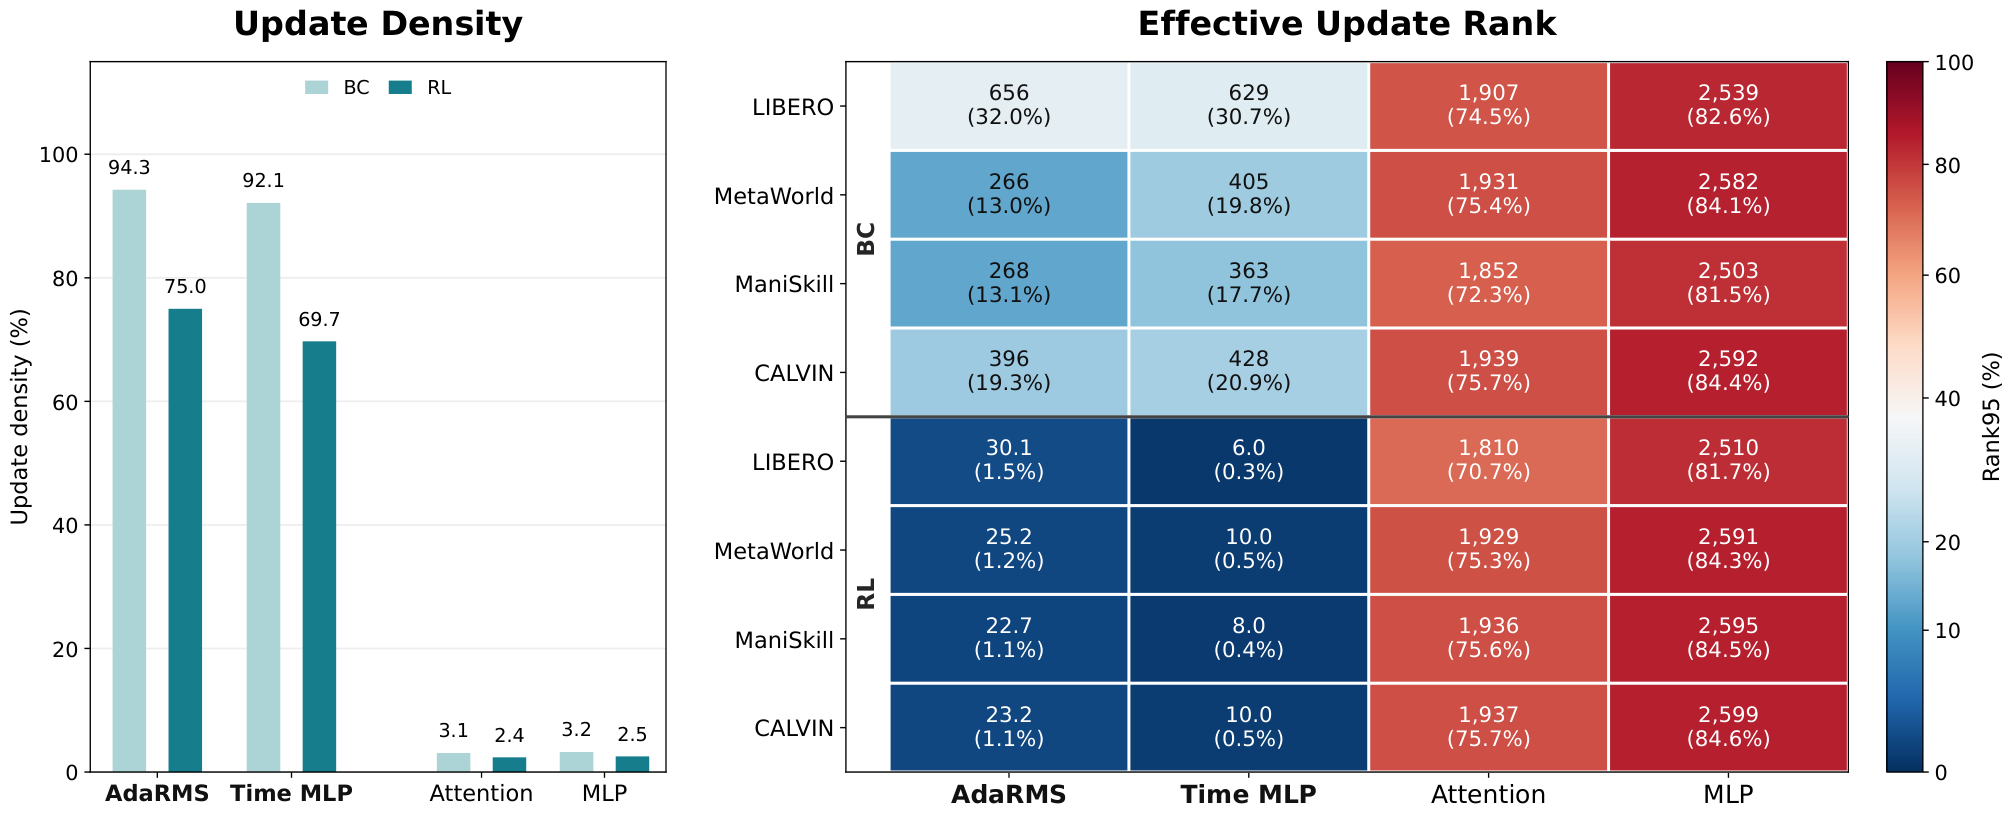
强化学习(RL)正被越来越多地用于 VLA 模型的 post-training,但 RL 如何重塑这些策略仍缺乏理解。作者发现,在 LIBERO、ManiSkill、MetaWorld 和 CALVIN 上对主流 flow-based VLA 模型(包括 π{0.5} 与 GR00T N1.5/N1.6)做 RL,会诱导出显著更低秩的参数更新,且高度集中于 action expert 的 Timestep Modules 这一此前被忽视的小组件。 通过系统性的模块替换实验,作者进一步表明这些模块占据了 RL 性能增益中不成比例的份额,并刻画了其中编码的内容: 1. RL 使其专门适配 rollout 时使用的离散去噪 timestep,而这种离散 timestep 训练正是低秩更新的来源; 2. 在其输出中,shift vector 在 RL 下变化最明显,探针实验显示 shift 更新方向能强力预测任务成功(ROC-AUC 最高 99.6%); 3. shift 更新的几何结构反映任务关系,其成对相似度与跨任务迁移模式相关。 基于这些发现,沿 shift 更新方向进行 steering 可在不额外做 RL 训练的情况下进一步提升 RL 训练后的策略。总体而言,该工作通过研究学习到的信号如何在参数空间中被编码,系统理解了 RL 如何重塑 VLA 策略,为更高效、更可解释的 VLA post-training 提供了洞见。
论文精读
TL;DR RL 微调 VLA 模型的参数更新呈低秩且集中于 action expert 的 Timestep Modules;该模块编码任务成败与关系,无需额外 RL 训练即可引导策略进一步提升。
问题
问题背景
当前机器人基础模型领域重点关注 VLA 模型 的强化学习后训练,以提升操控策略在真实环境中的成功率。
现有方法局限
现有 RL 后训练通常只报告整体成功率提升,很少分析参数更新的结构与功能定位。主流做法是对全模型做微调或加 LoRA,但这忽略了更新在参数空间中的低秩与稀疏特性,导致计算冗余且缺乏可解释性。尤其对于 flow-based VLA 内部的 Timestep Modules 这类小组件,其关键作用此前未被识别。
为什么这个问题难/重要
VLA 模型参数量巨大,RL 更新信号稀疏且集中在极少参数上,直接全量分析代价高;同时,如何定位真正驱动性能提升的子结构,对高效微调和模型诊断至关重要。若无法理解更新编码的信息,就难以设计更轻量的后训练方案或进行可控策略编辑。业界对 VLA 后训练效率与可解释性的需求持续上升。
行业类比
类似 LLM 中 LoRA 发现低秩适配 有效降低微调成本,VLA RL 的低秩结构若被利用,有望发展出机器人策略专用的参数高效更新方法。
核心洞察
- RL 在 flow-based VLA 模型上的参数更新并非均匀分布,而是高度低秩且集中在一个此前被忽视的小组件——action expert 的 **Timestep Modules**。这与以往研究多关注整体 policy 变化或使用隐空间 probing 不同,本文通过系统模块替换实验量化了该模块对 RL 性能增益的贡献(占比不成比例),为理解 VLA 后训练提供了参数空间层面的因果证据,也为高效微调(如仅更新少量参数)提供了明确靶点。
- Timestep Modules 输出的 **shift 向量** 在 RL 后发生最显著变化,且可被低维探针以极高 ROC-AUC (99.6%) 解码为任务成功信号;更进一步,其几何相似性与跨任务迁移模式相关,并可沿 shift 方向进行 steering 进一步提升 RL 策略,无需额外 RL 训练。这超越了传统可解释性工作中对隐空间表征的静态分析,将 interpretability 与 actionable policy manipulation 直接挂钩,为 VLA 的可控后训练提供了新范式。
方法
分析框架概览
本文方法聚焦于解析 RL 后训练对 VLA 模型(如 π₀.₅、GR00T N1.5/N1.6)的参数更新结构,并利用发现的规律进行策略改进。整体流程遵循:输入 RL 训练前后模型参数 → 识别关键更新模块 → 表征模块编码内容 → 输出可操作的 steering 策略。
1. 参数更新的低秩与模块定位
首先对比 RL 前、后模型参数的差分矩阵,通过低秩近似(如 SVD 重构误差)量化更新的秩。实验发现跨 LIBERO、ManiSkill、MetaWorld、CALVIN 多环境的更新均呈现显著低秩特性。进一步使用模块级敏感性分析,定位更新集中在 Action Expert 的 Timestep Modules(时间步模块,包含 Time MLP、AdaRMS、AdaLayerNorm 等结构),该模块参数量极少但更新幅度远超其他部分。
2. 模块替换实验验证增益归属
为证明 Timestep Modules 承载 RL 性能增益,作者进行系统性模块替换:将 RL 后模型中除 Timestep Modules 外的所有参数回退到预训练权重,保留 Timestep Modules 的 RL 更新;再反向操作。对比两种配置的任务成功率,确认 Timestep Modules 对增益贡献不成比例。
3. 表征 Timestep Modules 编码内容
- 离散时间步特化:分析模块输入输出对去噪时间步的响应,发现 RL 使模块对 rollout 中实际使用的离散时间步更敏感,且该特化与低秩更新互为因果。
- Shift / Scale / Gate 分解:将模块输出分解为 shift(平移)、scale(缩放)、gate(门控)三个分量,对比 RL 前后变化,发现 shift 向量 变化最显著。
- Shift 向量探测:训练线性探针预测任务成功与否,ROC-AUC 最高 99.6%;并分析 shift 更新方向的成对相似度与跨任务迁移模式的相关性,揭示其几何编码任务关系。
4. 基于 Shift 的无训练 Steering
利用已学到的 shift 更新方向,在推理时对动作专家输出施加额外偏移(steering),无需进一步 RL 训练即可提升策略表现。
与同类 RL 可解释性工作不同,本文不是分析激活或注意力,而是直接研究参数更新本身的低秩结构,并锁定一个极小但关键的时间步模块,最终将发现转化为可实现的 steering 增益。
实验
实验设计
在四个机器人操作基准 LIBERO、ManiSkill、MetaWorld、CALVIN 上对 flow-based VLA 模型(π0.5、GR00T N1.5/N1.6)进行 RL 后训练,重点分析参数更新的低秩结构与模块分布。通过系统模块替换实验验证 Timestep Modules 的贡献,并利用 probing 与 steering 分析 shift 向量。
关键发现
RL 引起的参数更新在 action expert 的 Timestep Modules 中高度集中且低秩;离散 denoising timesteps 的训练是低秩更新的根源。在 Timestep Modules 的输出中,shift 向量 变化最显著,探测其更新方向预测任务成功的 ROC-AUC 最高达 99.6%。shift 更新的几何结构编码任务关系,其 pairwise similarity 与跨任务迁移模式相关。沿 shift 更新方向 steering 可以进一步提升 RL 训练后的策略。
对比解读
相比全参数更新或随机模块,Timestep Modules 以极少参数量捕获 RL 大部分性能增益,挑战了以往对整个 VLA 网络均匀微调的假设。该方法将 RL 对 VLA 的改造定位于可解释的特定子模块,为高效后训练(如仅更新 Timestep Modules)和策略行为分析提供了新路径。
行业影响
落地场景
论文揭示 VLA 模型(如 π0.5、GR00T N1.5/N1.6)经 RL 后训练,参数更新高度集中在 Timestep Modules 且呈低秩结构。这直接支持机器人操作、自动驾驶末端操控、仓储物流等场景的轻量化适配。例如,电商仓库拣选机器人只需针对新的 SKU 或货架布局,低秩更新 Timestep Modules,即可快速迁移策略;家庭服务机器人在新任务上可利用 shift update steering 在推理时提升成功率,无需额外 RL 训练。
商业价值
- 降本:将 RL 后训练从全参微调压缩为对
Timestep Modules的低秩适配(如 LoRA),极大减少可训练参数量与 GPU 时成本。 - 提效:利用 shift update 方向作为任务成功预测器(ROC-AUC 最高 99.6%),可实现策略性能的在线监控与预警,缩短部署迭代周期。
- 体验优化:机器人操作稳定性提升,减少人工干预,提高自动化程度,直接改善电商物流和服务的运营效率。
与现有产品/工作流的接口
- 训练阶段:在 VLA 后训练 pipeline 中,仅对
Timestep Modules插入低秩适配器,替代全参 RL 微调,可无缝集成到现有 RLHF/RLVR 框架。 - 推理阶段:将离线提取的 shift update 方向作为 steering vector,在模型输出层注入,无需重新训练权重,支持热插拔与 A/B 测试。
- 监控系统:基于 shift update 方向构建性能预测模块,实时评估策略在当前任务上的成功率,用于安全关键型应用的决策。
具体 use case:在自动驾驶的末端操控策略中,针对不同停车场或泊车环境,用 steering 注入特定 shift 方向,无需重训模型即可提升成功率;在电商仓储机器人中,针对新增商品品类快速低秩更新 Timestep Modules,降低重复 RL 训练成本,加快上线速度。
局限
- 论文的分析集中在 **flow-based VLA** 架构(如 π₀.₅、GR00T N1.5/N1.6),尚不清楚结论是否适用于 diffusion-based 或其他生成式策略模型。实验虽覆盖多个 benchmark(LIBERO、ManiSkill、MetaWorld、CALVIN),但均为模拟操作任务,真实机器人部署下的参数更新模式可能受视觉扰动、动作延迟等因素影响。
- 论文指出 RL 诱导的低秩更新源于**离散去噪时间步**的训练,但实际推理中常采用连续时间步或不同采样步数,这一差异可能削弱 Timestep Modules 的专门化效果。此外,作者未充分对比不同 RL 算法(如 PPO、DPO、REINFORCE)对低秩结构的影响,结论的普适性有待验证。
- 虽然 Timestep Modules 参数占比极小,但论文未分析其低秩更新对模型其他部分(如视觉编码器、语言模型)的间接影响,也未探讨在多任务持续学习场景下,这种集中更新是否会导致灾难性遗忘或干扰既有技能。