大语言模型的 On-Policy Distillation 真的需要 KL Divergence 吗?
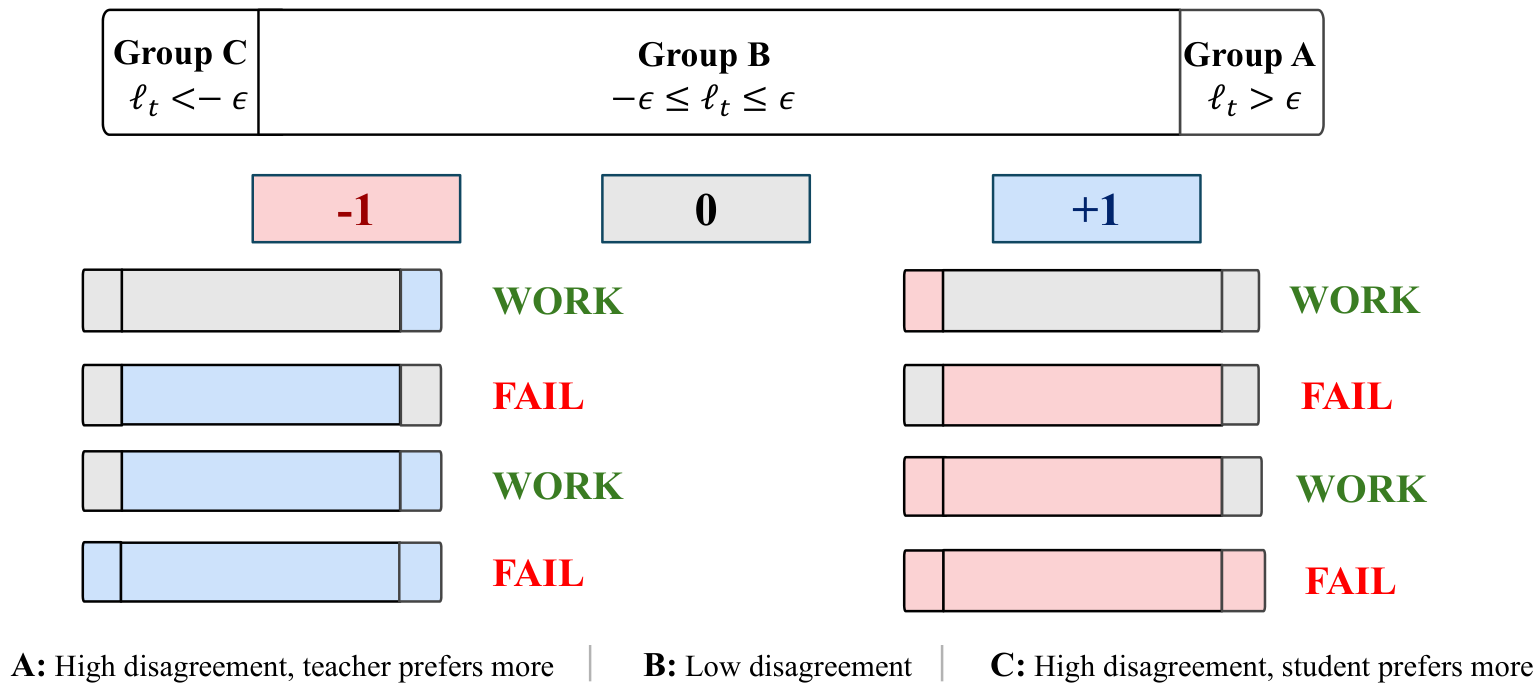
自 knowledge distillation 诞生以来,KL divergence 一直是蒸馏的标准损失。近期 on-policy distillation(OPD) 成为 LLM 的高效后训练范式,作为蒸馏方法自然继承了 KL divergence。但本工作发现,KL divergence 对 OPD 或许并非必要。 作者表明,只要保持更新方向,OPD 就能有效工作。关键不在每个 token 的方向,而在于 teacher 与 student 分歧强烈的少数 token 的方向: - 仅给 teacher 概率高于 student 的 token 赋奖励 +1、低于的赋 -1,即只鼓励朝 teacher 更新,就能复现与 reverse KL 版 OPD 几乎相同的训练模式; - 只有分歧较大的少数 token 方向至关重要,只要它们朝 teacher 更新,即使其他 token 被拉离 teacher,训练依然有效。 作为上述发现的应用,作者提出 Consensus Multi-Teacher On-Policy Distillation(C-MOPD) 来改进 Multi-Teacher On-Policy Distillation(MOPD)。与 MOPD 将每个样本路由到单一 teacher、可能造成跨领域能力冲突不同,C-MOPD 让每个样本受所有 teacher 监督。实验显示,C-MOPD 在 math 与 code 基准上稳定优于 MOPD。
论文精读
TL;DR 发现LLM在线策略蒸馏无需KL散度,只需更新方向朝向教师的高分歧token即可;据此提出的多教师共识蒸馏C-MOPD在数学与代码上均优于MOPD。
问题
问题背景
近年来,知识蒸馏(Knowledge Distillation)在大型语言模型(LLM)后训练中成为高效范式,特别是 On-Policy Distillation (OPD) 通过在线采样学生策略并与教师分布对齐,避免了大规模离线数据依赖。KL 散度 一直作为蒸馏的标准损失函数被广泛沿用。
现有方法局限
当前 OPD 普遍采用 reverse KL 作为损失,强制学生模型在每个 token 上逼近教师的完整概率分布。这种做法存在明显局限:
- 计算与优化负担:需要维护教师 logits,对每个 token 计算概率分布差异,计算开销大,尤其影响长序列训练效率。
- 过度对齐:并非所有 token 都同等重要,强制全 token 对齐可能引入噪声,甚至阻碍学生表达自身能力。
- 多教师场景:Multi-Teacher OPD (MOPD) 通常将每个样本路由给单一教师,导致不同教师之间的能力冲突(如数学 vs 代码),学生难以同时继承多领域优势。
为什么这个问题难/重要
蒸馏有效性的核心机制尚不清晰:是概率分布匹配的强度,还是仅仅更新方向朝向教师?论文实验发现,仅用 二元奖励(+1/-1 指示教师概率是否高于学生)即可复现 reverse KL 的 OPD 效果,说明 更新方向比分布距离更重要。进一步,只有少数 高分歧 token(教师与学生分歧大的 token)的更新方向才是关键。这一发现挑战了传统 KL 的必要性,为设计更轻量、更鲁棒的蒸馏方法提供了新视角。业界对 LLM 后训练的计算效率和跨领域泛化有极高需求,任何简化损失而不损失性能的方案都具实际价值。
行业类比
类似在 代码生成模型蒸馏 中,教师与学生在关键逻辑 token 上分歧大,只需修正这些 token 的更新方向,就能避免冗余的全局对齐,减少显存占用,支持更大 batch 或更长序列,提升多任务推理模型训练效率。
核心洞察
- 在 On-Policy Distillation (OPD) 中,KL 散度并非必需,只需二进制奖励保持更新方向朝向教师即可复现反向 KL 的训练行为。该视角将问题从精确匹配 teacher-student 分布简化为符号化方向信号(+1/-1),区别于传统蒸馏依赖 KL 的连续概率对齐。这一简化揭示了 OPD 对损失函数形式的鲁棒性,为工程实现提供了更简单、低方差的替代方案,同时避免了 KL 计算中可能出现的数值不稳定或模式坍缩风险。
- 对 OPD 起决定作用的是少量 teacher-student 高分歧 token 的更新方向,而非所有 token 的平均方向。该发现与常规 token 级均匀加权的蒸馏损失形成鲜明对比:只要这些关键 token 朝向教师更新,其余 token 即使被拉离教师也不影响性能。基于此,作者提出多教师场景下的 Consensus Multi-Teacher On-Policy Distillation (C-MOPD),让每个样本由所有教师共同监督,避免单教师路由造成的领域能力冲突,在 math 和 code 基准上稳定超越 MOPD。
方法
方法概述
输入:学生模型、教师模型(单个或多个)、提示数据集。
关键模块:
- 二值奖励替代 KL 散度:对每个 token 计算教师概率与学生概率之差,仅保留符号,转换为
+1/-1奖励信号,用于策略梯度更新。 - 高分歧 token 筛选:分析表明训练主要依赖于教师-学生概率差距大的少量 token,对这些 token 保持朝向教师的更新方向即可,其他 token 方向影响甚微。
- 多教师共识蒸馏 (C-MOPD):将多个教师模型的输出融合,让每个样本接受所有教师的监督,而非传统 MOPD 中将样本路由至单一教师,避免领域能力冲突。
输出:更新后的学生模型,在数学与代码基准上性能提升。
与同类方法的差异:颠覆了蒸馏中 KL 散度必需的传统认知,以极简的符号奖励实现有效在线策略蒸馏,并首次在多教师场景下提出共识监督策略,性能优于逐样本路由的 MOPD。
实验
实验设计
- 对比基线 包括标准 OPD with reverse KL 与提出的 BinaryOPD(仅保留教师方向更新,token 级 +1/-1 奖励)。
- 验证高分歧 token 子集关键性:仅保留高分歧 token 的更新方向,其余 token 反向或忽略,观察性能变化。
- 多教师扩展:在 MOPD 基础上提出 Consensus Multi-Teacher OPD (C-MOPD),让每个样本由所有教师共同监督,而非路由到单一教师。
- 评估领域:数学与代码基准(具体数据集名称未在摘要中列出)。
关键发现
- BinaryOPD 几乎复现 reverse KL OPD 的训练模式,表明 KL 散度并非必需。
- 仅保留高分歧 token 的更新方向即可有效蒸馏,其余 token 的更新方向影响很小。
- C-MOPD 在数学与代码基准上一致优于 MOPD,证明共识监督缓解了跨域能力冲突。
- 作者通过 repeated-feedback 视角解释 BinaryOPD 有效性:教师概率差提供重复反馈信号。
基线对比解读
- BinaryOPD 相比 reverse KL 实现更简单,无需计算 log 概率比值,计算开销更低,且性能相当。
- C-MOPD 相对 MOPD 的增益来自消除单教师路由导致的 domain conflict,多教师共识监督使模型同时吸收多域能力。
- 该工作挑战了知识蒸馏中长期默认的 KL 散度假设,实际工程中可简化 on-policy 蒸馏损失函数设计,降低实现复杂度。
行业影响
落地场景
On-Policy Distillation (OPD) 在不需要 KL 散度 的情况下,用简单的 Teacher-Directional Updates 就能完成大模型压缩,适合边端推理和垂直领域模型微调。典型场景:
- 电商智能客服:将多教师(商品知识、对话策略、合规审核)通过 C-MOPD 共同监督每个样本,消除跨域能力冲突,生成更一致且安全的回复。
- 代码助手 / 编程教育:用数学 + 代码多位教师 consensus 蒸馏,小参数模型保持高解题准确率,可嵌入 IDE 或在线判题系统。
商业价值
- 降本:KL-free 方法省去精确概率匹配,训练更高效;蒸馏后的小模型显著降低推理 GPU 成本,适合高并发场景。
- 体验提升:多教师共识减少能力冲突,避免单一教师偏置,在跨域对话中回复更稳定。
- 增收:更小模型可部署到更多端侧 / 浏览器插件产品,扩大付费订阅或 API 调用场景。
与现有工作流接口
- 替换损失函数:现有 RLHF / DPO 后训练流程中,将 reverse KL 换成基于 token 概率高低的 binary reward(
+1/-1),无需改动采样和 on-policy 循环。 - 多教师融合:从 MOPD 的 sample-wise routing 改为 C-MOPD 的 all-teacher supervision,保持原有数据 pipeline,只调整监督聚合方式。
- 参考实现: KL-Free-OPD,可直接集成到 Hugging Face TRL 等训练栈。
局限
- 论文的实验主要基于 math 和 code 基准(如 GSM8K、MATH、HumanEval、MBPP),未涉及通用问答、推理或安全对齐等任务。因此,BinaryOPD 和 C-MOPD 的有效性可能局限于特定领域,泛化到更广泛的 LLM 能力(如指令跟随、多轮对话)还需要进一步验证。此外,论文使用的教师模型与学生模型规模差异有限,未系统探索在大规模模型(如 70B 以上)上的扩展性。
- BinaryOPD 将 token 级奖励简化为 +1/-1,丢弃了 KL 散度中的概率幅度信息。虽然实验表明这种稀疏奖励足以保持更新方向,但在需要精细概率校准的任务(如开放式文本生成、可控生成)中,完全忽略幅度可能损害分布匹配质量。论文未分析 BinaryOPD 在生成多样性或困惑度等指标上的影响,也未与温度调节的 KL 变体进行对比。
- C-MOPD 的 multi-teacher 聚合方式仅用平均 logits,未考虑不同教师之间的权重分配或冲突解决机制。当教师模型对同一 token 产生相反的高置信度预测时,简单平均可能引入噪声。论文未与更复杂的集成方法(如加权投票、不确定性加权)对比,也未分析教师数量增加时的边际收益和计算开销。