以证据对齐读出学习多模态嵌入
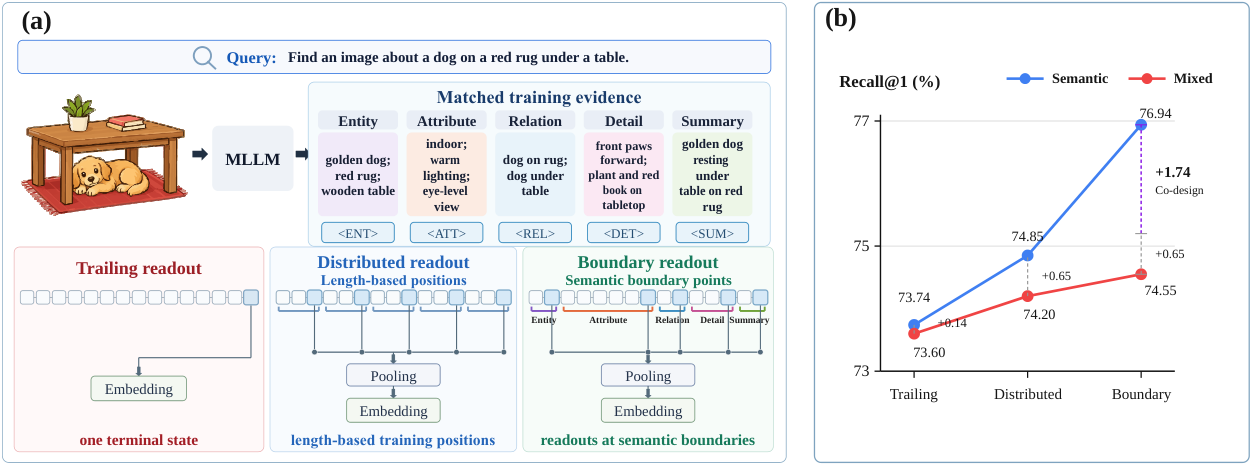
多模态大语言模型能通过生成暴露与任务相关的证据,但生成有用证据本身并不决定它如何进入检索嵌入。我们研究证据的语义组织是否也能指定表征的读取位置。 为此,我们提出 EviAlign,它在同一个多模态大语言模型中把 语义证据生成 与 边界读出 耦合起来:将证据组织为五个语义单元,在每个单元边界读取上下文状态,并把这些状态聚合为单个归一化嵌入。生成与对比检索目标联合训练这一共享结构。在相同的尾部读出下,语义证据与自由形式 CoT 取得几乎一致的检索性能,说明仅凭证据组织无法解释全部增益。 一项受控的 2×3 研究比较了一致与置换的证据组织在三种读出策略下的表现,所用训练目标具有匹配的证据跨度。在使用五个读出状态和相同均值池化时,一致语义组织的优势从基于长度的训练位置的 0.65 分增长到证据边界的 2.39 分,形成 1.74 分的协同设计交互。 在 12 个 MMEB 检索任务上,EviAlign 以 500K 训练对达到 76.9 平均 Recall@1,同时保留单向量索引与打分。
论文精读
TL;DR EviAlign 让多模态大模型生成五段式语义证据,并在证据边界处读出表征,通过生成与对比检索联合训练,跨 12 个检索任务以 50 万训练对达到 76.9 R@1。
问题
问题背景
多模态检索嵌入学习当前关注如何利用大模型生成任务相关证据(如推理链、属性描述)来增强表示质量。生成式嵌入方法通过先“思考”再输出嵌入,在多个基准上取得显著提升。
现有方法局限
多数方法将生成证据视为自由文本,仅在序列末尾读取单个表示,或使用简单平均池化。证据内部的语义边界(如从“对象”到“属性”到“关系”的过渡)未被显式利用,导致表示构建与证据组织脱节。即便生成了高质量证据,如果读取位置不当,性能增益也会被稀释。论文实验显示,将证据打乱顺序后,长度相同但语义混乱的文本在尾部读取下与有序证据性能接近,说明传统读取策略对语义顺序不敏感。
为什么这个问题难/重要
难在需要联合设计证据生成格式与表示读取策略,两者存在非平凡的协同空间。控制实验表明,一致语义组织在证据边界读取时增益从 0.65 点提升至 2.39 点,交互作用 1.74 点。业界关注点在于:在不牺牲单向量索引和评分效率的前提下,如何最大化生成证据的表示价值。这直接影响多模态搜索、跨模态检索等实际系统的召回率与延迟。
行业类比
类似 RAG 流水线 中,将检索文档按语义块边界组织并逐块编码,比简单截断或整篇末尾编码更能保留关键信息,提升下游问答质量。
核心洞察
- 证据组织与读取位置的联合设计是提升多模态检索嵌入质量的关键:在证据单元边界读取上下文状态,而非固定长度位置或尾部直接池化。与多数生成增强嵌入方法仅优化证据内容或聚合方式不同,EviAlign 将语义分段与读取时机显式对齐,控制实验显示边界读取比长度位置读取多出 2.39 点增益,共设计交互作用达 1.74 点,证明证据结构与读取位置的协同不可忽视。
- 语义证据与自由形式 CoT 在相同尾部读取下检索性能几乎相同,暗示证据组织的贡献并非来自文本内容本身,而是为读取提供了稳定的语义边界锚点。这一发现挑战了“生成高质量推理文本即可改善检索”的常见假设,说明后续工作应更关注如何定义和利用证据边界来构造读取位置,而非单纯改进生成文本的语义质量。
方法
EviAlign 面向多模态检索,输入为图像与文本组合的查询,输出单一归一化嵌入,用于候选库的近似最近邻检索。
关键模块与流程
- 共享骨干模型:使用一个多模态大语言模型(MLLM)同时负责证据生成与表征编码,参数完全共享。
- Semantic Evidence Generation:模型被引导生成结构化证据,将任务相关依据组织为五个语义单元(如实体、属性、关系、场景等),每个单元有明确的文本边界。
- Boundary Readout:在每个语义单元结束处读取模型的隐藏状态,而非只在序列末尾读取。获得五个上下文表示。
- 聚合与归一化:五个边界状态通过平均池化聚合,再做 L2 归一化,得到最终嵌入向量。
- 联合训练:使用两个目标——证据生成的交叉熵损失与对比检索损失(正样本拉近、负样本推远),共同优化共享模型参数。
- 推理:仅需一次前向生成证据并读取边界状态,无需额外索引结构,保持单向量评分。
控制实验表明,一致语义组织与证据边界读出的协同设计比在长度固定位置读出的方式提升 1.74 点 Recall@1,验证了证据结构与读出位置对齐的必要性。
与同类方法的差异
EviAlign 将证据的语义组织与表征读出位置显式绑定,证据边界即读出点;而先前生成增强嵌入方法多是在证据生成后仅取末尾隐藏状态,或使用与语义无关的固定读出策略,缺乏这种协同设计。
实验
实验设计
EviAlign 在 12 个 MMEB retrieval tasks 上训练,使用 500K training pairs。模型将证据组织为五个语义单元,读取每个单元边界处的 contextualized state,并聚合为单一 normalized embedding。生成与对比检索目标联合训练。
关键发现
与相同的 trailing readout 相比,语义证据与 free-form CoT 检索性能几乎一致,说明证据组织本身不能完全解释增益。受控 2×3 研究比较了 consistent/permuted 证据组织在三种 readout 策略下的表现:在五个 readout states 和相同 mean pooling 下,一致语义组织在 length-based training positions 上优势仅 0.65 点,而在 evidence boundaries 上达到 2.39 点,产生 1.74 点 co-design interaction。在 12 个 MMEB retrieval tasks 上,EviAlign 以 500K training pairs 达到 76.9 average Recall@1,且保持 single-vector indexing 和 scoring。
与基线对比
EviAlign 与 generation-enhanced embedding 方法(如 Think-Then-Embed, PLUME, LaME)不同,强调 evidence 组织与 readout 位置的协同设计。实验表明仅生成证据不足以提升检索,必须将 readout 与证据边界对齐才能获得最大增益。这种 co-design 在保持推理效率的同时,避免了复杂多向量索引,对实际部署有启示。
行业影响
落地场景
EviAlign 适用于多模态检索 为核心的产品:电商平台的图文商品搜索、内容平台的视频封面检索、企业知识库的跨模态文档问答。例如,电商场景中用户上传街拍图,系统需检索同款或相似商品;EviAlign 通过生成结构化证据(颜色、材质、款式等语义单元)并读取对应边界表示,可提升检索召回率。内容平台也可用其根据文本描述检索视频关键帧,增强推荐与搜索体验。
商业价值
核心价值在降本 与体验提升:单向量索引避免多向量存储开销,500K 训练对即可达到 76.9 Recall@1,相比需要更大数据或复杂索引的方案,训练和推理成本更低。检索精度提升直接减少用户翻页、提升转化率;同时生成证据可解释,便于审核和调试,降低人工校验成本。
与现有工作流集成
EviAlign 输出为单向量,可无缝替换现有 CLIP/BLIP 类 embedding 模型,接入向量数据库(FAISS、Milvus)做 ANN 检索。推理时,生成证据的额外开销可通过缓存或异步生成优化;训练阶段可与现有对比学习框架(如 InfoNCE)结合,无需改动索引结构。对于已有 RAG 流水线,EviAlign 可作为多模态文档检索器,在检索后接 LLM 生成答案,证据结构还能作为中间解释输出。
局限
- 生成依赖性带来的开销:EviAlign 依赖多模态 LLM 在训练和推理阶段生成结构化语义证据,这不仅增加了额外的推理时间和计算成本,还使得嵌入质量受限于生成证据的准确性与一致性。若上游生成模型对某些查询产生低质量或格式错误的证据,边界读出将无法稳定捕获有效语义,导致检索性能退化。
- 提升幅度有限且基准范围较窄:论文报告的协同设计交互增益为 1.74 点,从 0.65 提升到 2.39,虽然统计上显著,但绝对提升并不突出;实验仅在 12 个 MMEB 基准上展开,训练数据规模为 500K 对,未验证更大规模数据或更多样化任务下的可扩展性和鲁棒性。
- 超参数敏感性和单向量限制:证据单元数量固定为 5,语义边界依赖 LLM 的划分,对于非结构化或复杂跨模态输入可能难以泛化;同时采用单向量索引虽保持高效,但可能牺牲对细粒度匹配的表达能力,在需要复杂多义性建模的场景中不及多向量方法。