MinkowskiPE: 用于时空感知的 Minkowski 位置编码
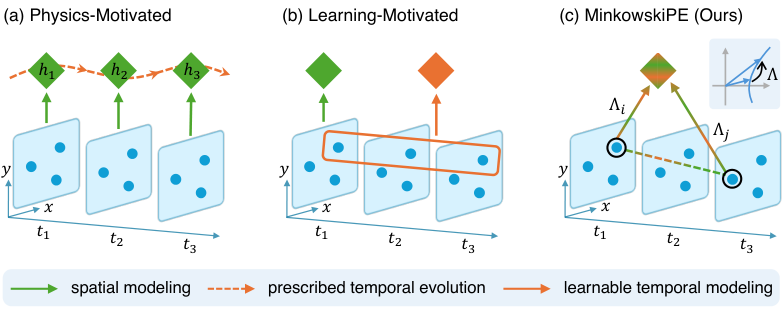
时空耦合 建模是构建跨尺度(从微观到宏观)物理智能的核心挑战。现有模型大致分为两类: - 物理驱动的方法:先验更强,但可能限制灵活性; - 学习驱动的方法:更灵活,但时空耦合大多隐含在模型中。 为此,本文提出 Minkowski Positional Encoding(MinkowskiPE),用联合的时空坐标参数化施加在 query 和 key 特征上的 Lorentz 变换。在该编码下,query-key 注意力分数仅通过两个 token 之间的相对时空位移依赖位置,因而对坐标的全局平移具有不变性。这一范式保留了标准点积注意力接口,并与高效注意力实现兼容。 实验上,作者在微观的 分子动力学 与宏观的 视频预测 任务上评估 MinkowskiPE:在全部九项多轨迹分子评测中取得最佳结果,并将 KTH 视频预测的 MSE 相对最佳基线降低 9.9%,而参数量仅约为其十分之一。
论文精读
TL;DR MinkowskiPE 用闵可夫斯基时空坐标参数化 Lorentz 变换,使注意力仅依赖相对时空位移,在分子动力学与视频预测上以约 1/10 参数取得最佳结果,KTH MSE 降低 9.9%。
问题
问题背景
物理智能建模中,跨尺度时空耦合是核心挑战:从微观分子动力学到宏观视频预测,模型需同时编码时间与空间的联合依赖关系。
现有方法局限
- 物理驱动的动力学公式 提供强先验,但往往约束了数据驱动的灵活性,难以适配复杂真实场景。
- 学习驱动的架构(如 Transformer + 相对位置编码)虽灵活,但位置编码通常只在欧氏空间定义,无法直接表达 Minkowski 时空的几何结构。
- 常用的 RoPE/ALiBi 等相对位置编码仅处理单维度或欧氏距离,缺乏对时空位移的 Lorentz 不变性设计,导致模型对全局坐标系平移敏感,且未显式编码时空耦合。
为什么这个问题难且重要
技术难点在于:时空坐标位于 Minkowski 空间而非欧氏空间,需要保证位置编码在 Lorentz 变换下保持物理一致性;同时注意力机制要求位置编码以 query/key 偏置形式注入,且必须兼容 FlashAttention 等高效实现。业界对多尺度物理智能的关注持续上升,涵盖分子模拟、天气预报、自动驾驶视频预测等领域,亟需既保持几何先验又不牺牲学习能力的统一解法。
行业类比
这类似于 AlphaFold 在蛋白质结构预测中引入等变几何约束:不放弃深度学习的灵活性,而是注入恰当的几何归纳偏置,从而在参数效率和精度上同时获益。
核心洞察
- MinkowskiPE 的核心是将位置编码建立在 Minkowski 时空的 Lorentz 变换之上,使注意力分数仅依赖相对时空位移,天然具备全局平移不变性。不同于 RoPE 等欧几里得旋转编码,Lorentz 变换包含双曲旋转(boost),能同时混合时间与空间坐标,从而在数学上显式建模时空耦合,而无需分别设计时间和位置编码后再拼接。
- 该方法在物理先验与纯学习之间找到了一个平衡点:通过几何偏置提供强时空归纳,但不限制动力学形式。相比哈密顿网络等物理驱动模型,它不强制守恒律或运动方程;相比普通 Transformer,它用显式几何结构替代隐式学习时空关系,降低了模型对数据量的依赖,并提升了跨尺度任务的泛化能力。
- 实验结果表明几何编码可以替代大量参数化学习:在 KTH 视频预测上,MinkowskiPE 以约十分之一的参数量将 MSE 降低 9.9%,说明时空不变性编码本身就能捕获关键动态特征。这提示在设计轻量化时空模型时,优先考虑几何对称性注入可能比堆叠更多层更有效。
方法
输入与表示
模型接收时空序列 token,每个 token 携带联合坐标 (t, x)(时间与空间位置),例如分子动力学中的原子轨迹片段或视频中的时空 patch。
关键模块:Minkowski Positional Encoding
- 对 query 和 key 特征分别应用由 token 坐标参数化的 Lorentz 变换。该变换属于 Minkowski 几何下的等距群,保持时空间隔不变。
- 经变换后,注意力分数 query 与 key 的内积只依赖于 token i 和 j 之间的相对时空位移,与全局坐标平移无关。
- 实现上,保留标准 dot-product attention 接口:将 Lorentz 变换嵌入 query/key 的线性投影中,无需修改注意力计算核心,因此兼容 FlashAttention 等高效实现。
输出与训练
输出为融合了显式时空几何偏置的注意力分数,用于下游预测(分子轨迹或视频帧)。训练目标与原始任务一致,未引入额外约束。
与同类方法的差异
相比 RoPE 等仅在空间或时间维度单独编码相对位置的方法,MinkowskiPE 通过 Lorentz 变换显式建模时空耦合,同时保持平移不变性,且在参数效率和计算开销上更具优势。
实验
实验设计
MinkowskiPE 在两个尺度验证有效性:微观分子动力学预测(9 个多轨迹评估基准)与宏观视频预测(KTH 数据集)。方法将 MinkowskiPE 作为位置编码插入标准 Transformer 注意力,与三类基线对比:物理驱动模型(如神经常微分方程)、纯学习架构(如 ViT、Video Transformer)、以及已有相对位置编码变体。
关键发现
- 分子动力学:在所有 9 个多轨迹评估上取得最佳结果,验证了显式时空耦合先验对微观物理系统建模的增益。
- 视频预测:在 KTH 上 MSE 降低 9.9%(相对最佳基线),且参数量仅约 1/10,说明几何偏置不仅提升精度,还大幅降低模型复杂度。
- 机制:注意力分数仅依赖 token 间的相对时空位移(Lorentz 不变间隔),具备全局平移不变性,避免绝对坐标过拟合。
与基线对比的深度解读
物理驱动模型先验强但灵活性受限,纯学习模型灵活但时空耦合隐式。MinkowskiPE 通过参数化 Lorentz 变换作用于 query/key 特征,将几何结构注入注意力,既保持标准点积接口,又兼容 FlashAttention 等高效实现。工程上,开发者无需改动模型主体或推理框架,只需替换位置编码层即可获得时空一致性的提升。其参数效率优势(约 1/10)对边缘部署或大规模预训练尤其有价值,因为可在同等算力下训练更深或更宽的模型,或降低推理延迟。
行业影响
落地场景
MinkowskiPE 的 Lorentz 变换 显式编码时空耦合,适用于需要联合建模时间和空间的工业场景:
- 内容平台:视频帧预测、动作识别、视频内容理解,可提升推荐与搜索的特征质量。
- 自动驾驶:车辆轨迹预测、多帧点云/图像时序建模,增强对动态场景的鲁棒性。
- 科学计算与药物研发:分子动力学模拟加速,用于材料科学、蛋白质动力学,降低试错成本。
- 气象/环境预测:时空序列预测,如降水、污染物扩散。
商业价值
- 降本:在视频预测任务中参数量仅为最优基线约 1/10,同时 MSE 降低 9.9%,模型小型化可显著减少推理算力与部署成本。
- 提升精度:在 9 项分子动力学多轨迹评测中全部最佳,表明对物理规律的表征能力更强,可提升下游预测准确性,减少实验浪费。
- 模型泛化:全局平移不变性 使模型对坐标原点不敏感,更容易迁移到不同场景和坐标系。
跟现有产品/工作流的接口
MinkowskiPE 保持标准 dot-product attention 接口,可作为即插即用的位置编码模块嵌入现有 Transformer 架构(如 ViT、Video Transformer、Graphormer)。集成方式:
- 替换现有位置编码(如 RoPE、ALiBi)为 MinkowskiPE,无需改动 attention 实现。
- 与高效 attention 实现(如 FlashAttention)兼容,无需额外工程适配。
- 对输入 token 的时空坐标要求低,只需提供
(t, x, y, z)坐标即可。
具体 use case:
- 电商视频理解:采用 MinkowskiPE 的 Video Transformer 可更准确识别商品动作和时序变化,提升视频搜索和推荐的相关性。
- 自动驾驶数据闭环:用其替换轨迹预测模型的位置编码,可降低模型参数量并提高长时序预测精度。
局限
- - **依赖显式时空坐标**:MinkowskiPE 需要输入包含明确时间和空间坐标信息,适用于分子动力学和视频这类天然具有时空网格的数据。对于缺乏结构化时空坐标的通用序列(如自然语言、图数据),需要额外引入坐标假设,可能引入偏差。论文仅在两个领域验证,未展示跨模态泛化能力,通用性受限。
- - **评估规模与基线有限**:视频预测仅采用 KTH 数据集,动作类别简单且背景纯净,难以代表真实动态场景。分子动力学系统规模相对较小。与最新时空 Transformer 基线(如 VideoMAE、Swin3D)对比不足,且缺乏大规模预训练模型对照,难以判断方法在复杂环境下的实际增益。
- - **高维扩展性未充分论证**:虽然保留标准 dot-product attention 接口,但 MinkowskiPE 需要为每层学习 Lorentz 变换参数,高维表示的设计和计算开销未详细分析。论文未讨论长序列或高维时空下的内存占用与训练效率,实际部署时额外参数可能抵消参数量优势,需进一步优化。