面向 3D 场景交互理解的几何与语义耦合
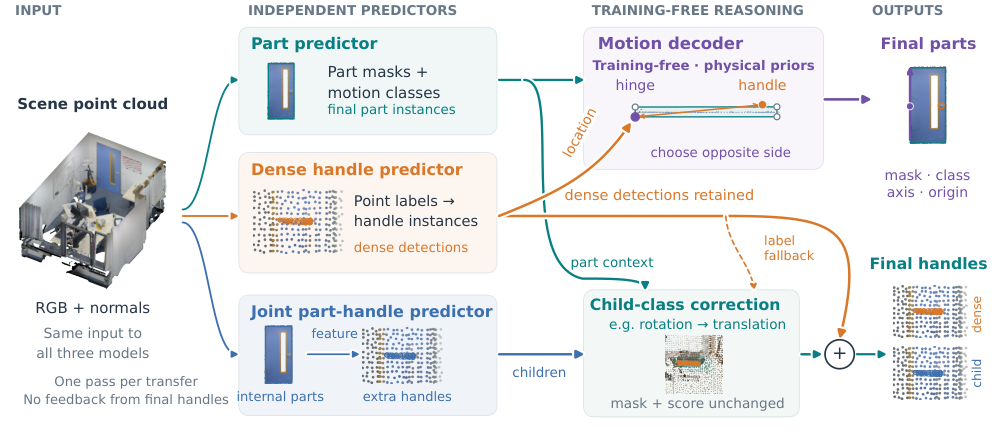
在 3D 场景中理解交互,需要同时描述可动部件、其运动方式以及可操作区域。本文提出 Segment-Snap,通过部件与把手(handle)之间的物理关系把上述输出联系起来。 方法上分为两个方向的信息传递: 1. 学习到的预测器先识别大范围的部件表面与细小的 handle,几何解码器 借助平面与竖直先验约束运动,再依据预测的 handle 位置选取铰链线,无需训练运动回归器。 2. 联合的部件-把手预测器提供额外 handle 候选,其运动类别再利用所属部件进行修正。每种信息传递只施加一次,不进行迭代反馈。 在 Articulate3D 验证集上,固定掩码与轴时,handle 引导将运动门控 AP 从 13.74% 提升到 40.98%;额外 handle 候选把 handle AP 从 24.63% 提升到 29.65%,基于部件的类别修正再增 0.98 个点,完整上下文达到 30.99%。重复训练、学习型解码器对照实验与配对可视化,共同说明了结合几何与语义证据用于交互理解的优势与局限。
论文精读
TL;DR Segment-Snap 通过部件-手柄几何/语义耦合,在无运动回归训练下,利用手柄位置解析铰链线,将运动 AP 从 13.74% 提升至 40.98%,并用部件上下文把手柄 AP 提升至 30.99%。
问题
问题背景:3D 场景交互理解要求同时解析可移动部件、运动方式与操作把手,是具身智能与机器人操作的关键前置任务。
现有方法局限:主流方法将部件分割、运动估计与把手检测割裂处理,缺乏跨任务信息传递。运动估计常训练专用回归器,需要大量运动标注,且对未见几何形态泛化差。把手与部件之间的物理依存关系未显式建模,导致运动轴选择歧义、把手漏检。
为什么难/重要:挑战在于几何先验(平面、直立、铰链线)与语义线索(部件类别、把手位置)的有效融合。单一视觉线索不足:把手小且易遮挡,运动轴需要部件形状上下文才能确定。业界对此高度关注,因为机器人需要理解物体如何被操作,AR/VR 需要可交互场景重建。
行业类比:类似自动驾驶中,车道线检测与交通标志识别必须共享上下文才能应对遮挡和歧义,而非各自独立推理。
核心洞察
- 训练无需 motion regressor 的几何解码器,利用 handle 位置与几何先验选择铰链,大幅提升运动推断精度且增强泛化。与直接回归铰链参数的常见方法不同,Segment-Snap 通过 planar / upright 先验约束运动,再依据预测的 handle 位置确定铰链侧,避免了昂贵的运动参数回归学习。在 Articulate3D 验证集上,仅加入 handle guidance 就将 motion-gated AP 从 13.74% 提升至 40.98%,证明几何推理与 handle 线索的耦合可替代数据驱动的运动回归,在标注有限时更具鲁棒性。
- 单向一次性信息传递设计(handle→part 与 part→handle 各一次)避免迭代反馈,在提高性能的同时保持推理简洁高效。与迭代优化或循环消息传递方案不同,模型将 handle 用于运动解码,将 part 用于 handle 候选补全与类别修正,但每个方向只应用一次,无反馈闭环。实验表明这种受控的单向耦合带来 handle AP 从 24.63% 到 30.99% 的稳定提升,且推理流程无迭代开销,适合实时或大规模场景理解,同时避免了迭代不稳定与过拟合风险。
方法
输入与感知
输入静态 RGB 场景,Segment-Snap 的学习预测器同时输出两类实例:一类是宽泛的可移动部件表面,另一类是小型的手柄区域。此外,一个联合 part-handle 预测器内部利用部件特征产生补充的手柄候选。
几何运动解码(handles → parts)
运动参数不依赖训练回归器。几何解码器先施加平面与竖直先验约束运动空间,再根据预测的手柄位置选择铰链线:手柄所在位置指示相反侧的铰链边,从而消解旋转轴歧义。该过程完全训练无关,仅使用几何规则。
互补提议与语义修正(parts → handles)
联合预测器生成的额外手柄候选与独立预测结果合并,并通过所属部件的运动类别对候选手柄的运动类型进行上下文修正。部件提供包围几何信息,帮助剔除误检并纠正标签。
输出
最终输出可移动部件、其运动参数(铰链轴与方向)以及操作手柄实例。
与同类方法的差异
与训练专用运动回归器的现有方法不同,Segment-Snap 用几何先验和语义耦合实现一次性推理,无迭代反馈,信息传递方向明确且可解释。
实验
实验设计
在 Articulate3D 验证集上,采用固定 mask 和 axes 评估 motion-gated AP;通过 handle 引导几何解码 替代训练运动回归器,利用平面与竖直先验约束运动,并依据手柄位置选择铰链侧。同时,联合 part-handle 预测器 提供额外手柄候选,部件类别校正改善手柄标签。信息传递仅一次,无迭代反馈。
关键发现
- 手柄位置显著解决铰链歧义:motion-gated AP 从 13.74% 提升至 40.98%(+27.25 点)。
- 额外手柄候选将 handle AP 从 24.63% 提升到 29.65%(+5.02 点)。
- 部件类别校正额外增加 0.98 点,完整上下文最终达到 30.99%。
- 联合预测器的内部部件特征可自主提出额外手柄,体现语义与几何的互补。
与基线对比解读
相比训练运动回归器的基线,本方法不训练回归器,仅用几何解码器和手柄引导即可恢复运动,降低参数量与训练成本,且可解释性强。单向信息流设计避免了迭代反馈的复杂性,推理高效。但提升依赖手柄与部件预测质量,在遮挡或小部件场景下可能受限。工程上启示:可引入结构化先验(平面/竖直/手柄)替代部分监督学习任务,在标注稀缺时提升稳定性;同时,联合预测器共享特征可产生互补提议,值得在多任务感知中探索。
行业影响
落地场景
Segment-Snap 面向 3D 交互理解,核心输出包括可动部件实例、运动轴(铰链线)和操作手柄。这直接赋能以下真实场景:
- 机器人操作:在仓储分拣或家庭服务机器人中,识别抽屉、门、盖子等可动部件及手柄位置,指导机械臂以正确方式施力。无需额外运动回归器,可快速部署到新物体类别。
- 电商 3D 商品展示:在线零售平台引入可交互 3D 模型(如家具、家电),用户可拖拽查看开合状态。Segment-Snap 可从商品扫描数据中自动恢复部件运动和手柄,减少人工建模成本。
- AR/VR 场景理解:移动端 AR 应用扫描房间后,自动识别可开合的柜门或抽屉,并在手柄处渲染交互提示,提升用户体验。
商业价值
主要降本线 + 体验提升线:
- 降本:传统 3D 资产标注可动部件需大量人工,Segment-Snap 以训练自由(training-free)的几何解码器替代运动回归器,降低标注和模型训练成本。相关实验显示手柄引导将
motion-gated AP提升 27.25 个百分点,说明少量手柄标注即可大幅提升部件运动预测准确性,减少数据需求。 - 体验提升:在电商、AR 应用中,精确的部件运动和手柄识别使用户能自然交互,提高商品详情页停留时长与转化率。机器人操作中,手柄引导减少了错误抓取,提升任务成功率。
与现有产品/工作流的接口
集成方式轻量:
- 输入:支持静态 RGB 或 RGB-D 场景,可作为现有 3D 感知 pipeline 的前端插件。
- 输出:部件实例 mask、铰链轴参数、手柄实例及运动类别,可直接对接下游任务:
- 机器人抓取规划(如 MoveIt)读取手柄位置生成抓取姿态。
- 物理仿真引擎(如 MuJoCo)利用运动轴初始化关节配置。
- 3D 内容平台将结果导入 Blender 或 Unity 进行交互展示。
- 部署:单次前向推理,无迭代反馈,延迟低;训练成本低(无需运动回归器),适合边缘设备或云端 API。
论文指出:“Each transfer runs once, with no feedback from final handles to motion”,强调了低延迟、高效的设计。
局限
- - **几何先验的适用性有限**:运动解码依赖平面和直立(upright)先验来约束运动并选择铰链线。对于旋转轴不垂直、存在复合运动(如抽屉滑动+旋转)或非平面部件的场景,该先验可能失效,导致运动方向错误或无法解码。论文虽报告了在 Articulate3D 上的大幅提升,但该数据集中多数物体(如门、抽屉)符合这些先验,未覆盖更复杂的真实交互,泛化性存疑。
- - **单向信息流缺乏反馈修正**:方法设计为“手柄→运动”和“部件→手柄”各一次传递,无迭代循环。若手柄检测置信度低或部件分割错误,初始误差会沿信息流传播且无法被后续模块纠正。例如,手柄位置错误会导致铰链侧选择错误,而运动结果不会反向修正手柄。虽然作者强调这样避免迭代开销,但牺牲了复杂场景下的鲁棒性。
- - **评估协议与实际部署有差距**:主要指标 motion-gated AP 是在“固定 masks 和 axes”条件下计算的,即假设部件分割和运动轴已知,仅评估运动方向预测。这剥离了分割和轴估计的联合误差,可能高估系统的端到端性能。此外,仅在 Articulate3D 验证集上测试,缺乏跨数据集或真实场景的泛化验证,难以判断实际应用价值。