RULER:面向 SVG 生成的实例感知评分细则奖励
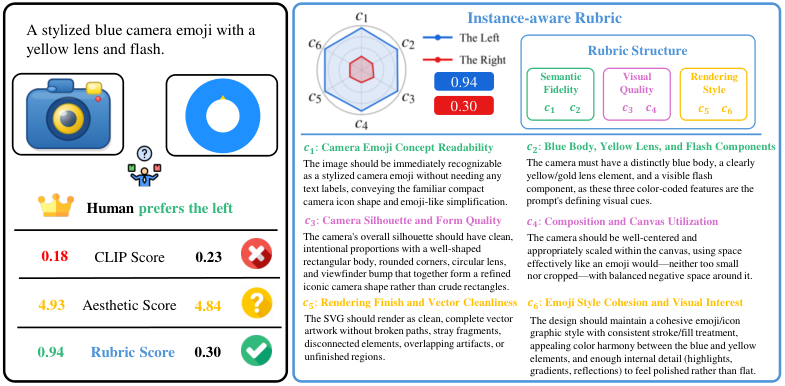
从自然语言指令生成 Scalable Vector Graphics(SVG)代码是开放式任务,缺乏绝对的视觉真值,使评估与策略优化都缺少可靠信号。在自然图像上校准的标量指标(如 CLIP、Aesthetic)难以迁移到风格化矢量内容,直接用作 RL 奖励还会诱发 reward hacking。针对这两点,我们采用基于 rubric 的评分。 我们首先通过实验证明:用多轴 rubric 提示视觉语言评判模型(judge VLM),其打分与人类判断的相关性远高于标量指标,且这一优势在样本之间与同一指令内部都成立。基于此,我们提出 RULER(Instance-aware Rubric Rewards for Reinforcement Learning):它将每条指令转换为覆盖语义、视觉与风格三类维度的六条目实例感知 rubric,由 judge VLM 对渲染后的 rollout 逐项打分,加权满足度构成细粒度奖励,并通过 Group Relative Policy Optimization 优化。由于 rubric 完全由文本推导,RULER 既不需要配对的 SVG 真值,也不需要人类偏好标注。 在 MMSVG-Illustration 与 MMSVG-Icon 上,RULER 将 rubric 分数从 0.432/0.395 提升到 0.693/0.683,超过专门的 SVG 专家模型,并与规模大得多的 DeepSeek-V3 相当。消融实验表明,rubric 设计是开放式 SVG 生成中 RL 的有效抓手。项目主页见 https://hangyuran.github.io/RULER/ 。
论文精读
TL;DR RULER 将文本指令自动展开为六项实例感知的评分标准,驱动 VLM 逐项打分作为细粒度奖励,让 SVG 生成模型在无 ground truth 下通过 RL 显著提升质量,评分从约 0.43 提升至 0.69。
问题
问题背景
SVG 代码生成是典型的开放式 text-to-code 任务,输出为矢量图形代码而非像素,缺乏绝对视觉真值,导致评估信号和策略优化目标都不可靠。
现有方法局限
常用标量指标 CLIP Score 和 Aesthetic Score 在自然图像上校准,迁移到风格化矢量内容(插画、图标)时与人类判断相关性显著下降。这些指标只能给出单一标量,无法区分同一指令下不同维度(语义、视觉、风格)的优劣。将其直接复用为 RL 奖励会诱发 reward hacking:模型倾向于生成能骗过指标但语义偏离或视觉低质的 SVG,例如简单放大对象以提高 CLIP 相似度,忽略构图合理性。
为什么这个问题难 / 重要
- 评估粒度缺失:开放任务中每个指令的评价标准不同,固定指标无法覆盖实例级别的细粒度要求。
- 奖励信号瓶颈:RLHF / RLAIF 在生成模型对齐中已是主流,但奖励信号的可信度直接决定策略是否走偏;SVG 作为结构化图形表示,在 UI、图标、插画等实际生成场景中需求明确。
- 无 ground truth 约束:没有配对的 SVG 真值或人类偏好标签,必须从文本指令本身构建可靠的奖励机制,技术挑战在于如何自动生成实例感知的多维 rubric 并加权融合。
行业类比
类似代码生成中,仅用单元测试作为奖励会因覆盖不足和过拟合而失效,引入人类评审 rubric(正确性、可读性、效率等)能更全面引导模型行为。
核心洞察
- 实例感知的 rubric 奖励取代标量指标,解决了 SVG 等开放生成任务中奖励信号不可靠和 reward hacking 问题。RULER 将每个 instruction 转换为包含语义、视觉、风格六个条目的 instance-aware rubric,用 VLM judge 逐项打分并加权求和作为细粒度 reward。与直接使用 CLIP、Aesthetic 标量指标(在矢量内容上迁移差、易被游戏化)相比,rubric 提供多维度、可解释的信号,且无需配对 ground truth 或人类偏好标签,降低了数据门槛。
- 实验表明,多轴 rubric 的 VLM judge 与人类判断相关性远高于标量指标,这为无 ground truth 生成任务的评估和优化提供了新基准。以往工作或依赖标量指标导致评估偏差,或需大量人类偏好数据训练 reward model;RULER 仅用现成 VLM 和文本生成的 rubric 即可获得高相关性,并在 RL 后大幅提升 rubric score,超越专用 SVG 模型,说明评估信号的质量直接决定策略优化的上限。
方法
输入与整体流程
RULER 接收自然语言指令(如“绘制扁平风格猫图标”),不依赖成对 SVG ground truth 或人类偏好标注。策略模型根据指令生成 SVG 代码,渲染为图像后进入奖励计算。
关键模块
- Instance-aware rubric generation:从文本指令动态生成六个评分项,覆盖语义轴(对象存在、属性正确)、视觉轴(轮廓清晰、渲染质量)和风格轴(风格匹配、美观度)。与固定 universal rubric 不同,每个指令对应专属评分标准。
- Judge VLM scoring:使用视觉语言模型作为评判器,对渲染出的 SVG 图像逐项打分,得到每个 rubric 项的满意度分数。
- Reward calculation:将各项满意度加权求和,形成细粒度奖励信号。权重来源于 rubric 设计,消融实验表明该设计是 RL 提升的关键。
- Policy optimization:采用 Group Relative Policy Optimization (GRPO),在同一指令下采样多个 rollout,利用组内相对优势更新策略,降低绝对奖励方差。
输出与效果
优化后的策略在 MMSVG-Illustration 和 MMSVG-Icon 上将 rubric score 从 0.432/0.395 提升至 0.693/0.683,超过了专用 SVG 模型,并匹配了更大的 DeepSeek-V3。
与同类方法的差异
相比直接用 CLIP、Aesthetic 等标量指标作为 RL 奖励容易触发 reward hacking,RULER 将文本派生、实例感知的 rubric 作为奖励信号,无需视觉 ground truth,通过 VLM 细粒度评分更贴近人类判断。
实验
实验设计:在 MMSVG-Illustration 和 MMSVG-Icon 两个基准上评测。RULER 将每条指令转化为六项实例感知 rubric(覆盖语义、视觉、风格轴),由 VLM judge 对渲染结果逐项打分,加权 satisfaction 作为奖励,通过 Group Relative Policy Optimization (GRPO) 优化策略。基线包括专用 SVG 生成模型与更大的 DeepSeek-V3,并引入人类偏好评估。
关键发现:RULER 将 rubric score 从 0.432/0.395 提升至 0.693/0.683,超越专用 SVG specialists 并匹配 DeepSeek-V3。消融实验表明,rubric 设计是 RL 有效性的关键杠杆;采用通用 rubric 虽稳定提升但缺乏实例粒度,而传统标量指标(CLIP/Aesthetic)作为奖励会迅速导致 reward hacking。
基线对比解读:传统标量奖励在风格化矢量内容上失准,引发 reward hacking;RULER 的实例感知 rubric 提供了细粒度、与人类判断对齐的信号,避免了该问题。相比需要配对 ground truth 或人类偏好标签的方法,RULER 仅从文本生成 rubric,数据成本极低,同时在与更大规模模型对比时仍具竞争力。
行业影响
落地场景
RULER 可直接赋能文本到 SVG 生成产品,覆盖 UI 图标、营销插画、信息图表等矢量设计需求。典型场景包括:
- 电商平台:根据商品描述自动生成风格统一的促销图标或定制插画,适配不同尺寸与主题。
- 内容平台:为创作者提供从自然语言到可编辑矢量封面、配图的生成能力,支持后续微调。
- 企业设计系统:自动产出符合品牌规范的 SVG 组件,减少设计师重复劳动。
商业价值
核心价值在降低人工设计成本与提升生成质量一致性。标量指标(CLIP、Aesthetic)在矢量风格上易被 reward hacking,而 RULER 的实例化 rubric 奖励更贴近人类判断,可显著减少返工。实测将 rubric 分数从 0.432/0.395 提升至 0.693/0.683,意味着生成结果更符合指令语义、视觉与风格要求。对于需要大规模个性化视觉内容的业务,该方案可节省大量标注与人工审核成本,同时提高用户满意度与转化率。
与现有工作流接口
RULER 可无缝集成到现有 SVG 生成 pipeline 的强化学习微调阶段:
- 使用 LLM 从用户指令生成实例感知的六项 rubric(文本侧,无需配对 ground truth)。
- 渲染模型 rollout 结果,由 VLM judge 逐项打分,加权得到奖励。
- 通过 GRPO 优化策略模型。 无需人类偏好标签,降低数据准备门槛。可直接替换现有 RLHF 中的奖励模型,或作为辅助 reward 与标量指标加权,提升整体优化稳定性。适合嵌入已有 LLM 或专用 SVG 模型(如 SVG specialist)的训练栈。
关键差异:与依赖标量反馈的方法相比,rubric 奖励在开放任务上抗 reward hacking 能力更强,且评估与训练信号一致,工业落地更可靠。
局限
- **依赖 VLM 评判器的能力与偏见**。RULER 的 rubric 生成和评分都依赖同一个 vision-language judge,其视觉理解能力直接影响奖励信号质量。虽然实验显示与人类判断相关性高于 scalar 指标,但 VLM 对矢量图形(如路径平滑度、细节丰富度)的感知可能与人类存在偏差,且可能继承训练数据中的风格偏好,导致奖励误导。论文未系统分析评判器在不同 SVG 风格上的误差模式,也未提供针对评判器失效的缓解策略,这限制了方法在更复杂或非典型指令上的可靠性。
- **实例感知 rubric 的生成开销与泛化风险**。每个指令都需要调用 VLM 生成六项 rubric,相比固定 scalar 奖励增加了推理成本;论文虽然提及 cost,但未与 universal rubric 或固定奖励进行详细开销对比。此外,rubric 质量高度依赖 prompt 设计和 VLM 生成能力,对于稀有或高度创意指令,生成的 rubric 可能不够精确,导致奖励噪声。实验仅在 MMSVG-Illustration 和 MMSVG-Icon 两个数据集上验证,扩展到其他开放生成任务(如布局生成、场景图)的可行性尚未证明。
- **未直接利用人类偏好标签,上限可能受限于 rubric 设计**。RULER 使用 VLM 生成的 rubric 作为奖励代理,虽然避免了人工标注,但最终优化目标仍是一个代理指标,与直接基于人类反馈的 RLHF 相比可能存在奖励分布偏移。另外,在 MMSVG 上 RULER 只是匹配 DeepSeek-V3,并未显著超越,说明在模型规模增大时 rubric 奖励的增益可能减小,方法对更强基座模型的提升空间有限。