Ovis-Embedding: 推动通用全模态嵌入的前沿
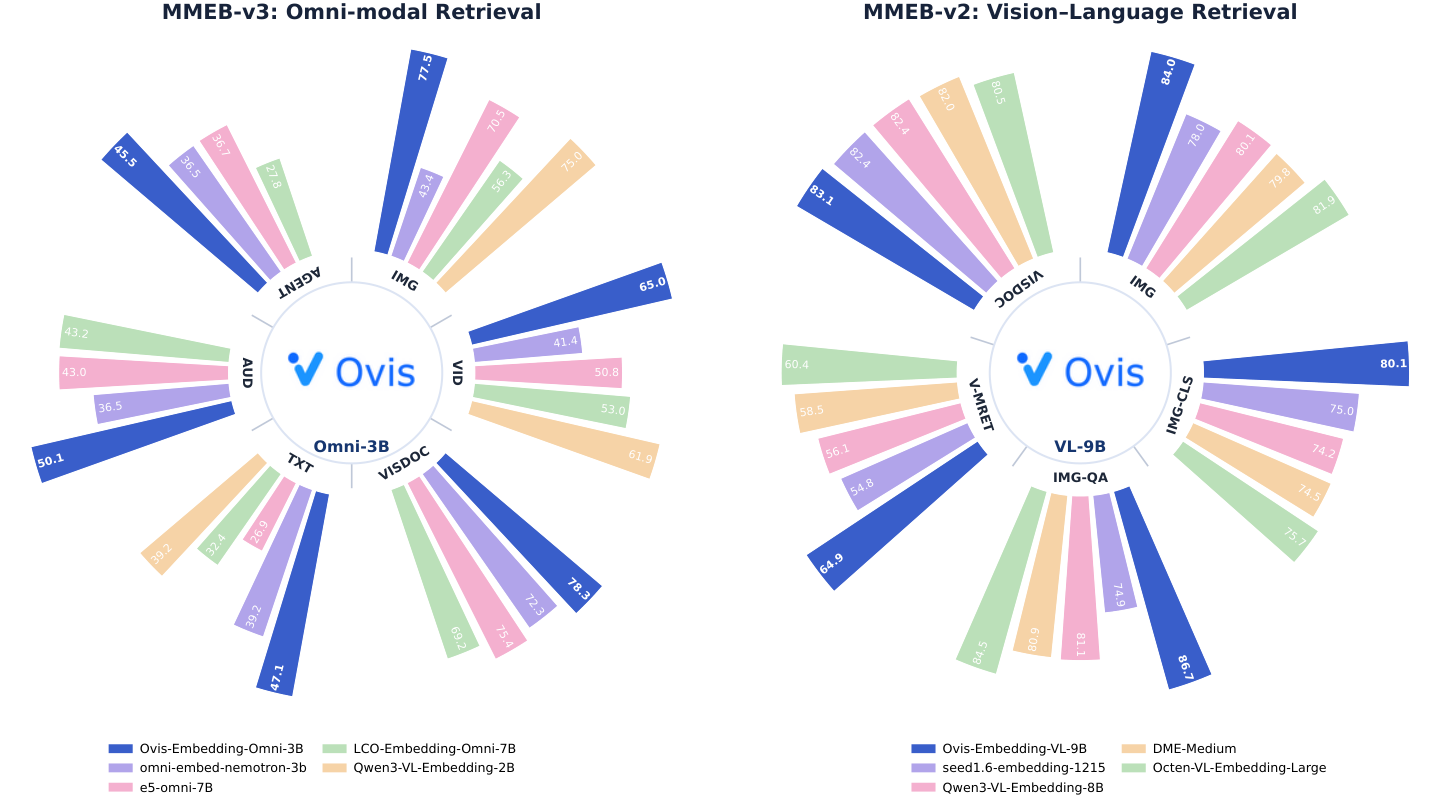
本报告介绍 Ovis-Embedding,一个通过原生整合文本、图像、视频与音频构建的 SOTA 全模态嵌入模型 系列。不同于拼接独立模态塔的做法,它采用共享的多模态主干,将不同模态编码到统一的表示空间。其核心包含三项进展: 1. 原生全模态初始化:以预训练的 Qwen-omni 模型作为嵌入主干,并通过低秩初始化与对比训练进行适配; 2. 数据中心化的全模态训练:构建覆盖文本、图像、视频、音频及交错多模态数据的高质量语料,并引入同源采样(homogeneous-source sampling)形成任务一致的批次,以获得信息量充足的批内负样本; 3. 面向嵌入的训练与推理优化:使用 focal loss 强化困难样本,并通过基于相似度的 Embedding Distillation 从互补专家模型迁移细粒度相似度结构。 推理阶段,低秩特征分解 使嵌入更加紧凑,支持灵活维度且性能损失极小。实验表明,Ovis-Embedding 系列在 MMEB-v3、MMEB-v2、MVEB、MAEB 与 RTEB 上均取得 SOTA 表现,验证了其在文本、图像、视频与音频模态上的有效性。这些结果凸显了统一全模态训练在克服模态割裂、推进任意到任意检索的通用嵌入模型方面的潜力。
论文精读
TL;DR Ovis-Embedding 基于 Qwen-omni 统一多模态骨干,原生融合文本/图像/视频/音频,通过同源采样与嵌入蒸馏等优化,在 MMEB-v3 等基准取得 SOTA,实现任意模态检索。
问题
问题背景
多模态嵌入检索正从单模态或双模态向真正的全模态(text, image, video, audio)统一空间演进,以支持任意到任意检索。
现有方法局限
当前主流方案多采用 独立模态塔(separate modality towers)分别编码不同模态,然后在联合空间做对齐。这带来三个具体缺陷:
- 表示空间不一致:各塔独立预训练,跨模态语义对齐依赖额外对比学习或映射层,导致任何模态间检索性能不平衡。
- 数据混合低效:多模态训练数据随机打散时,batch 内负样本往往来自不同任务源,难以形成有效的难负例,浪费对比学习信号。
- 推理与存储压力:嵌入维度固定且偏高,不利于大规模检索场景下的向量库存储与相似度计算。
为什么这个问题难/重要
统一 原生 omni-modal backbone 需要处理异构输入(时序音频/视频、空间图像、离散文本)的序列建模与注意力对齐,同时避免跨模态灾难性遗忘。数据侧要构造高质量、任务一致的同源 batch 以最大化 in-batch negatives 的信息量。业界对通用嵌入模型的需求正从 独立双编码器 转向 单一共享骨干,因为后者能天然保持跨模态语义一致性,减少训练与部署的工程复杂度,是构建 any-to-any 检索基础设施的关键。
行业类比
类似从微服务各自维护状态到统一数据平面:前者灵活但需额外同步协议,后者牺牲局部特化换得全局一致与更低运维成本。
核心洞察
- 原生全模态单一骨干替代分立模态塔,从源头消除模态碎片化。多数多模态嵌入模型为每个模态构建独立编码器再后期对齐,例如 CLIP 双塔或各模态独立 tower,导致跨模态对齐难度高、参数冗余。Ovis-Embedding 直接采用预训练 Qwen-omni 作为统一骨干,通过低秩初始化做对比训练,使文本、图像、视频、音频共享同一表示空间。这一路线与拼接不同预训练编码器的常见方案形成根本差异,能更自然地支撑 any-to-any 检索,并减少模态间特征映射的额外适配成本。
- 同源采样构造任务一致 batch,使 in-batch negatives 更具信息量。常规随机混合多模态数据会产生大量易区分或无意义的负样本,削弱对比学习的信号密度。论文提出 homogeneous-source sampling,按数据来源或任务类型组织 batch,让负样本来自同任务相关实体,从而提升训练效率和嵌入空间的判别性。该策略强调数据组织方式比单纯扩大语料规模更关键,为大规模多模态检索训练提供可复用的工程模式,尤其适合资源受限或数据噪声较高的场景。
方法
输入为多模态数据(文本、图像、视频、音频及交错模态)。关键模块:共享 Qwen-omni 作为统一 backbone,通过低秩初始化进行 contrastive 适配,避免独立模态塔。
训练分四阶段:
- Stage-1 Low-Rank Pretraining:采用 Focal-Weighted Contrastive Loss 强调困难负样本,联合 Embedding Distillation Loss 从互补专家迁移细粒度相似结构;配合 homogeneous-source sampling 构造任务一致 batch,提升 in-batch negatives 质量。
- Stage-2 Full-Parameter Homogeneous Finetuning:全参数微调,进一步对齐多模态表示。
- Stage-3 Annealing Embedding Distillation:退火式蒸馏,逐步减弱专家引导。
- Stage-4 Elastic Embedding Inference:通过低秩特征分解实现紧凑 embedding,支持灵活维度且性能损失小。
输出为统一表示空间中的 embedding,可直接用于 any-to-any 检索。与同类拼接多模态塔的方法不同,Ovis-Embedding 依靠单一共享 backbone 原生编码所有模态,消除模态碎片化,实现真正的 omni-modal 统一。
实验
实验设计
- 评估覆盖五项综合基准:MMEB-v3、MMEB-v2、MVEB、MAEB、RTEB,涵盖文本、图像、视频、音频及 agent 检索任务。
- 训练流程分为四个阶段:Stage-1 低秩预训练、Stage-2 全参数同源微调、Stage-3 蒸馏退火、Stage-4 弹性嵌入推理。
- 数据构造采用同源采样形成任务一致批次,增强批内负例的信息量;损失函数结合 Focal-Weighted Contrastive Loss 与 Similarity-based Embedding Distillation。
关键发现
- 在全部五项基准上均报告达到 state-of-the-art 性能,验证统一多模态骨干的表示能力。
- 弹性嵌入 通过低秩特征分解支持紧凑维度(如 128/256 维),模型性能损失极小,便于实际部署。
- 同源采样 提升数据效率,避免混合模态批次中的负例噪声,帮助模型学习更精细的跨模态对齐。
与基线对比解读
- 相比独立模态塔模型(例如 CLIP 式分离编码),Ovis-Embedding 共享骨干避免了模态表示割裂,更利于 any-to-any 检索的统一优化。
- 潜在风险是模态干扰,论文通过分阶段训练和同源批次缓解;实际工程中需权衡统一骨干的算力开销与模态覆盖需求。
- 由于报告未给出具体数值指标,无法定量对比提升幅度,但多项基准的 SOTA 声明暗示较既有 omni-modal 基线有系统性改进。
行业影响
落地场景
Ovis-Embedding 支持任意模态到任意模态 的统一检索与匹配,可直接应用于:
- 电商多模态搜索:用户上传图片或视频片段,结合文字描述检索商品,提升转化率。
- 内容平台推荐与审核:对视频、音频、图文做统一 embedding,实现跨模态关联推荐、版权去重与内容安全过滤。
- 企业知识库问答:将文档、会议录音、培训视频统一索引,支持自然语言跨模态查询。
商业价值
- 降本:单一 omni 模型替代多个单模态 embedding 模型,减少 GPU 资源、存储与运维复杂度;低秩分解支持弹性维度输出,可按需平衡精度与成本。
- 增收:跨模态检索精度提升直接带动电商点击转化、广告匹配效率;统一相似度空间可挖掘更多跨品类关联,增加交叉销售机会。
- 体验提升:消除模态割裂,实现“以图搜视频”“以语音搜文档”等无缝体验,增强用户粘性。
与现有工作流集成
- 向量数据库:将 Ovis-Embedding 输出接入 Milvus / FAISS 等,替换或补充现有 text/image embedding 服务。
- RAG 管道:作为多模态 retriever,嵌入 LangChain / LlamaIndex 等框架,支持混合模态知识检索。
- 微调适配:论文公开的同源采样、focal loss、Embedding Distillation 等训练策略,可作为企业私有数据微调的参考配方。
具体案例:跨国电商平台使用 Ovis-Embedding 统一商品图像、描述和用户评论的 embedding,实现“拍照+文字”精准找同款,减少多模型维护成本,同时提升长尾商品曝光。视频流媒体服务将其用于音视频片段的语义去重和关联推荐,降低版权风险并提高内容复用率。
局限
- 对预训练基座依赖度较高:Ovis-Embedding 直接采用 Qwen-omni 作为 embedding 骨干,其效果上限受限于该模型的多模态表示质量。若基座模型未覆盖某些特定模态或领域数据,嵌入质量可能下降;且更换基座需要重新验证低秩初始化和各阶段训练策略的适配性。工程上意味着该方案并非即插即用,迁移到其他多模态 LLM 的成本较高,扩展性受限。
- 数据工程复杂度与可复现性挑战:构建高质量多模态语料并设计 homogeneous-source sampling 需要大量人工调优,数据配比、同源采样规则、负样本挖掘等策略对最终性能影响显著。当引入新模态或新任务时,需要重新设计采样逻辑并验证负样本质量,维护成本高。论文未详细公开数据清洗流程和采样超参数,复现难度较大,工程团队难以直接借鉴。
- 评测覆盖面有限,真实部署性能存疑:实验集中在 MMEB-v3/v2、MVEB、MAEB、RTEB 等学术 benchmark 上,缺少大规模真实检索场景(如十亿级库、低延迟召回、在线更新)的验证。低秩特征分解虽提供紧凑表示,但实际压缩比与检索精度之间的权衡、索引构建开销、跨模态长尾分布等尚不明确,生产环境下的鲁棒性和效率仍有待检验。