RoboFollow: 揭开具身智能体中的指令跟随幻象
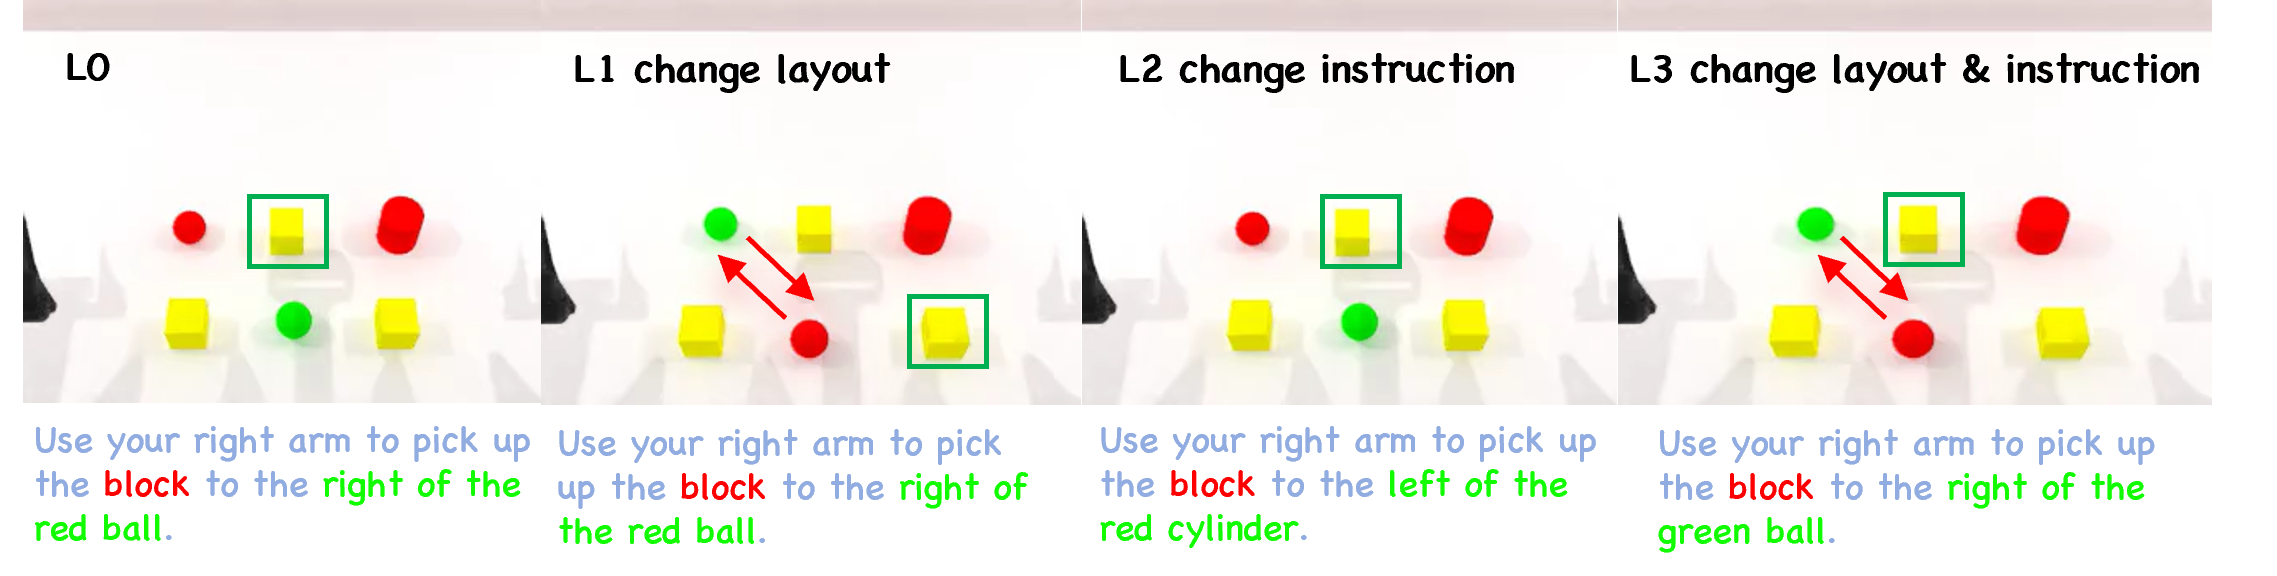
现代具身智能体虽取得亮眼成功率,但其真实的指令跟随能力远弱于这些数字所暗示的水平。我们将这一错觉归因于一种结构性属性——低场景熵(low scene entropy):当视觉场景只对应一个有效任务时,语言变得冗余,策略即便几乎不使用语言也能获得高分。 为此我们提出 RoboFollow,一个诊断基准,遵循三条原则: 1. 高场景熵:每个训练场景支持多个运动学上不同的任务分支,使仅凭视觉不足以完成任务,从而迫使策略依赖语言。 2. 分层诊断协议:四层协议(L0--L3)逐步扰动视觉布局与语义,检验等价指令是否产生一致行为、不同指令是否产生可区分行为,覆盖空间关系、属性、轨迹约束与逻辑。 3. 混淆受控诊断:简化交互对象、将动作限制在训练动作库内,并分阶段报告 Intent 与 Execution 分数,以将语言理解与运动执行分离。 对九个 VLA 与 WAM 策略的评估显示,即便在 L0 上表现强劲,在我们的微调设定下也无法可靠迁移到 L1--L3。代表性缓解手段,包括更强的 VLM 主干、QA 协同训练、LangForce 以及 Classifier-Free Guidance,均未能弥合这一差距。 RoboFollow 揭示出真正意义上的指令跟随是一个关键却被忽视的瓶颈。代码与数据集已开放在 https://github.com/AutoLab-SAI-SJTU/RoboFollow 与 https://huggingface.co/datasets/AutoLab-SJTU/robofollow-data。
论文精读
TL;DR RoboFollow 通过高场景熵与分层诊断,揭示现有 VLA/WAM 的指令跟随假象:L0 高分不代表 L1-L3 泛化,真实瓶颈尚未被现有方法解决。
问题
问题背景
具身智能领域,VLA 和 WAM 模型在标准操纵基准上成功率屡创新高,但指令跟随能力 是否真如指标所示仍存疑。
现有方法局限
现有评测常基于低场景熵 环境:视觉场景只对应一个有效任务,语言指令成为冗余信息。策略可通过纯视觉捷径获得高分,实际并未利用语言。例如,在固定布局下“抓红块”和“抓蓝块”可能因位置不同而无需理解颜色词。这导致成功率指标与真实指令跟随能力脱节,掩盖了模型的语言理解缺陷。
为什么难/重要
真正的指令跟随要求模型将语言语义映射到运动轨迹 层面的判别行为,需同时处理空间关系、属性、轨迹约束和逻辑等。高场景熵环境迫使模型依赖语言,但构建此类基准需要精细的场景设计和层次扰动,技术挑战大。业界对可靠指令跟随的需求迫切:家用服务机器人、工业协作臂等场景中,错误理解指令可能导致任务失败或安全风险,因此精准诊断与提升指令跟随能力成为关键瓶颈。
行业类比
类似自动驾驶中,车辆在简单封闭道路可能表现良好,但面对复杂交通标志和导航指令时可能误解,需专门测试集暴露指令跟随短板。
核心洞察
- 低场景熵 (low scene entropy) 是造成指令跟随假象的结构性原因。传统机器人操作基准通常只保证场景多样性,但每个固定场景下可执行任务单一,策略依靠视觉就能完成任务,语言信号被忽略。RoboFollow 通过构造高场景熵,使单一视觉观测对应多个运动学上不同的任务分支,从而强制策略必须依赖指令。这对工程评测的启示是:评估语言 grounding 能力时,必须控制场景熵,否则成功率指标会系统性高估实际指令跟随水平。
- 层级诊断协议 L0–L3 揭示策略的“意图理解-动作执行”鸿沟:在 L0 上取得高分的策略,微调后在 L1–L3 上普遍退化,说明其成功依赖视觉启发(如物体位置、颜色),而非真正的语义对齐。与以往只报告总体成功率的基准不同,RoboFollow 通过等价/非等价指令扰动视觉布局和语义,并分别报告 Intent 与 Execution 分,隔离了理解与执行两个环节。工程上这意味着需将阶段化指标纳入评测流程,单独优化末端执行不足以提升真正的指令跟随能力。
- 多种现有缓解手段(更强 VLM 骨干、QA 联合训练、LangForce、Classifier-Free Guidance)均无法弥合 L1–L3 间隙,这一负结果比单纯提出新模型更有价值。它表明当前 VLA/WAM 架构在语言条件化行为上存在系统性瓶颈,简单扩大模型或添加辅助训练不能解决深层语义对齐问题。工程启示是:需要从架构归纳偏置或训练范式(如更显式的语言条件分解、跨模态对比学习)入手,而不是依赖已有技巧的组合。
方法
输入与目标
RoboFollow 接收视觉场景、自然语言指令和待评估的 VLA/WAM 策略,输出分层诊断分数,用于量化策略的真实指令跟随能力。
关键设计模块
- 高场景熵场景构建:每个训练场景包含多个运动学上不同的任务分支(例如不同物体、空间位置、轨迹约束),视觉观察无法唯一确定任务,迫使策略必须解析语言信号。
- 层级诊断协议 L0–L3:L0 为标准指令跟随评估;L1–L3 逐步引入视觉布局与语义扰动,测试等效指令是否产生一致行为、不同指令是否产生可区分行为,覆盖空间关系、物体属性、轨迹约束和逻辑组合。
- 混淆控制与指标分解:简化交互物体、限制动作空间到训练分布,分别计算阶段性的
Intent和Execution分数,隔离语义理解误差与运动执行误差。
输出
策略在四个层级下的 Intent / Execution 分数,揭示从 L0 到 L1–L3 的性能下降模式,定位指令跟随瓶颈。
与同类基准相比,RoboFollow 不再默认低场景熵(视觉即可推断任务),而是通过高场景熵与分层扰动强制语言依赖,并显式拆分理解与执行两个维度。
实验
实验设计
RoboFollow 诊断基准围绕三个原则构建:High Scene Entropy 场景下每个训练场景支持多个运动学不同的任务分支,使纯视觉不足以完成任务;Hierarchical Diagnostic Protocol 通过 L0–L3 四级逐步扰动视觉布局与语义,检验等价指令行为一致性以及不同指令的判别性;Confound-Controlled Diagnosis 简化交互物体、限制动作空间,并分阶段报告 Intent 和 Execution 分数,以分离语言理解与运动执行。
关键发现
在微调设置下评估了 9 个 VLA 与 WAM 策略。结果显示,即便在 L0 上取得较强性能,该性能也无法可靠迁移到 L1–L3;语言指令跟随能力远低于任务成功率所暗示的水平。尝试的缓解方法——包括更强的 VLM 骨干、QA 协同训练、LangForce 和 Classifier-Free Guidance——均未缩小这一差距。
基线对比解读
与以往重视最终成功率的基准不同,RoboFollow 显式测量指令跟随的结构性瓶颈:低场景熵会使语言冗余,成功率虚高。该基准通过高场景熵迫使策略依赖语言,从而揭示当前策略在理解空间关系、属性、轨迹约束和逻辑指令时的脆弱性,为后续架构改进提供了更严格的诊断工具。
行业影响
落地场景
RoboFollow 揭示的“指令跟随假象”直接适用于具身智能场景:仓储分拣机器人、家庭服务机器人、医疗辅助机器人等。例如电商仓储中,视觉上相似的货架与箱子,指令“将红色箱子放到左侧传送带”与“将红色箱子放到右侧货架”要求不同行为;现有成功率指标可能掩盖模型是否真读了语言。高场景熵设计能暴露这类问题。
商业价值
采用 RoboFollow 风格诊断可减少错误执行成本:在物理世界误操作导致商品损坏、订单延误,比在仿真中提前发现代价低一个数量级。一次通过率提升直接降低人工远程接管与返工成本。对于机器人产品提供商,通过该基准证明模型指令跟随鲁棒性,可作为投标与验收的质量背书,加快客户采用。
与现有工作流接口
将 RoboFollow 作为模型发布前的评估门禁:在现有 VLA 训练流水线末尾,运行 L0–L3 分层测试,报告 Intent 与 Execution 两个分数,定位是视觉理解还是运动执行瓶颈。可与数据飞轮结合:对 L1–L3 失败的 case 自动生成新的高熵训练数据,加入下一轮微调。CI/CD 中集成该基准,每次模型迭代自动对比,防止指令跟随能力回退。虽然论文中 QA co-training、LangForce 等缓解措施未能完全闭合差距,但这些方法仍可作为诊断信号,指示模型在哪些层级需要额外监督。
局限
- **场景熵的简化定义**:论文将 `low scene entropy` 定义为场景中可执行任务数量少,但未纳入任务难度、语言歧义程度、物体语义多样性等因素。例如一个场景可能只有少量任务分支,但每个分支都涉及复杂的空间推理或长指令,低熵并不等同于简单。RoboFollow 通过移除干扰物、简化动作空间来控制混淆,但这也可能让场景熵的计算偏离真实环境的复杂性,导致基准的诊断结论可能不适用于高熵但高难度的真实任务。
- **微调设置的偏差**:所有九种 VLA/WAM 策略均在 RoboFollow 数据集上微调后才进行评估,这虽然隔离了指令理解与运动执行,但也可能掩盖预训练模型的真实能力。现实部署中,策略往往需要零样本或小样本适应新指令,而微调可能让模型过拟合于基准中的特定指令分布和物体外观。论文未报告零样本性能,因此无法判断模型本身是否已经具备鲁棒指令跟随,还是仅通过微调补偿了 VLM 的不足。
- **协议覆盖范围有限**:层次诊断协议 L0-L3 主要针对空间关系、属性、轨迹约束和简单逻辑,但真实世界的指令跟随还包括时间依赖(先 A 后 B)、条件否定、组合指令和常识推理等。RoboFollow 的物体集合和动作空间经过刻意缩减,无法覆盖长程任务或开放词汇指令,因此其结论可能只适用于简化场景下的视觉语言策略,不足以完全代表工业级具身智能的指令跟随瓶颈。与 ALFWorld、CALVIN 等基准相比,RoboFollow 的优势在于阶段评分和场景熵控制,但任务多样性与其相当或更少。